La historia del
reconocimiento de voz

El reconocimiento de voz se inventó en Bell Labs en 1952. Así pasó de diez dígitos hablados a 54+ idiomas, década a década.

El reconocimiento de voz de un vistazo

Invención
El reconocimiento de voz se inventó en 1952, cuando el sistema Audrey de Bell Labs reconoció los dígitos del 0 al 9 pronunciados por una sola voz.
Primer software de consumo
Dragon Dictate, lanzado en 1990 por unos 9,000 dólares, fue el primer producto de reconocimiento de voz vendido al público, y exigía una pausa después de cada palabra.
Primer vocabulario de 1,000 palabras
Harpy, de Carnegie Mellon, entendía 1,011 palabras en 1976, la meta que DARPA había fijado para su programa quinquenal Speech Understanding Research.
Paridad humana
En 2017 Microsoft midió una tasa de error de palabras del 5.1% en el benchmark telefónico Switchboard, igualando a los transcriptores profesionales que trabajaron las mismas llamadas.
Modelos abiertos
Whisper, de OpenAI, lanzado en septiembre de 2022, se entrenó con 680,000 horas de audio y transcribe casi 100 idiomas con pesos publicados.
Hoy
Sonix, fundada en 2017, transcribe 54+ idiomas con una precisión del 99% y devuelve un archivo de una hora en unos 5 a 6 minutos.

El reconocimiento de voz se inventó en 1952

El primer reconocedor de voz se construyó en Bell Labs en 1952 y entendía exactamente diez palabras: los dígitos del cero al nueve.

Audrey, el reconocedor automático de dígitos

K. H. Davis, R. Biddulph y S. Balashek construyeron Audrey con circuitos analógicos que llenaban un bastidor de relés de casi dos metros. El hablante decía un dígito por el auricular de un teléfono, la máquina medía los formantes de las vocales y se encendía una lámpara junto al dígito que había oído. Ajustada a las voces de sus diseñadores acertaba entre el 97 y el 99 por ciento; con desconocidos se venía abajo. Audrey nunca salió del laboratorio, porque salía más barato que una operadora marcara los números, pero zanjó la duda de si una máquina podía oír siquiera.

El Shoebox de IBM y los años 60

En 1962 IBM presentó Shoebox en la Feria Mundial de Seattle. Reconocía 16 palabras habladas, los diez dígitos y seis órdenes aritméticas, y con ellas manejaba una máquina de sumar. A lo largo de la década, laboratorios de Estados Unidos, Gran Bretaña, Japón y la Unión Soviética construyeron reconocedores de vocales, consonantes y listas cortas de palabras, y en 1968 Taras Vintsyuk describió el alineamiento temporal dinámico, el método que permitía a una máquina comparar habla pronunciada a distintas velocidades. En 1969 el campo tenía ambición pero no teoría: John Pierce, de Bell Labs, lo comparó con los planes para convertir agua en gasolina, y el laboratorio dejó de financiarlo durante años.

El programa Speech Understanding Research de DARPA llevó los vocabularios más allá de las 1,000 palabras

Entre 1971 y 1976 DARPA financió el mayor esfuerzo en reconocimiento de voz hasta la fecha, y Harpy, de Carnegie Mellon, alcanzó su meta de 1,000 palabras.

La meta a cinco años

El programa Speech Understanding Research pedía un sistema capaz de entender habla encadenada de varios hablantes con un vocabulario de 1,000 palabras y menos del 10 por ciento de error, y pagó a Carnegie Mellon, BBN, SRI y otros para que compitieran. Tres sistemas llegaron a la meta: Hearsay-II y Harpy, de Carnegie Mellon, y HWIM, de BBN. Harpy, terminado en 1976, entendía 1,011 palabras, más o menos el vocabulario de un niño de tres años, y fue el único que cumplió el objetivo. Su truco era una búsqueda que descartaba pronto las secuencias de palabras improbables en lugar de sopesar cada posibilidad, una idea que sigue siendo el núcleo de todo decodificador.

El giro estadístico

De esos mismos años salió la idea que se impuso a todas las demás durante los 40 años siguientes. En Carnegie Mellon, la tesis de James Baker de 1975 describía el sistema DRAGON, que trataba el habla como un modelo oculto de Márkov y dejaba que las probabilidades, y no reglas escritas a mano, decidieran qué palabras se habían dicho. En IBM, el grupo de Fred Jelinek incorporó el mismo enfoque a un sistema de dictado experimental y añadió modelos de lenguaje de n-gramas, de modo que el reconocedor podía adivinar la siguiente palabra a partir de las dos anteriores. Bell Labs, mientras tanto, pasó de una voz a muchas y construyó reconocedores que funcionaban con distintos hablantes, algo que las aplicaciones telefónicas exigían.

Los modelos ocultos de Márkov hicieron estadístico el reconocimiento de voz en los años 80

Los años 80 sustituyeron la comparación de patrones por la probabilidad, y los vocabularios pasaron de unos cientos de palabras a 20,000 en una década.

Cómo oye un modelo oculto de Márkov

Un modelo oculto de Márkov no intenta emparejar un sonido con una plantilla. Se pregunta qué secuencia de sonidos del habla produjo con mayor probabilidad el audio que recibió, y después qué secuencia de palabras produjo con mayor probabilidad esos sonidos. Las probabilidades se fijan entrenando con habla grabada, así que más datos significan un reconocedor mejor, una propiedad que importaría muchísimo cuando llegara internet. Combinado con modelos de lenguaje de n-gramas, el HMM se convirtió en la arquitectura estándar de todos los laboratorios de investigación y ahí se quedó hasta que el aprendizaje profundo lo desplazó en 2012.

Tangora, Sphinx y los primeros productos

Tangora, de IBM, reconocía un vocabulario de 20,000 palabras a mediados de los años 80, aunque necesitaba una pausa entre palabras y entrenarse con cada hablante. En 1988 el sistema Sphinx de Kai-Fu Lee, en Carnegie Mellon, fue el primero en combinar vocabulario amplio, habla continua e independencia del hablante en un solo reconocedor. Dragon Systems, fundada por James y Janet Baker en 1982, empezó a vender software de reconocimiento para computadoras personales. El reconocimiento de voz también llegó por primera vez a los consumidores: la muñeca Julie, de Worlds of Wonder, respondía a un puñado de frases habladas en 1987, y las compañías telefónicas probaron la marcación por voz. Los juguetes eran rudimentarios, pero metieron la expresión "reconocimiento de voz" en los hogares de la gente común.

Los años 90 llevaron el reconocimiento de voz a las computadoras personales

Procesadores más rápidos convirtieron el dictado de una demostración de laboratorio en software vendido en caja, y una prueba de referencia compartida facilitó medir el progreso.

De Dragon Dictate a NaturallySpeaking

Dragon Dictate salió a la venta en 1990 por unos 9,000 dólares. Fue el primer producto de reconocimiento de voz que cualquier persona podía comprar, y exigía una pausa después de cada palabra. En 1997 Dragon NaturallySpeaking eliminó la pausa: reconocía habla continua a unas 100 palabras por minuto en una computadora doméstica, e IBM respondió con ViaVoice ese mismo año. Por primera vez un abogado, un médico o un escritor podía hablarle a una computadora y obtener texto utilizable, siempre que lo entrenara y lo corrigiera.

Menús telefónicos y las primeras evaluaciones

En 1996 BellSouth lanzó VAL, un portal de voz al que se llamaba por teléfono y que respondía preguntas habladas; de él descienden todos los sistemas telefónicos automáticos con los que usted ha discutido desde entonces. Tras bambalinas, DARPA y el Instituto Nacional de Estándares y Tecnología (NIST) organizaban evaluaciones anuales sobre grabaciones compartidas como el corpus telefónico Switchboard, y la tasa de error de palabras se convirtió en la cifra que todos los laboratorios reportaban. A partir de ahí, la historia del reconocimiento de voz es en buena medida la historia de cómo fue bajando esa cifra.

Los años 2000 llevaron el reconocimiento de voz a la nube

La precisión se estancó cerca del 80 por ciento durante casi toda la década, hasta que Google sacó el reconocimiento del dispositivo y lo llevó a sus servidores.

La meseta

Hacia 2001 los mejores sistemas transcribían habla dictada con una precisión cercana al 80 por ciento, y los años siguientes trajeron retoques más que saltos. El dictado de escritorio siguió siendo un nicho, los menús telefónicos siguieron siendo frustrantes y el financiamiento de la investigación se redujo. El modelo oculto de Márkov estaba cerca de su techo, y los modelos que lo reemplazarían todavía no tenían la capacidad de cómputo ni los datos que necesitaban.

Google Voice Search

El servicio de directorio GOOG-411 de Google, lanzado en 2007, fue una forma de recopilar millones de consultas habladas. En noviembre de 2008 la empresa publicó Google Voice Search como aplicación para iPhone, y el reconocimiento de voz cambió de forma: el teléfono solo grababa, y el reconocimiento se ejecutaba en los centros de datos de Google con modelos mucho más grandes de lo que cualquier dispositivo podía albergar. El sistema en inglés de Google se entrenó con 230 mil millones de palabras de consultas de búsqueda, así que podía predecir lo que la gente tendía a decir, y cada consulta nueva alimentaba el modelo siguiente. El reconocimiento pasó de ser un programa a ser un servicio, la forma que todavía conserva.
Cronología

Hitos del reconocimiento de voz,
año por año

Cada hecho de la tabla tiene su fecha. Las secciones que la rodean explican por qué importó cada uno.

AñoHitoPor qué importó
1952Bell Labs construye AudreyLa primera máquina que reconoce habla: los dígitos del 0 al 9 de un solo hablante
1962IBM presenta Shoebox16 palabras, mostradas al público en la Feria Mundial de Seattle
1971DARPA inicia el programa Speech Understanding ResearchCinco años de financiamiento y una meta de 1,000 palabras
1976Harpy, de Carnegie Mellon, cumple la meta1,011 palabras y una búsqueda con poda que los decodificadores aún usan
1986Tangora, de IBM, llega a 20,000 palabrasModelos ocultos de Márkov y modelos de lenguaje de n-gramas pasan a ser el estándar
1988Sphinx en Carnegie MellonReconocimiento continuo, independiente del hablante y de vocabulario amplio en un solo sistema
1990Se lanza Dragon DictateEl primer producto de reconocimiento de voz vendido a consumidores
1997Dragon NaturallySpeaking e IBM ViaVoiceDictado continuo en una computadora doméstica a unas 100 palabras por minuto
2008Google Voice SearchEl reconocimiento se muda a la nube y aprende de cada consulta
2011Apple lanza SiriUn asistente de voz en un teléfono de gran consumo
2012Las redes neuronales profundas reemplazan a las mezclas gaussianasLas tasas de error caen hasta un tercio de golpe
2016Microsoft reporta un 5.9% en SwitchboardLa primera reivindicación de paridad humana en un benchmark conversacional
2017Microsoft 5.1%, IBM 5.5%, Google 4.9%; se publica el TransformerTermina la carrera por la paridad y llega la siguiente arquitectura
2020wav2vec 2.0 y el ConformerEl aprendizaje autosupervisado reduce la necesidad de datos etiquetados
2022OpenAI publica Whisper680,000 horas de entrenamiento, casi 100 idiomas, pesos abiertos

El aprendizaje profundo redujo las tasas de error a menos de la mitad en los años 2010

Entre 2011 y 2017 la tasa de error de palabras en conversaciones telefónicas bajó de poco más del 10 por ciento a cerca del 5 por ciento, y los asistentes de voz entraron en los hogares.

Siri y los asistentes

Apple lanzó Siri con el iPhone 4S en octubre de 2011, y por primera vez un teléfono de gran consumo traía un asistente de voz detrás del botón de inicio. Amazon siguió con Alexa en el Echo en 2014, y Google con Google Home en 2016. Los asistentes importaron menos por su reconocimiento, que se ejecutaba en la nube igual que Google Voice Search, que por el hábito que crearon: cientos de millones de personas empezaron a hablar con máquinas todos los días, y cada frase pronunciada se convirtió en datos de entrenamiento.

El salto a las redes neuronales

En 2012 investigadores de Microsoft, Google, IBM y la Universidad de Toronto, entre ellos Geoffrey Hinton, publicaron un artículo conjunto que demostraba que las redes neuronales profundas entrenadas en la parte acústica del problema reducían las tasas de error hasta en un tercio frente a los modelos de mezclas gaussianas que los sistemas HMM habían usado durante 25 años. Deep Speech, de Baidu, fue más lejos en 2014 y entrenó una sola red recurrente de extremo a extremo, del audio a los caracteres, sin diccionario de pronunciación ni cadena de procesamiento armada a mano. El reconocimiento se convirtió en un problema de aprendizaje profundo, y los laboratorios con más GPU y más datos tomaron la delantera.

La carrera por la paridad humana

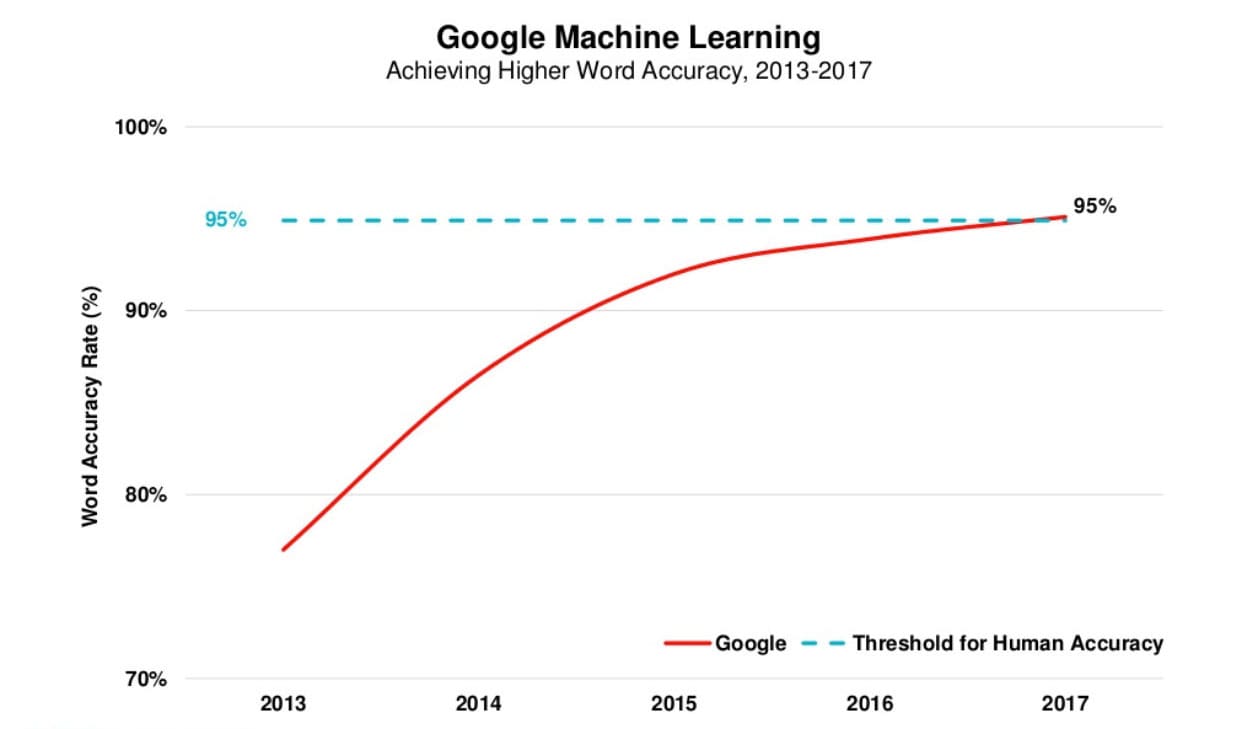
El benchmark Switchboard, un conjunto de conversaciones telefónicas grabadas, se convirtió en el marcador. En octubre de 2016 Microsoft reportó un 5.9 por ciento de tasa de error de palabras, la misma cifra que la de los transcriptores profesionales que contrató para trabajar las mismas llamadas, y lo llamó paridad humana. IBM respondió con un 5.5 por ciento en marzo de 2017, Google anunció un 4.9 por ciento en sus propios conjuntos de prueba en mayo de ese año, y en agosto de 2017 Microsoft llegó al 5.1 por ciento frente a una medición más cuidadosa de la referencia humana. El gráfico de abajo, del informe Internet Trends 2017 de Mary Meeker, muestra la precisión de palabras de Google cruzando la marca del 95 por ciento que la industria trataba como el umbral humano. Ese mismo año se publicó la arquitectura Transformer para traducción automática, y en tres años se había apoderado también del habla.

Gráfico de la tasa de precisión de palabras de Google superando el 95 por ciento, del informe Internet Trends 2017 de Mary Meeker

Whisper y el Transformer pusieron la transcripción al alcance de cualquiera

El entrenamiento autosupervisado y un solo modelo abierto convirtieron la transcripción multilingüe precisa, antes una capacidad exclusiva de las grandes tecnológicas, en algo que cualquier producto puede ofrecer.

Aprender de audio sin etiquetar

El cuello de botella de los años 2010 eran los datos etiquetados: cada hora de entrenamiento necesitaba una transcripción hecha por humanos. En 2020, wav2vec 2.0, de Facebook AI, aprendió primero representaciones del habla a partir de audio en bruto sin transcribir y necesitó apenas diez minutos de habla etiquetada para afinar un reconocedor utilizable. Conformer, de Google, publicado ese mismo año, combinó la convolución con la atención del Transformer y marcó nuevos récords en los benchmarks estándar. Entre los dos convirtieron al Transformer en la arquitectura por defecto para el habla y abarataron el costo de añadir un idioma nuevo.

Whisper

En septiembre de 2022 OpenAI publicó Whisper, entrenado con 680,000 horas de audio recopiladas de la web, con cobertura de casi 100 idiomas y con los pesos del modelo publicados para que cualquiera pudiera ejecutarlo. No era el sistema más preciso en todos los benchmarks, pero resistía los acentos, el ruido de fondo y el vocabulario técnico como no lo hacían los modelos académicos anteriores, y era gratis. En cuestión de meses estaba dentro de miles de productos, y la pregunta para las empresas de transcripción dejó de ser si podían reconocer el habla y pasó a ser qué construían alrededor de la transcripción.

Qué significa eso para usted hoy

Una grabación de una hora subida a Sonix vuelve convertida en transcripción en unos 5 a 6 minutos, con etiquetas de hablante, marcas de tiempo y una precisión del 99% en audio limpio, en cualquiera de sus 54+ idiomas. Sonix se fundó en 2017, el año de la carrera por la paridad humana, y desde entonces ha aprovechado cada avance: los modelos mejoran cada año, y el trabajo se concentra ahora en el editor, los resúmenes, las traducciones y las exportaciones que hacen útil una transcripción. Las siete décadas anteriores son la razón de que hoy una primera transcripción no cueste nada: sus primeros 30 minutos son gratis.

La identificación automática del idioma tiene su propia historia

Saber en qué idioma se habla es un problema distinto de saber qué palabras se dicen, y también tardó sus buenos 50 años en resolverse.

De la estadística de fonemas a los i-vectors

Los primeros experimentos de identificación de idioma, en los años 70, intentaban distinguir las lenguas por la estadística de sus sonidos, partiendo de la teoría de que cada idioma usa una mezcla distinta de fonemas con distintas frecuencias. En los años 90 eso se convirtió en el enfoque fonotáctico: ejecutar un reconocedor de fonemas y luego preguntar con qué idioma encajan mejor los patrones de fonemas. El Instituto Nacional de Estándares y Tecnología (NIST) inició sus evaluaciones formales de reconocimiento de idioma en 1996, y la cultura de benchmarks que impulsó el reconocimiento de voz impulsó también la identificación de idioma. En los años 2010 el i-vector, un resumen compacto y de longitud fija de una grabación tomado prestado del reconocimiento de hablante, produjo sistemas capaces de nombrar un idioma a partir de unos pocos segundos de audio.

Integrada en el modelo

Los reconocedores multilingües modernos funden los dos problemas en uno. Whisper y sus sucesores predicen el idioma como primer token de la transcripción, de modo que la identificación es un subproducto del reconocimiento y no un paso aparte. Eso es lo que permite que un solo producto maneje 54+ idiomas sin un reconocedor distinto para cada uno, y la razón de que el idioma que usted habla haya dejado de ser un límite para lo que puede transcribir.

Lo que viene: la voz se convierte en la interfaz

La tecnología que necesitan las aplicaciones de voz ya es barata y precisa, y la pregunta ha pasado de si las máquinas pueden oír a qué deberían hacer con lo que oyen.

La voz como punto de partida

Los dispositivos diseñados para la voz, desde los altavoces inteligentes hasta los auriculares y los autos, han hecho que hablar con una máquina sea algo corriente, y la precisión que costó 70 años alcanzar hoy se da por sentada en lugar de ser una prestación. El lenguaje es la única interfaz que casi todo el mundo ya tiene, y por eso una pequeña mejora en el reconocimiento llega a más personas de las que jamás alcanzaría una pantalla nueva. Las empresas que construyen sobre la voz desde temprano tienden a conservar ese terreno, como hicieron en los años 2010 las empresas que apostaron primero por el celular.

Más allá de la transcripción

La propia transcripción se ha convertido en la materia prima. Los grandes modelos de lenguaje resumen reuniones, responden preguntas sobre una entrevista, traducen una conferencia y redactan a partir de ella el correo de seguimiento, y hacen bien esas cosas solo porque la transcripción que hay debajo es precisa. En Sonix ese es el trabajo: el reconocimiento es la base que sentaron todos los nombrados arriba, y el producto es lo que usted puede hacer con las palabras una vez que existen.

Preguntas frecuentes

Historia del reconocimiento de voz,
las dudas resueltas

¿Cuándo y dónde se inventó el reconocimiento de voz?

En 1952. El sistema Audrey de Bell Labs, construido por K. H. Davis, R. Biddulph y S. Balashek, reconocía los dígitos hablados del 0 al 9 de un solo hablante. El Shoebox de IBM siguió en 1962 con 16 palabras, y el primer producto que se podía comprar, Dragon Dictate, llegó en 1990.

¿Quién inventó el reconocimiento de voz?

No fue una sola persona. Tres ingenieros de Bell Labs construyeron el primer reconocedor, Audrey, en 1952. James Baker y Fred Jelinek hicieron estadístico el reconocimiento con los modelos ocultos de Márkov en los años 70, el Sphinx de Kai-Fu Lee lo hizo continuo e independiente del hablante en 1988, y los colaboradores de Geoffrey Hinton le incorporaron el aprendizaje profundo en 2012.

¿Cuál fue el primer software de reconocimiento de voz?

Dragon Dictate, lanzado por Dragon Systems en 1990 por unos 9,000 dólares, fue el primer software de reconocimiento de voz vendido al público. Exigía una pausa entre palabras. Dragon NaturallySpeaking, lanzado en 1997, fue el primer producto de dictado de habla continua para computadoras domésticas.

Reconocimiento del habla y reconocimiento de voz: ¿cuál es la diferencia?

El reconocimiento del habla identifica las palabras que se dijeron. El reconocimiento de voz, en sentido estricto, identifica quién las dijo a partir de las características de la voz, que es como un teléfono se desbloquea para su dueño. En el uso cotidiano los dos términos se intercambian sin problema, y en español "reconocimiento de voz" suele nombrar a ambos. Este artículo trata del reconocimiento de palabras, la tecnología detrás de la transcripción, el dictado y los asistentes de voz.

¿El reconocimiento de voz es una forma de IA?

Sí. Desde 2012 todo reconocedor de voz competitivo es una red neuronal profunda entrenada con grandes cantidades de audio, la misma familia de métodos que hay detrás de los grandes modelos de lenguaje. Antes de eso, los modelos ocultos de Márkov también eran una forma de aprendizaje automático: aprendían probabilidades a partir de habla grabada en lugar de seguir reglas escritas a mano.

¿Qué tan preciso es hoy el reconocimiento de voz?

En grabaciones conversacionales limpias los mejores sistemas igualan a los transcriptores profesionales: Microsoft midió una tasa de error de palabras del 5.1% en el benchmark Switchboard en 2017, y los modelos han mejorado desde entonces. Sonix alcanza una precisión del 99% con buen audio. Los acentos marcados, las voces superpuestas y el ruido de fondo todavía elevan la tasa de error, y por eso cada transcripción viene con un editor.

Empiece ahora

Pruebe Sonix gratis

Sonix transcribe, pone marcas de tiempo y organiza sus archivos de audio y vídeo para que pueda buscar, editar y compartir su contenido multimedia.

Incluye 30 minutes minutos de transcripción gratuita

Siga leyendo

99% de precisión. Cada palabra cuenta.

Transcripción y traducción con IA en 54+ idiomas.

30 minutes gratis
Sin tarjeta de crédito
Cancele en cualquier momento