1952年から現在まで
音声認識の歴史

音声認識は1952年にベル研究所で生まれました。話された10個の数字しか聞き取れなかった機械が、54以上の言語を扱うまでになった道のりを、年代ごとにたどります。

ひと目でわかる音声認識の歴史

誕生
音声認識が誕生したのは1952年です。ベル研究所のAudreyというシステムが、一人の話者が発声した0から9までの数字を聞き分けました。
初の市販ソフト
1990年に約9,000ドルで発売されたDragon Dictateは、一般向けに販売された初の音声認識製品でした。ただし、単語を一つ言うたびに間を置く必要がありました。
初の1,000語認識
カーネギーメロン大学のHarpyは1976年に1,011語を理解しました。これは、DARPAが5年間の音声理解研究プログラムに掲げた目標値でした。
人間と同等の精度
2017年、Microsoftは電話音声ベンチマークSwitchboardで5.1%の単語誤り率を記録し、同じ通話を書き起こしたプロの文字起こし担当者と肩を並べました。
オープンモデル
2022年9月に公開されたOpenAIのWhisperは、68万時間の音声で学習され、100近い言語を文字起こしできます。モデルの重みも公開されています。
現在
2017年創業のSonixは、54以上の言語を99%の精度で文字起こしし、1時間のファイルを5〜6分ほどで返します。

音声認識は1952年に発明された

最初の音声認識機は1952年にベル研究所で作られ、理解できる単語はちょうど10個、0から9までの数字だけでした。

自動数字認識機Audrey

K. H. Davis、R. Biddulph、S. Balashekの3人は、高さ6フィートのリレーラックを埋め尽くすアナログ回路でAudreyを組み上げました。話者が電話の受話器に向かって数字を言うと、機械が母音のフォルマントを測り、聞き取った数字の横のランプが点灯する仕組みです。設計者たちの声に合わせて調整した状態では97から99パーセントの正答率を出しましたが、見知らぬ人の声にはまるで歯が立ちませんでした。人間の交換手が番号をダイヤルするほうが安上がりだったため、Audreyが研究所の外に出ることはありませんでした。それでも、機械は音声を聞き取れるのかという問いには、これで決着がついたのです。

IBMのShoeboxと1960年代

1962年、IBMはシアトル万国博覧会でShoeboxを披露しました。認識できたのは10個の数字と6つの算術コマンドを合わせた16語で、その音声で加算機を動かしてみせたのです。この10年間、アメリカ、イギリス、日本、ソ連の研究所が母音や子音、小さな単語リストを対象にした認識機を作り、1968年にはTaras Vintsyukが、話す速さの違う音声どうしを機械が比べられるようにする整列手法、動的時間伸縮法を発表しました。1969年の時点で、この分野には野心こそあれ理論がありませんでした。ベル研究所のJohn Pierceはこれを水をガソリンに変える計画になぞらえ、同研究所は数年にわたって資金提供を打ち切りました。

DARPAの音声理解研究プログラムで語彙が1,000語を超えた

1971年から1976年にかけて、DARPAは当時としては最大規模の音声認識研究に資金を投じ、カーネギーメロン大学のHarpyが目標の1,000語に到達しました。

5年間の目標

音声理解研究プログラムが求めたのは、複数の話者による連続音声を1,000語の語彙で、誤り率10パーセント未満で理解できるシステムでした。カーネギーメロン大学、BBN、SRIなどに資金を出して競わせたのです。ゴールにたどり着いたのは3つのシステム、カーネギーメロン大学のHearsay-IIとHarpy、そしてBBNのHWIMでした。1976年に完成したHarpyは、3歳児の語彙にほぼ相当する1,011語を理解し、目標を達成した唯一のシステムとなりました。決め手は、あらゆる可能性を検討する代わりに、見込みの薄い単語列を早い段階で枝刈りする探索手法で、この発想は今もあらゆるデコーダの中核にあります。

統計的アプローチの登場

同じ時期に、その後40年にわたって他のあらゆる手法を凌駕することになるアイデアが生まれました。カーネギーメロン大学では、James Bakerが1975年の学位論文でDRAGONシステムを発表しました。音声を隠れマルコフモデルとして扱い、人が書いたルールではなく確率に、どの単語が話されたかを判定させる仕組みです。IBMではFred Jelinekのグループが同じ手法を研究用のディクテーションシステムに組み込み、さらにnグラム言語モデルを加えて、直前の2語から次の単語を推測できるようにしました。一方のベル研究所は、一人の声から多くの声へと対象を広げ、電話アプリケーションに欠かせない、話者を問わず動作する認識機を作り上げました。

1980年代、隠れマルコフモデルが音声認識を統計的手法に変えた

1980年代にはパターンマッチングが確率に取って代わられ、語彙は10年のうちに数百語から2万語へと広がりました。

隠れマルコフモデルはどう聞くのか

隠れマルコフモデルは、音をテンプレートに照合しようとはしません。受け取った音声を最も高い確率で生み出したのはどの音素列か、そしてその音素列を最も高い確率で生み出したのはどの単語列か、と問いかけます。確率は録音された音声で学習して決めるため、データが増えるほど認識機は賢くなります。この性質は、インターネットの登場後にとてつもなく大きな意味を持つことになります。nグラム言語モデルと組み合わせたHMMは、あらゆる研究所で標準のアーキテクチャとなり、2012年にディープラーニングに取って代わられるまでその座を守りました。

Tangora、Sphinx、そして最初の製品

IBMのTangoraは1980年代半ばまでに2万語の語彙を認識できるようになりましたが、単語ごとに間を置く必要があり、話者ごとの学習も欠かせませんでした。1988年、カーネギーメロン大学でKai-Fu Leeが開発したSphinxは、大語彙、連続音声、話者非依存の3つを一つの認識機で初めて両立させました。1982年にJames BakerとJanet Bakerが設立したDragon Systemsは、パソコン向けの音声認識ソフトの販売を始めます。音声認識が消費者の手に届いたのもこの時期です。1987年にはWorlds of Wonder社の人形Julieがいくつかの決まった言葉に返事をし、電話会社は音声ダイヤルの試験を行いました。おもちゃとしては素朴なものでしたが、「音声認識」という言葉を一般家庭に持ち込んだのです。

1990年代、音声認識がパソコンにやってきた

プロセッサの高速化により、ディクテーションは研究所のデモから店頭に並ぶパッケージソフトになり、共通のベンチマークのおかげで進歩を測りやすくなりました。

Dragon DictateからNaturallySpeakingへ

Dragon Dictateは1990年に約9,000ドルで発売されました。一般の人が買える初めての音声認識製品でしたが、単語を一つ言うたびに間を置かなければなりませんでした。1997年のDragon NaturallySpeakingで、単語ごとに間を置く必要はなくなりました。家庭用PCで毎分100語ほどの連続音声を認識でき、IBMも同じ年にViaVoiceで対抗しました。弁護士や医師、作家がコンピュータに話しかけて使える文章を得られるようになったのは、これが初めてです。ただし、学習させて誤りを直す手間は必要でした。

自動音声応答と最初のベンチマーク

1996年、BellSouthは電話をかけると音声の質問に答えてくれるボイスポータルVALを開始しました。以来、皆さんが電話口で格闘してきた自動音声応答システムはすべて、その子孫にあたります。舞台裏では、DARPAと米国立標準技術研究所(NIST)がSwitchboard電話コーパスなどの共通の録音を使って毎年評価を実施し、単語誤り率がどの研究所も報告する指標になりました。それ以降の音声認識の歴史は、おおむねこの数字が下がっていく歴史です。

2000年代、音声認識はクラウドへ移った

精度はこの10年の大半を80パーセント前後で足踏みしていましたが、Googleが認識処理を端末から自社サーバーへ移したことで流れが変わりました。

停滞期

2001年までに、最良のシステムはディクテーション音声をおよそ80パーセントの精度で文字にできるようになっていましたが、それに続く数年は飛躍ではなく小幅な改良の時代でした。デスクトップのディクテーションはニッチにとどまり、自動音声応答は相変わらず苛立たしく、研究資金は細っていきました。隠れマルコフモデルは天井に近づいており、それに取って代わるはずのモデルには、まだ必要な計算能力もデータもなかったのです。

Google Voice Search

Googleが2007年に始めた電話番号案内サービスGOOG-411は、何百万件もの音声クエリを集める手段でした。2008年11月、同社はGoogle Voice SearchをiPhoneアプリとして公開し、音声認識の姿が変わります。電話は録音するだけで、認識は端末にはとても収まらない巨大なモデルを使ってGoogleのデータセンターで行われました。Googleの英語システムは2,300億語の検索クエリで学習していたため、人が次に何を言いそうかを予測でき、新しいクエリの一つひとつが次のモデルの糧になりました。認識はプログラムではなくサービスになり、その形は今も変わっていません。
年表

音声認識の節目を 年ごとにたどる

下の出来事にはすべて年が付いています。それぞれがなぜ重要だったのかは、この表の前後の節で解説しています。

年出来事なぜ重要か
1952ベル研究所がAudreyを開発音声を認識した最初の機械。一人の話者の0から9の数字
1962IBMがShoeboxを披露16語。シアトル万博で一般公開
1971DARPAが音声理解研究プログラムを開始5年間の資金と1,000語の目標
1976カーネギーメロン大学のHarpyが目標を達成1,011語。デコーダが今も使う枝刈り探索
1986IBMのTangoraが2万語に到達隠れマルコフモデルとnグラム言語モデルが標準に
1988カーネギーメロン大学のSphinx連続音声、話者非依存、大語彙を一つのシステムで
1990Dragon Dictate発売消費者向けに販売された初の音声認識製品
1997Dragon NaturallySpeakingとIBM ViaVoice家庭用PCで毎分約100語の連続ディクテーション
2008Google Voice Search認識がクラウドへ移り、あらゆるクエリから学習
2011AppleがSiriを発表主流のスマートフォンに音声アシスタント
2012ディープニューラルネットワークが混合ガウスモデルを置き換え誤り率が一気に最大3分の1下がる
2016MicrosoftがSwitchboardで5.9%を報告会話ベンチマークで初めて人間と同等を主張
2017Microsoft 5.1%、IBM 5.5%、Google 4.9%。Transformerが発表される同等精度をめぐる競争が終わり、次のアーキテクチャが登場
2020wav2vec 2.0とConformer自己教師あり学習でラベル付きデータの必要量が減る
2022OpenAIがWhisperを公開学習68万時間、100近い言語、重みを公開

2010年代、ディープラーニングが誤り率を半分以下に下げた

2011年から2017年にかけて、電話での会話音声に対する単語誤り率は10パーセント台前半から5パーセント前後まで下がり、音声アシスタントが家庭に入り込みました。

Siriと音声アシスタント

2011年10月、AppleはiPhone 4SにSiriを載せて出荷しました。主流のスマートフォンに、ホームボタンの奥で待つ音声アシスタントが付いてきたのはこれが初めてです。2014年にはAmazonがEchoにAlexaを載せ、2016年にはGoogleがGoogle Homeで続きました。これらのアシスタントの認識処理はGoogle Voice Searchと同じようにクラウドで動いており、技術そのものより重要だったのは、人々に植え付けた習慣のほうでした。何億人もの人が毎日機械に話しかけるようになり、その一言一言が学習データになったのです。

ニューラルネットワークへの転換

2012年、Geoffrey Hintonを含むMicrosoft、Google、IBM、トロント大学の研究者が共同論文を発表し、音響モデル側にディープニューラルネットワークを使うと、HMMシステムが25年間使ってきた混合ガウスモデルに比べて誤り率が最大で3分の1下がることを示しました。2014年にはBaiduのDeep Speechがさらに踏み込み、発音辞書も人手で組んだパイプラインも使わずに、音声から文字までを一つのリカレントネットワークでエンドツーエンドに学習しました。音声認識はディープラーニングの問題となり、GPUとデータを最も多く持つ研究所が抜け出していきました。

人間と同等の精度をめぐる競争

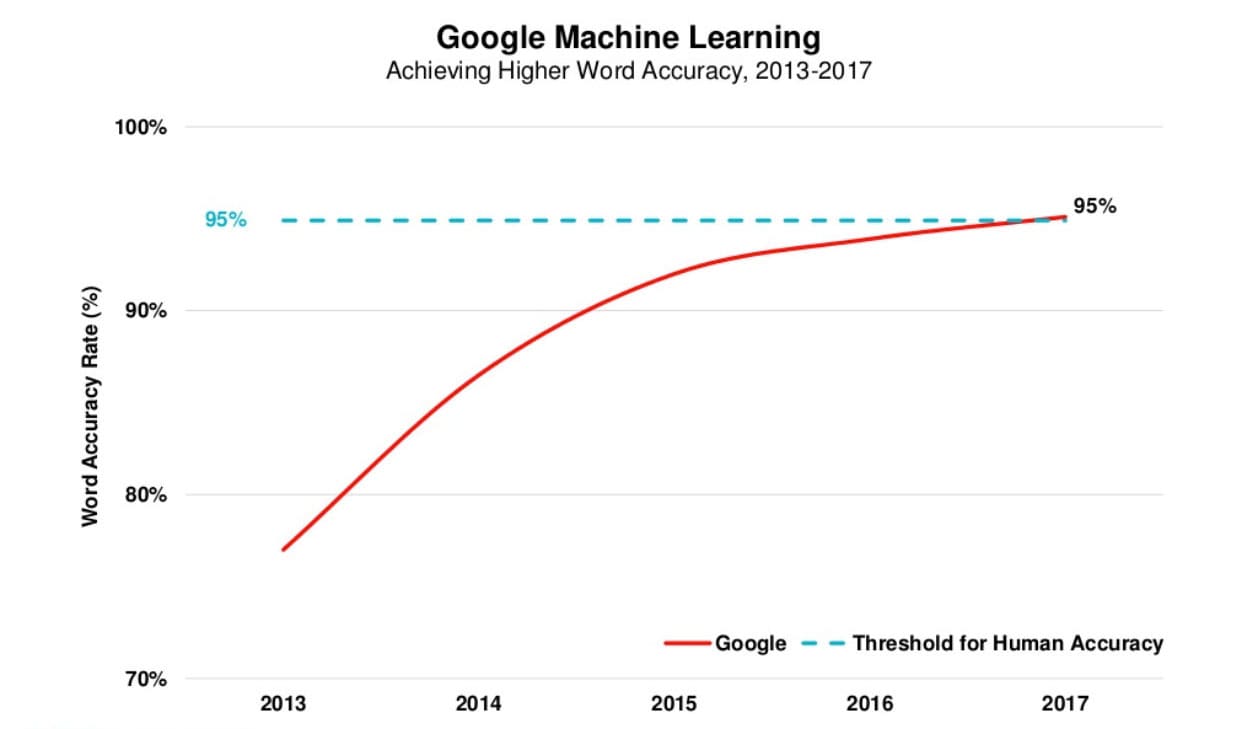
電話での会話を録音したSwitchboardベンチマークが、スコアボードになりました。2016年10月、Microsoftは5.9パーセントの単語誤り率を報告し、同じ通話を書き起こすために雇ったプロの文字起こし担当者と同じ水準だとして、これを人間と同等(ヒューマンパリティ)と呼びました。IBMは2017年3月に5.5パーセントで応じ、Googleは同年5月に自社のテストセットで4.9パーセントを発表、そして2017年8月、Microsoftは人間の基準値をより慎重に測り直したうえで5.1パーセントに到達しました。下のグラフはMary Meekerの2017年版Internet Trendsレポートからのもので、Googleの単語正解率が、業界で人間の水準とみなされていた95パーセントの線を越える様子を示しています。同じ年、機械翻訳向けにTransformerアーキテクチャが発表され、3年もたたないうちに音声の領域も席巻しました。

Googleの単語正解率が95パーセントを超える様子を示すグラフ。Mary Meekerの2017年版Internet Trendsレポートより

WhisperとTransformerで文字起こしはコモディティになった

自己教師あり学習と一つのオープンモデルによって、高精度な多言語文字起こしは巨大テック企業だけの能力から、どんな製品でも提供できるものに変わりました。

ラベルなし音声からの学習

2010年代のボトルネックはラベル付きデータでした。学習に使う音声には1時間ごとに人間の書き起こしが必要だったのです。2020年、Facebook AIのwav2vec 2.0は、まず書き起こしのない生の音声から音声表現を学習し、わずか10分のラベル付き音声があれば実用的な認識機にファインチューニングできることを示しました。同じ年に発表されたGoogleのConformerは、畳み込みとTransformerのアテンションを組み合わせ、標準ベンチマークの記録を塗り替えました。この2つが揃ったことで、Transformerは音声の既定のアーキテクチャとなり、新しい言語を追加するコストが下がりました。

Whisper

2022年9月、OpenAIはWhisperを公開しました。ウェブから集めた68万時間の音声で学習し、100近い言語に対応し、モデルの重みは誰でも動かせるよう公開されました。あらゆるベンチマークで最高精度というわけではありませんでしたが、それまでの学術モデルにはなかった、なまりや背景雑音、専門用語への強さがあり、しかも無料でした。数か月のうちに何千もの製品に組み込まれ、文字起こし企業にとっての問いは、音声を認識できるかどうかから、文字起こしの周りに何を作るかへと移りました。

それが今、何を意味するのか

Sonixに1時間の録音をアップロードすると、5〜6分ほどで話者ラベルとタイムスタンプ付きの文字起こしが返ってきます。音質の良い音声なら精度は99%、対応言語は54以上です。Sonixが創業したのは、人間と同等の精度をめぐる競争が繰り広げられた2017年で、それ以降の一歩一歩をともに歩んできました。モデルは年々良くなり、今では、文字起こしを本当に役立つものにするエディタ、要約、翻訳、書き出しの作り込みに力を注いでいます。最初の文字起こしに今日お金がかからないのは、上でたどった70年の歩みがあるからです。最初の30分は無料です。

自動言語識別にも独自の歴史がある

どの言語が話されているかを知ることは、どの単語が話されたかを知ることとは別の問題で、解決にはこちらも50年を要しました。

音素の統計からi-vectorへ

1970年代に行われた最初の言語識別の実験は、言語ごとに使う音素の組み合わせと頻度が異なるという考えに基づき、音の統計から言語を聞き分けようとするものでした。1990年代には、これが音素配列(phonotactic)アプローチに発展します。音素認識機を走らせ、どの言語の音素パターンに最もよく当てはまるかを問う手法です。米国立標準技術研究所は1996年に正式な言語認識評価を始め、音声認識を前に進めたベンチマーク文化が、言語識別も同じように前に進めました。2010年代には、話者認識から借りてきた、録音を固定長で簡潔に表すi-vectorによって、数秒の音声から言語を言い当てられるシステムが生まれました。

モデルに組み込まれた識別

現代の多言語認識機は、この2つの問題を一つにまとめています。Whisperとその後継モデルは、文字起こしの最初のトークンとして言語を予測するため、言語識別は独立した工程ではなく認識の副産物になりました。一つの製品が言語ごとに別々の認識機を持たずに54以上の言語を扱えるのはこのためで、話す言語が文字起こしの制約ではなくなったのも、これが理由です。

この先に来るもの:音声がインターフェースになる

音声アプリケーションに必要な技術は今や安価で正確になり、問いは、機械が聞き取れるかどうかから、聞き取ったものをどう活かすべきかへと移りました。

ボイスファーストの製品

スマートスピーカーからイヤホン、自動車まで、ボイスファーストの機器のおかげで機械に話しかけることは当たり前になり、70年かけて到達した精度は今や売りではなく前提です。言語は、ほぼすべての人がすでに持っている唯一のインターフェースです。だからこそ、認識のわずかな改善は、どんな新しい画面よりも多くの人に届きます。2010年代のモバイルファースト企業がそうだったように、早くから音声の上に築いた企業は、その地歩を守り続ける傾向があります。

文字起こしの先へ

文字起こしそのものが、いまや素材になりました。大規模言語モデルは、それをもとに会議を要約し、インタビューについての質問に答え、講義を翻訳し、フォローアップのメールを下書きします。それがうまくいくのは、土台にある文字起こしが正確だからにほかなりません。Sonixの仕事はまさにそこにあります。認識技術は上に名前を挙げた人々全員が築いた土台であり、製品とは、言葉が文字になった先に何ができるかを形にしたものなのです。

よくある質問

音声認識の歴史をめぐる 疑問にお答えします

音声認識はいつ、どこで発明されたのですか?

1952年、ベル研究所で生まれました。K. H. Davis、R. Biddulph、S. Balashekが作ったAudreyシステムが、一人の話者が発声した0から9までの数字を認識しました。1962年にはIBMのShoeboxが16語で続き、初めて購入できる製品となったDragon Dictateは1990年に登場しました。

音声認識を発明したのは誰ですか?

特定の一人ではありません。1952年にベル研究所の3人の技術者が最初の認識機Audreyを作りました。1970年代にはJames BakerとFred Jelinekが隠れマルコフモデルで音声認識を統計的な手法に変え、1988年にはKai-Fu LeeのSphinxが連続音声と話者非依存を実現し、2012年にはGeoffrey Hintonの共同研究者たちがディープラーニングを持ち込みました。

最初の音声認識ソフトは何ですか?

Dragon Systemsが1990年に約9,000ドルで発売したDragon Dictateが、一般向けに販売された初の音声認識ソフトです。単語と単語の間に間を置く必要がありました。1997年発売のDragon NaturallySpeakingは、家庭用コンピュータ向けとしては初の連続音声ディクテーション製品でした。

音声認識と話者認識はどう違うのですか?

音声認識は、どんな言葉が話されたかを特定します。話者認識(英語ではvoice recognition)は、声の特徴から誰が話したかを特定する技術で、スマートフォンが持ち主の声でロックを解除できるのはこの仕組みによります。日常会話では両者はしばしば混同されます。この記事で扱うのは言葉を認識する技術、つまり文字起こし、ディクテーション、音声アシスタントを支えている技術のほうです。

音声認識はAIの一種ですか?

はい。2012年以降、第一線の音声認識機はすべて大量の音声で学習したディープニューラルネットワークで、大規模言語モデルと同じ系統の手法です。それ以前の隠れマルコフモデルも機械学習の一種でした。人が書いたルールに従うのではなく、録音された音声から確率を学んでいたからです。

音声認識の精度は今どのくらいですか?

明瞭な会話の録音であれば、最良のシステムはプロの文字起こし担当者に並びます。Microsoftは2017年にSwitchboardベンチマークで5.1%の単語誤り率を記録し、モデルはその後も改善を続けています。Sonixは良好な音声で99%の精度に達します。強いなまりや話者の重なり、背景雑音は依然として誤り率を押し上げるため、すべての文字起こしにエディタが付いているのです。

今すぐ始める

Sonixを無料で試す

Sonixは、オーディオおよびビデオファイルを文字起こし、タイムスタンプ付与、整理することで、メディアの検索、編集、共有を可能にします。

30 minutes 分間の無料文字起こしが含まれています

続きを読む

99% の精度。 一言一句を大切に。

54以上の言語対応の AI 文字起こしと翻訳。

30 minutes 無料
クレジットカード不要
いつでもキャンセル可能