 Stephen Hopkins
Spraakherkenning in een oogopslag
- Uitgevonden
- Spraakherkenning werd in 1952 uitgevonden, toen het Audrey-systeem van Bell Labs de cijfers 0 tot 9 herkende, uitgesproken door één stem.
- Eerste consumentensoftware
- Dragon Dictate, in 1990 uitgebracht voor ongeveer 9.000 dollar, was het eerste spraakherkenningsproduct dat aan het publiek werd verkocht, en het had na elk woord een pauze nodig.
- Eerste woordenschat van 1.000 woorden
- In 1976 begreep Harpy van Carnegie Mellon 1.011 woorden, het doel dat DARPA voor zijn vijfjarige Speech Understanding Research-programma had gesteld.
- Menselijk niveau
- In 2017 mat Microsoft een woordfoutpercentage van 5,1% op de Switchboard-telefoonbenchmark, gelijk aan de professionele transcribenten die dezelfde gesprekken uitwerkten.
- Open modellen
- Whisper van OpenAI, uitgebracht in september 2022, is getraind op 680.000 uur audio en transcribeert bijna 100 talen met gepubliceerde gewichten.
- Vandaag
- Sonix, opgericht in 2017, transcribeert 54+ talen met 99% nauwkeurigheid en levert een bestand van een uur in ongeveer 5 tot 6 minuten terug.
Spraakherkenning werd in 1952 uitgevonden
De eerste spraakherkenner werd in 1952 bij Bell Labs gebouwd en begreep precies tien woorden: de cijfers nul tot en met negen.
Audrey, de Automatic Digit Recognizer
K. H. Davis, R. Biddulph en S. Balashek bouwden Audrey uit analoge schakelingen die een relaisrek van 1,8 meter hoog vulden. Een spreker zei een cijfer in een telefoonhoorn, de machine mat de klinkerformanten en naast het herkende cijfer ging een lampje branden. Afgestemd op de stemmen van de ontwerpers haalde Audrey 97 tot 99 procent; bij vreemden ging het mis. Audrey heeft het laboratorium nooit verlaten, omdat een telefoniste die nummers draaide goedkoper was, maar het beslechtte wel de vraag of een machine überhaupt kon horen.
IBM's Shoebox en de jaren 60
In 1962 demonstreerde IBM Shoebox op de wereldtentoonstelling in Seattle. Het herkende 16 gesproken woorden, de tien cijfers en zes rekencommando's, en stuurde daarmee een telmachine aan. In de loop van het decennium bouwden laboratoria in de Verenigde Staten, Groot-Brittannië, Japan en de Sovjet-Unie herkenners voor klinkers, medeklinkers en kleine woordenlijsten, en in 1968 beschreef Taras Vintsyuk dynamic time warping, de uitlijnmethode waarmee een machine spraak in verschillende tempo's kon vergelijken. Tegen 1969 had het vakgebied wel ambitie maar geen theorie: John Pierce van Bell Labs vergeleek het met plannen om van water benzine te maken, en het lab draaide de geldkraan jarenlang dicht.
DARPA's Speech Understanding Research-programma bracht de woordenschat voorbij de 1.000 woorden
Tussen 1971 en 1976 financierde DARPA de grootste spraakherkenningsinspanning tot dan toe, en Harpy van Carnegie Mellon haalde het doel van 1.000 woorden.
Het vijfjarige doel
Het Speech Understanding Research-programma vroeg om een systeem dat aaneengesloten spraak van meerdere sprekers kon begrijpen, met een woordenschat van 1.000 woorden en minder dan 10 procent fouten, en betaalde Carnegie Mellon, BBN, SRI en anderen om met elkaar te wedijveren. Drie systemen haalden de finish: Hearsay-II en Harpy van Carnegie Mellon en HWIM van BBN. Harpy, voltooid in 1976, begreep 1.011 woorden, ruwweg de woordenschat van een driejarige, en was de enige die het doel haalde. De truc was een zoekmethode die onwaarschijnlijke woordreeksen vroegtijdig wegsnoeide in plaats van elke mogelijkheid af te wegen, een idee dat nog altijd de kern van elke decoder vormt.
De statistische wending
Diezelfde jaren brachten het idee voort dat de volgende 40 jaar alles zou verslaan. Aan Carnegie Mellon beschreef James Baker in zijn proefschrift uit 1975 het DRAGON-systeem, dat spraak behandelde als een hidden-markovmodel en waarschijnlijkheden, niet handgeschreven regels, liet bepalen welke woorden er waren gezegd. Bij IBM bouwde de groep van Fred Jelinek dezelfde aanpak in een dicteersysteem voor onderzoek en voegde n-gram-taalmodellen toe, zodat de herkenner het volgende woord uit de vorige twee kon raden. Bell Labs ging intussen van één stem naar vele en bouwde herkenners die met verschillende sprekers overweg konden, een vereiste voor telefoontoepassingen.
Hidden-markovmodellen maakten spraakherkenning in de jaren 80 statistisch
In de jaren 80 maakte patroonherkenning plaats voor waarschijnlijkheid, en de woordenschat groeide in tien jaar van een paar honderd woorden naar 20.000.
Hoe een hidden-markovmodel hoort
Een hidden-markovmodel probeert een klank niet aan een sjabloon te koppelen. Het vraagt welke reeks spraakklanken de ontvangen audio het meest waarschijnlijk heeft voortgebracht, en vervolgens welke reeks woorden die klanken het meest waarschijnlijk heeft voortgebracht. Trainen op opgenomen spraak stelt de waarschijnlijkheden vast, dus meer data betekent een betere herkenner, een eigenschap die enorm zou gaan tellen zodra het internet er was. Gecombineerd met n-gram-taalmodellen werd het HMM de standaardarchitectuur in elk onderzoekslab, en dat bleef zo totdat deep learning het in 2012 verdrong.
Tangora, Sphinx en de eerste producten
Tangora van IBM herkende halverwege de jaren 80 een woordenschat van 20.000 woorden, al had het een pauze tussen de woorden nodig en training per spreker. In 1988 was het Sphinx-systeem van Kai-Fu Lee aan Carnegie Mellon het eerste dat een grote woordenschat, aaneengesloten spraak en sprekeronafhankelijkheid in één herkenner combineerde. Dragon Systems, in 1982 opgericht door James en Janet Baker, begon herkenningssoftware voor personal computers te verkopen. Ook consumenten kwamen voor het eerst met stemherkenning in aanraking: de Julie-pop van Worlds of Wonder reageerde in 1987 op een handvol gesproken zinnen, en telefoonmaatschappijen testten spraakgestuurd bellen. Het speelgoed was primitief, maar het bracht de term "stemherkenning" in gewone huiskamers.
De jaren 90 brachten spraakherkenning naar de personal computer
Snellere processors maakten van dicteren software uit de winkel in plaats van een laboratoriumdemonstratie, en een gedeelde benchmark maakte vooruitgang goed meetbaar.
Van Dragon Dictate tot NaturallySpeaking
Dragon Dictate kwam in 1990 op de markt voor ongeveer 9.000 dollar. Het was het eerste spraakherkenningsproduct dat een gewone burger kon kopen, en het eiste een pauze na elk woord. In 1997 schrapte Dragon NaturallySpeaking die pauze: het herkende aaneengesloten spraak met zo'n 100 woorden per minuut op een thuis-pc, en IBM antwoordde datzelfde jaar met ViaVoice. Voor het eerst kon een advocaat, een arts of een schrijver tegen een computer praten en bruikbare tekst terugkrijgen, mits ze het programma trainden en corrigeerden.
Keuzemenu's en de eerste benchmarks
In 1996 lanceerde BellSouth VAL, een inbelbaar spraakportaal dat gesproken vragen beantwoordde, en elk geautomatiseerd telefoonsysteem waar u sindsdien ruzie mee hebt gehad stamt ervan af. Achter de schermen hielden DARPA en het National Institute of Standards and Technology jaarlijkse evaluaties op gedeelde opnamen zoals het Switchboard-telefooncorpus, en het woordfoutpercentage werd het getal dat elk lab rapporteerde. Vanaf dat moment is de geschiedenis van spraakherkenning grotendeels de geschiedenis van dat dalende getal.
De jaren 2000 verplaatsten spraakherkenning naar de cloud
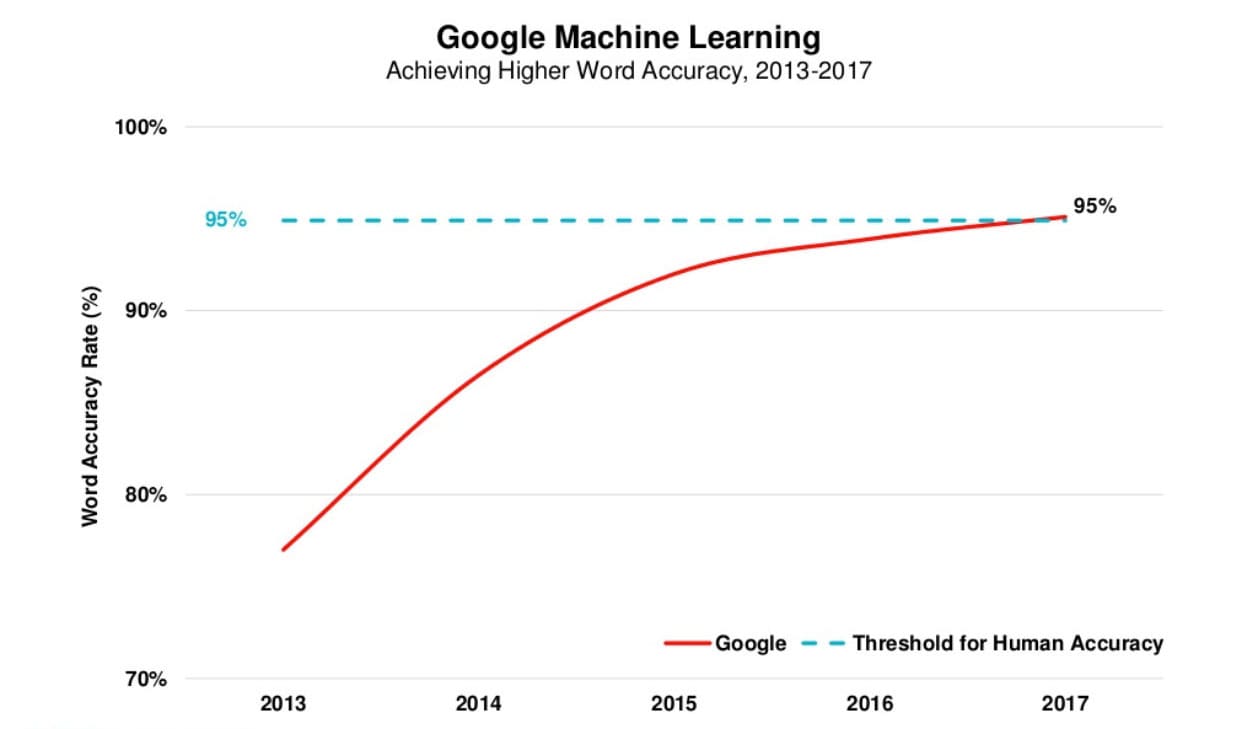
De nauwkeurigheid bleef het grootste deel van het decennium steken rond 80 procent, totdat Google de herkenning van het apparaat naar zijn servers verhuisde.
Het plateau
In 2001 transcribeerden de beste systemen gedicteerde spraak met ruwweg 80 procent nauwkeurigheid, en de jaren daarna brachten verfijningen in plaats van sprongen. Dicteren op de desktop bleef een niche, de keuzemenu's bleven frustrerend en de onderzoeksfinanciering droogde op. Het hidden-markovmodel zat tegen zijn plafond aan, en de modellen die het zouden vervangen hadden de rekenkracht en de data die ze nodig hadden nog niet.
Google Voice Search
De telefonische inlichtingendienst GOOG-411 van Google, gelanceerd in 2007, was een manier om miljoenen gesproken zoekopdrachten te verzamelen. In november 2008 bracht het bedrijf Google Voice Search uit als iPhone-app, en spraakherkenning veranderde van gedaante: de telefoon nam alleen op, en de herkenning draaide in de datacenters van Google op modellen die veel groter waren dan welk apparaat ook kon bevatten. Googles Engelstalige systeem was getraind op 230 miljard woorden aan zoekopdrachten, dus het kon voorspellen wat mensen waarschijnlijk zouden zeggen, en elke nieuwe zoekopdracht voedde het volgende model. Herkenning werd een dienst in plaats van een programma, en die vorm heeft het nog steeds.