 Stephen Hopkins
La reconnaissance vocale en bref
- Invention
- La reconnaissance vocale a été inventée en 1952, lorsque le système Audrey de Bell Labs a reconnu les chiffres de 0 à 9 prononcés par une seule voix.
- Premier logiciel grand public
- Dragon Dictate, lancé en 1990 pour environ 9 000 dollars, a été le premier produit de reconnaissance vocale vendu au grand public, et il exigeait une pause après chaque mot.
- Premier vocabulaire de 1 000 mots
- Harpy, à Carnegie Mellon, comprenait 1 011 mots en 1976, l'objectif que la DARPA avait fixé à son programme quinquennal Speech Understanding Research.
- Parité humaine
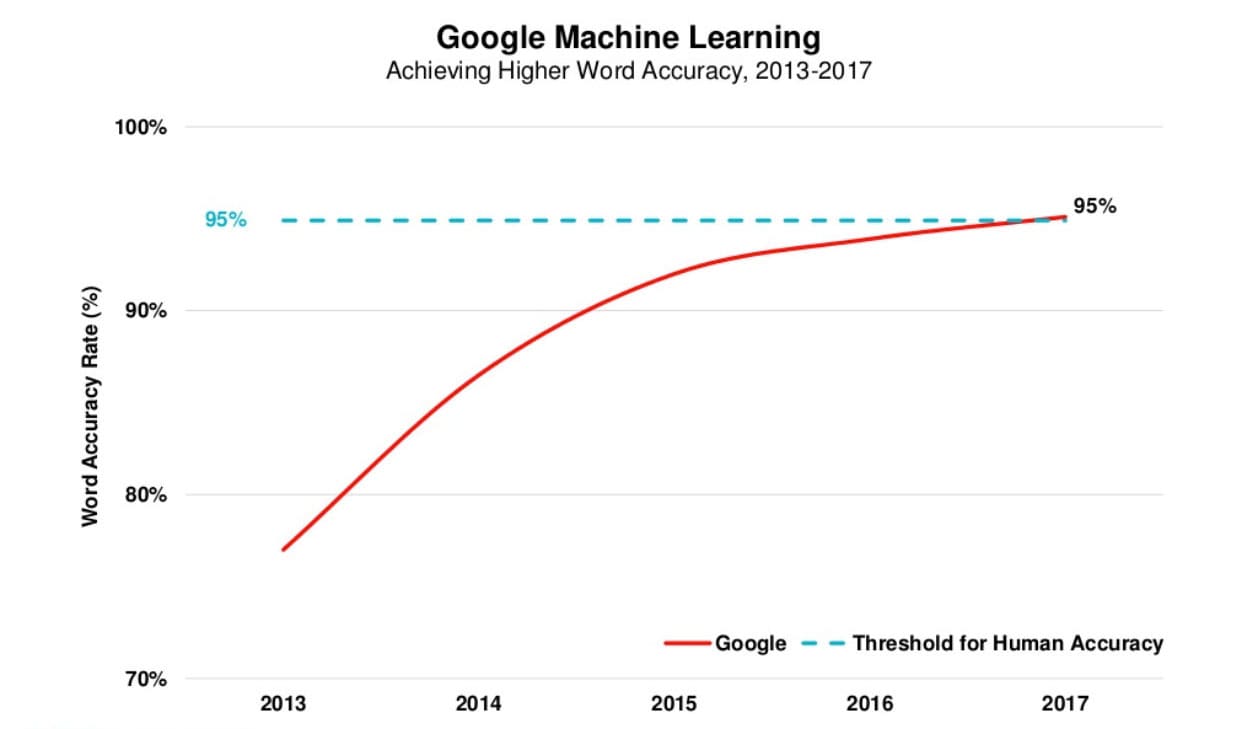
- En 2017, Microsoft a mesuré un taux d'erreur de mots de 5,1 % sur le corpus téléphonique Switchboard, à égalité avec les transcripteurs professionnels chargés des mêmes appels.
- Modèles ouverts
- Whisper, publié par OpenAI en septembre 2022, a été entraîné sur 680 000 heures d'audio et transcrit près de 100 langues, avec des poids rendus publics.
- Aujourd'hui
- Sonix, fondée en 2017, transcrit 54+ langues avec une précision de 99% et renvoie un fichier d'une heure en 5 à 6 minutes environ.
La reconnaissance vocale a été inventée en 1952
Le premier système de reconnaissance de la parole a été construit à Bell Labs en 1952, et il comprenait exactement dix mots : les chiffres de zéro à neuf.
Audrey, le reconnaisseur automatique de chiffres
K. H. Davis, R. Biddulph et S. Balashek ont construit Audrey à partir de circuits analogiques qui remplissaient une baie de relais de six pieds, soit près de deux mètres de haut. Le locuteur prononçait un chiffre dans un combiné téléphonique, la machine mesurait les formants des voyelles et une lampe s'allumait à côté du chiffre reconnu. Réglée sur la voix de ses concepteurs, elle atteignait 97 à 99 pour cent de réussite ; face à des inconnus, elle s'effondrait. Audrey n'a jamais quitté le laboratoire, parce qu'un opérateur humain qui composait les numéros revenait moins cher, mais elle a tranché une question : oui, une machine pouvait entendre.
Shoebox d'IBM et les années 1960
En 1962, IBM a présenté Shoebox à l'Exposition universelle de Seattle. La machine reconnaissait 16 mots parlés, les dix chiffres et six commandes arithmétiques, et pilotait avec eux une machine à additionner. Tout au long de la décennie, des laboratoires aux États-Unis, en Grande-Bretagne, au Japon et en Union soviétique ont construit des reconnaisseurs de voyelles, de consonnes et de petites listes de mots, et en 1968 Taras Vintsyuk a décrit l'alignement temporel dynamique, ou DTW, la méthode qui permettait à une machine de comparer des paroles prononcées à des vitesses différentes. En 1969, le domaine avait de l'ambition mais pas de théorie : John Pierce, de Bell Labs, l'a comparé aux projets visant à transformer l'eau en essence, et le laboratoire a cessé de le financer pendant des années.
Le programme Speech Understanding Research de la DARPA a porté les vocabulaires au-delà de 1 000 mots
De 1971 à 1976, la DARPA a financé le plus vaste effort de reconnaissance vocale jamais entrepris jusque-là, et Harpy, à Carnegie Mellon, a atteint l'objectif des 1 000 mots.
L'objectif sur cinq ans
Le programme Speech Understanding Research réclamait un système capable de comprendre de la parole enchaînée, prononcée par plusieurs locuteurs, sur un vocabulaire de 1 000 mots avec moins de 10 pour cent d'erreur, et il a financé Carnegie Mellon, BBN, SRI et d'autres pour qu'ils se mesurent les uns aux autres. Trois systèmes ont franchi la ligne d'arrivée : Hearsay-II et Harpy à Carnegie Mellon, et HWIM chez BBN. Harpy, achevé en 1976, comprenait 1 011 mots, à peu près le vocabulaire d'un enfant de trois ans, et a été le seul à atteindre la cible. Son astuce : une recherche qui élaguait tôt les séquences de mots improbables au lieu de peser chaque possibilité, une idée qui reste au cœur de tout décodeur.
Le tournant statistique
Ces mêmes années ont produit l'idée qui allait surpasser toutes les autres pendant 40 ans. À Carnegie Mellon, la thèse de James Baker, en 1975, décrivait le système DRAGON, qui traitait la parole comme un modèle de Markov caché et laissait les probabilités, et non des règles écrites à la main, décider des mots prononcés. Chez IBM, l'équipe de Fred Jelinek a intégré la même approche dans un système de dictée expérimental et y a ajouté des modèles de langage n-grammes, pour que le reconnaisseur puisse deviner le mot suivant à partir des deux précédents. Bell Labs, de son côté, est passé d'une voix à plusieurs et a construit des reconnaisseurs qui fonctionnaient d'un locuteur à l'autre, ce qu'exigeaient les applications téléphoniques.
Dans les années 1980, les modèles de Markov cachés ont rendu la reconnaissance vocale statistique
Les années 1980 ont remplacé l'appariement de formes par les probabilités, et les vocabulaires sont passés de quelques centaines de mots à 20 000 en une décennie.
Comment entend un modèle de Markov caché
Un modèle de Markov caché ne cherche pas à faire correspondre un son à un gabarit. Il se demande quelle séquence de sons de parole a le plus probablement produit l'audio reçu, puis quelle séquence de mots a le plus probablement produit ces sons. L'entraînement sur de la parole enregistrée fixe les probabilités : plus de données, c'est un meilleur reconnaisseur, une propriété qui allait compter énormément avec l'arrivée d'internet. Combiné aux modèles de langage n-grammes, le HMM est devenu l'architecture de référence dans tous les laboratoires de recherche, et il y est resté jusqu'à ce que l'apprentissage profond le supplante en 2012.
Tangora, Sphinx et les premiers produits
Au milieu des années 1980, Tangora, chez IBM, reconnaissait un vocabulaire de 20 000 mots, à condition de marquer une pause entre les mots et d'entraîner le système sur chaque locuteur. En 1988, le système Sphinx de Kai-Fu Lee, à Carnegie Mellon, a été le premier à réunir grand vocabulaire, parole continue et indépendance vis-à-vis du locuteur dans un seul reconnaisseur. Dragon Systems, fondée par James et Janet Baker en 1982, a commencé à vendre des logiciels de reconnaissance pour ordinateurs personnels. La reconnaissance vocale est aussi entrée pour la première fois chez les particuliers : la poupée Julie de Worlds of Wonder répondait à une poignée de phrases en 1987, et les opérateurs téléphoniques testaient la numérotation vocale. Ces jouets étaient rudimentaires, mais ils ont fait entrer l'expression « reconnaissance vocale » dans les foyers.
Les années 1990 ont mis la reconnaissance vocale sur les PC
Des processeurs plus rapides ont transformé la dictée, jusque-là démonstration de laboratoire, en logiciel vendu en boîte, et un corpus de référence commun a rendu les progrès faciles à mesurer.
De Dragon Dictate à NaturallySpeaking
Dragon Dictate est sorti en 1990 pour environ 9 000 dollars. C'était le premier produit de reconnaissance vocale qu'un particulier pouvait acheter, et il imposait une pause après chaque mot. En 1997, Dragon NaturallySpeaking a supprimé la pause : il reconnaissait la parole continue à environ 100 mots par minute sur un PC familial, et IBM a répliqué la même année avec ViaVoice. Pour la première fois, un avocat, un médecin ou un écrivain pouvait parler à un ordinateur et obtenir un texte exploitable, à condition de l'entraîner et de le corriger.
Serveurs vocaux et premiers benchmarks
En 1996, BellSouth a lancé VAL, un portail vocal accessible par téléphone qui répondait à des questions parlées, et tous les serveurs vocaux contre lesquels vous avez pesté depuis en descendent. En coulisses, la DARPA et le National Institute of Standards and Technology organisaient des évaluations annuelles sur des enregistrements communs comme le corpus téléphonique Switchboard, et le taux d'erreur de mots est devenu le chiffre que chaque laboratoire publiait. À partir de là, l'histoire de la reconnaissance vocale est en grande partie celle de la chute de ce chiffre.
Les années 2000 ont envoyé la reconnaissance vocale dans le cloud
La précision a plafonné autour de 80 pour cent pendant l'essentiel de la décennie, jusqu'à ce que Google déplace la reconnaissance de l'appareil vers ses serveurs.
Le plateau
En 2001, les meilleurs systèmes transcrivaient la parole dictée avec une précision d'environ 80 pour cent, et les années suivantes ont apporté des raffinements plutôt que des bonds. La dictée sur ordinateur est restée une niche, les serveurs vocaux sont restés agaçants et les financements de la recherche se sont raréfiés. Le modèle de Markov caché approchait de son plafond, et les modèles appelés à le remplacer n'avaient pas encore la puissance de calcul ni les données dont ils avaient besoin.
Google Voice Search
Le service de renseignements téléphoniques GOOG-411 de Google, lancé en 2007, était un moyen de collecter des millions de requêtes parlées. En novembre 2008, l'entreprise a sorti Google Voice Search sous forme d'application iPhone, et la reconnaissance vocale a changé de forme : le téléphone se contentait d'enregistrer, et la reconnaissance tournait dans les centres de données de Google, sur des modèles bien plus gros que ce qu'un appareil pouvait contenir. Le système anglais de Google avait été entraîné sur 230 milliards de mots issus de requêtes de recherche, il pouvait donc prédire ce que les gens allaient probablement dire, et chaque nouvelle requête alimentait le modèle suivant. La reconnaissance est devenue un service plutôt qu'un programme, la forme qu'elle conserve encore aujourd'hui.