A história do
reconhecimento de fala

O reconhecimento de fala foi inventado na Bell Labs em 1952. Veja como ele foi de dez dígitos falados a 54+ idiomas, década a década.

Reconhecimento de fala em resumo

Invenção
O reconhecimento de fala foi inventado em 1952, quando o sistema Audrey, da Bell Labs, reconheceu os dígitos de 0 a 9 ditos por uma única voz.
Primeiro software comercial
O Dragon Dictate, lançado em 1990 por cerca de US$ 9.000, foi o primeiro produto de reconhecimento de fala vendido ao público, e exigia uma pausa depois de cada palavra.
Primeiras 1.000 palavras
Em 1976, o Harpy, da Carnegie Mellon, entendia 1.011 palavras, a meta que a DARPA havia fixado para os cinco anos do seu programa Speech Understanding Research.
Paridade humana
Em 2017, a Microsoft mediu uma taxa de erro de palavras de 5,1% no benchmark telefônico Switchboard, igualando os transcritores profissionais que trabalharam nas mesmas ligações.
Modelos abertos
O Whisper, da OpenAI, lançado em setembro de 2022, foi treinado com 680.000 horas de áudio e transcreve quase 100 idiomas, com os pesos publicados.
Hoje
O Sonix, fundado em 2017, transcreve 54+ idiomas com 99% de precisão e devolve um arquivo de uma hora em cerca de 5 a 6 minutos.

O reconhecimento de fala foi inventado em 1952

O primeiro reconhecedor de fala foi construído na Bell Labs em 1952 e entendia exatamente dez palavras: os dígitos de zero a nove.

Audrey, o reconhecedor automático de dígitos

K. H. Davis, R. Biddulph e S. Balashek construíram a Audrey com circuitos analógicos que ocupavam um rack de relés de quase dois metros. Uma pessoa dizia um dígito ao fone de um telefone, a máquina media os formantes das vogais e uma lâmpada acendia ao lado do dígito ouvido. Ajustada às vozes dos próprios projetistas, acertava de 97 a 99 por cento; com estranhos, desmoronava. A Audrey nunca saiu do laboratório, porque um operador humano discando números saía mais barato, mas encerrou a dúvida sobre se uma máquina era sequer capaz de ouvir.

O Shoebox da IBM e os anos 1960

Em 1962, a IBM demonstrou o Shoebox na Feira Mundial de Seattle. Ele reconhecia 16 palavras faladas, os dez dígitos e seis comandos aritméticos, e com elas operava uma máquina de somar. Ao longo da década, laboratórios nos Estados Unidos, na Grã-Bretanha, no Japão e na União Soviética construíram reconhecedores de vogais, consoantes e pequenas listas de palavras, e em 1968 Taras Vintsyuk descreveu o alinhamento temporal dinâmico (DTW), o método que permite a uma máquina comparar a mesma fala dita em velocidades diferentes. Em 1969, a área tinha ambição, mas não tinha teoria: John Pierce, da Bell Labs, comparou o campo a esquemas para transformar água em gasolina, e o laboratório cortou o financiamento por anos.

O programa Speech Understanding Research da DARPA levou os vocabulários além de 1.000 palavras

Entre 1971 e 1976, a DARPA financiou o maior esforço de reconhecimento de fala até então, e o Harpy, da Carnegie Mellon, alcançou a meta de 1.000 palavras.

A meta de cinco anos

O programa Speech Understanding Research pedia um sistema capaz de entender fala contínua de vários locutores, com um vocabulário de 1.000 palavras e menos de 10 por cento de erro, e pagou a Carnegie Mellon, a BBN, a SRI e outras instituições para competir. Três sistemas cruzaram a linha de chegada: o Hearsay-II e o Harpy, na Carnegie Mellon, e o HWIM, na BBN. O Harpy, concluído em 1976, entendia 1.011 palavras, mais ou menos o vocabulário de uma criança de três anos, e foi o único a cumprir a meta. O truque do Harpy era uma busca que descartava cedo as sequências de palavras improváveis em vez de pesar todas as possibilidades, uma ideia que continua no coração de todo decodificador.

A virada estatística

Os mesmos anos produziram a ideia que venceu todas as outras pelos 40 anos seguintes. Na Carnegie Mellon, a tese de James Baker, de 1975, descrevia o sistema DRAGON, que tratava a fala como um modelo oculto de Markov e deixava que as probabilidades, e não regras escritas à mão, decidissem quais palavras haviam sido ditas. Na IBM, o grupo de Fred Jelinek incorporou a mesma abordagem a um sistema de ditado experimental e acrescentou modelos de linguagem n-gram, para que o reconhecedor pudesse adivinhar a próxima palavra a partir das duas anteriores. A Bell Labs, enquanto isso, passou de uma voz para muitas e construiu reconhecedores que funcionavam com vários locutores, exigência das aplicações telefônicas.

Os modelos ocultos de Markov tornaram o reconhecimento de fala estatístico nos anos 1980

Os anos 1980 trocaram a comparação de padrões pela probabilidade, e os vocabulários passaram de algumas centenas de palavras para 20.000 em uma década.

Como um modelo oculto de Markov ouve

Um modelo oculto de Markov não tenta encaixar um som em um molde. Ele pergunta qual sequência de sons da fala mais provavelmente produziu o áudio recebido e, depois, qual sequência de palavras mais provavelmente produziu esses sons. O treinamento com fala gravada define as probabilidades, então mais dados significam um reconhecedor melhor, uma propriedade que passaria a importar enormemente quando a internet chegasse. Combinado com modelos de linguagem n-gram, o HMM virou a arquitetura padrão de todo laboratório de pesquisa e ali ficou até o aprendizado profundo o destronar em 2012.

Tangora, Sphinx e os primeiros produtos

O Tangora, da IBM, reconhecia um vocabulário de 20.000 palavras em meados dos anos 1980, embora exigisse pausa entre as palavras e treinamento para cada locutor. Em 1988, o sistema Sphinx, de Kai-Fu Lee, na Carnegie Mellon, foi o primeiro a reunir vocabulário grande, fala contínua e independência de locutor em um só reconhecedor. A Dragon Systems, fundada por James e Janet Baker em 1982, começou a vender software de reconhecimento para computadores pessoais. O reconhecimento de voz também chegou ao consumidor pela primeira vez: a boneca Julie, da Worlds of Wonder, respondia a um punhado de frases faladas em 1987, e as companhias telefônicas testaram a discagem por voz. Os brinquedos eram toscos, mas levaram a expressão "reconhecimento de voz" para dentro das casas comuns.

Os anos 1990 levaram o reconhecimento de fala aos computadores pessoais

Processadores mais rápidos transformaram o ditado de demonstração de laboratório em software de prateleira, e um benchmark compartilhado tornou o progresso fácil de medir.

Do Dragon Dictate ao NaturallySpeaking

O Dragon Dictate chegou às lojas em 1990 por cerca de US$ 9.000. Foi o primeiro produto de reconhecimento de fala que uma pessoa comum podia comprar, e exigia uma pausa depois de cada palavra. Em 1997, o Dragon NaturallySpeaking eliminou a pausa: reconhecia fala contínua a cerca de 100 palavras por minuto em um PC doméstico, e a IBM respondeu com o ViaVoice no mesmo ano. Pela primeira vez um advogado, um médico ou um escritor podia falar com o computador e obter um texto utilizável, desde que treinasse o programa e corrigisse o resultado.

Atendimento eletrônico e os primeiros benchmarks

Em 1996, a BellSouth lançou o VAL, um portal de voz por discagem que respondia a perguntas faladas, e todo atendimento eletrônico com o qual você já brigou desde então descende dele. Nos bastidores, a DARPA e o NIST, o instituto de padrões dos Estados Unidos, conduziam avaliações anuais com gravações compartilhadas, como o corpus telefônico Switchboard, e a taxa de erro de palavras virou o número que todo laboratório reportava. Daí em diante, a história do reconhecimento de fala é, em grande parte, a história desse número caindo.

Os anos 2000 levaram o reconhecimento de fala para a nuvem

A precisão ficou estagnada perto de 80 por cento durante a maior parte da década, até o Google tirar o reconhecimento do aparelho e levá-lo para seus servidores.

O platô

Em 2001, os melhores sistemas transcreviam fala ditada com cerca de 80 por cento de precisão, e os anos seguintes trouxeram refinamentos, não saltos. O ditado no desktop continuou um nicho, o atendimento eletrônico continuou irritante e o financiamento de pesquisa minguou. O modelo oculto de Markov estava perto do teto, e os modelos que o substituiriam ainda não tinham o poder computacional nem os dados de que precisavam.

Google Voice Search

O GOOG-411, serviço de auxílio à lista do Google lançado em 2007, era uma forma de coletar milhões de consultas faladas. Em novembro de 2008, a empresa lançou o Google Voice Search como aplicativo para iPhone, e o reconhecimento de fala mudou de forma: o celular apenas gravava, e o reconhecimento rodava nos data centers do Google, em modelos muito maiores do que qualquer aparelho conseguiria armazenar. O sistema em inglês do Google foi treinado com 230 bilhões de palavras de consultas de busca, então conseguia prever o que as pessoas tendiam a dizer, e cada nova consulta alimentava o modelo seguinte. O reconhecimento virou serviço, não programa, e é assim até hoje.
Cronologia

Marcos do reconhecimento de fala,
ano a ano

Todos os eventos abaixo têm data. As seções em torno desta tabela explicam por que cada um foi importante.

AnoMarcoPor que importou
1952A Bell Labs constrói a AudreyA primeira máquina a reconhecer fala: os dígitos de 0 a 9 de um único locutor
1962A IBM demonstra o Shoebox16 palavras, mostradas ao público na Feira Mundial de Seattle
1971A DARPA inicia o programa Speech Understanding ResearchCinco anos de financiamento e uma meta de 1.000 palavras
1976O Harpy, da Carnegie Mellon, bate a meta1.011 palavras, com uma busca podada que os decodificadores ainda usam
1986O Tangora, da IBM, chega a 20.000 palavrasModelos ocultos de Markov e modelos de linguagem n-gram viram o padrão
1988Sphinx na Carnegie MellonReconhecimento contínuo, independente de locutor e de vocabulário amplo em um só sistema
1990O Dragon Dictate é lançadoO primeiro produto de reconhecimento de fala vendido ao consumidor
1997Dragon NaturallySpeaking e IBM ViaVoiceDitado contínuo em um PC doméstico a cerca de 100 palavras por minuto
2008Google Voice SearchO reconhecimento vai para a nuvem e aprende com cada consulta
2011A Apple lança a SiriUm assistente de voz em um celular popular
2012Redes neurais profundas substituem as misturas de gaussianasAs taxas de erro caem até um terço de uma só vez
2016A Microsoft reporta 5,9% no SwitchboardA primeira alegação de paridade humana em um benchmark de conversação
2017Microsoft 5,1%, IBM 5,5%, Google 4,9%; o Transformer é publicadoA corrida pela paridade termina e a próxima arquitetura chega
2020wav2vec 2.0 e o ConformerO aprendizado autossupervisionado reduz a necessidade de dados rotulados
2022A OpenAI lança o Whisper680.000 horas de treinamento, quase 100 idiomas, pesos abertos

O aprendizado profundo cortou as taxas de erro em mais da metade nos anos 2010

Entre 2011 e 2017, a taxa de erro de palavras em conversas telefônicas caiu de pouco mais de 10 por cento para cerca de 5 por cento, e os assistentes de voz entraram nas casas.

A Siri e os assistentes

A Apple lançou a Siri com o iPhone 4S em outubro de 2011, e pela primeira vez um celular popular vinha com um assistente de voz atrás do botão home. A Amazon veio em seguida com a Alexa no Echo, em 2014, e o Google com o Google Home, em 2016. Os assistentes importaram menos pelo reconhecimento em si, que rodava na nuvem como o Google Voice Search, do que pelo hábito que criaram: centenas de milhões de pessoas passaram a falar com máquinas todos os dias, e cada frase dita virou dado de treinamento.

O salto das redes neurais

Em 2012, pesquisadores da Microsoft, do Google, da IBM e da Universidade de Toronto, Geoffrey Hinton entre eles, publicaram um artigo conjunto mostrando que redes neurais profundas treinadas no lado acústico do problema reduziam as taxas de erro em até um terço em comparação com os modelos de mistura de gaussianas que os sistemas HMM usavam havia 25 anos. O Deep Speech, da Baidu, foi além em 2014 e treinou uma única rede recorrente de ponta a ponta, do áudio aos caracteres, sem dicionário de pronúncia e sem pipeline montado à mão. O reconhecimento virou um problema de aprendizado profundo, e os laboratórios com mais GPUs e mais dados dispararam na frente.

A corrida pela paridade humana

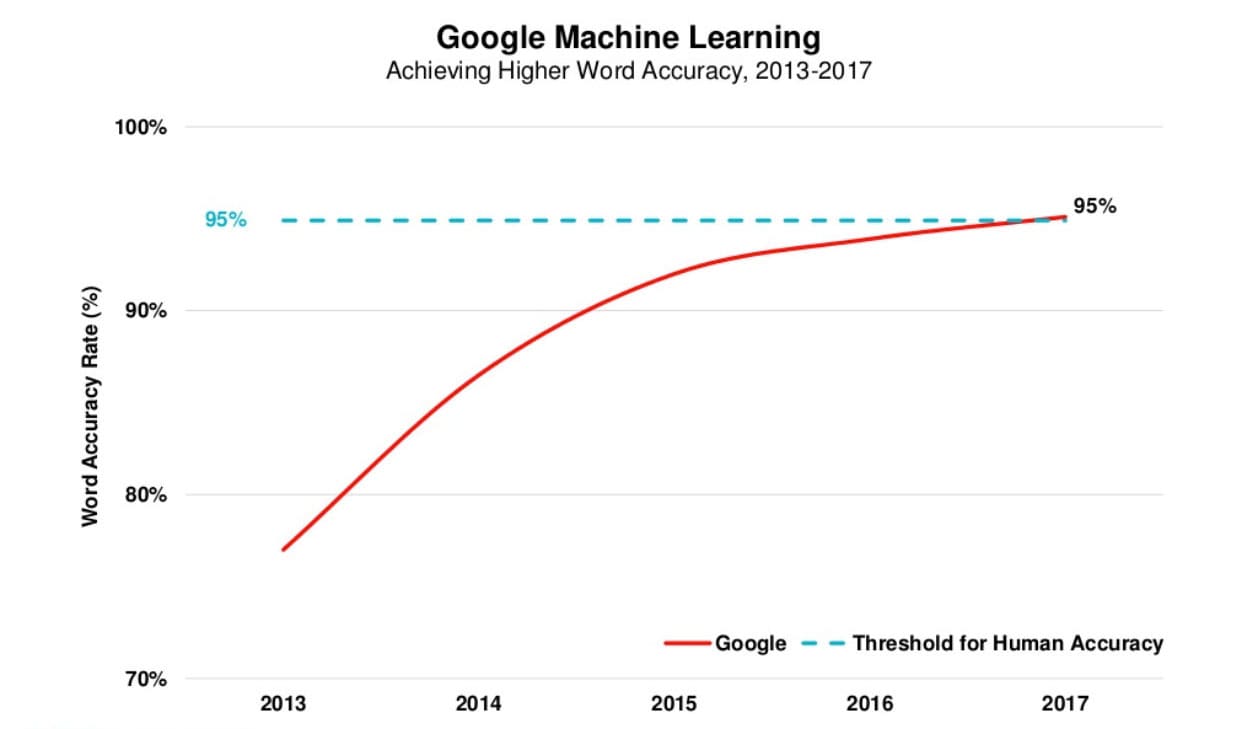
O benchmark Switchboard, um conjunto de conversas telefônicas gravadas, virou o placar. Em outubro de 2016, a Microsoft reportou 5,9 por cento de taxa de erro de palavras, o mesmo índice dos transcritores profissionais que contratou para trabalhar nas mesmas ligações, e chamou isso de paridade humana. A IBM respondeu com 5,5 por cento em março de 2017, o Google anunciou 4,9 por cento em seus próprios conjuntos de teste em maio, e em agosto de 2017 a Microsoft chegou a 5,1 por cento contra uma medição mais cuidadosa da referência humana. O gráfico abaixo, do relatório Internet Trends 2017 de Mary Meeker, mostra a precisão de palavras do Google cruzando a marca de 95 por cento que o setor tratava como o limiar humano. No mesmo ano, a arquitetura Transformer foi publicada para tradução automática, e em três anos ela havia tomado conta da fala também.

Gráfico da taxa de precisão de palavras do Google ultrapassando 95 por cento, do relatório Internet Trends 2017 de Mary Meeker

O Whisper e o Transformer transformaram a transcrição em commodity

O treinamento autossupervisionado e um modelo aberto transformaram a transcrição multilíngue precisa, antes um privilégio das big techs, em algo que qualquer produto pode oferecer.

Aprender com áudio não rotulado

O gargalo dos anos 2010 eram os dados rotulados: cada hora de treinamento precisava de uma transcrição humana. Em 2020, o wav2vec 2.0, da Facebook AI, aprendeu representações da fala primeiro a partir de áudio bruto, sem transcrição, e precisou de apenas dez minutos de fala rotulada para fazer o ajuste fino de um reconhecedor utilizável. O Conformer, do Google, publicado no mesmo ano, combinou convolução com a atenção do Transformer e estabeleceu novos recordes nos benchmarks padrão. Juntos, eles fizeram do Transformer a arquitetura padrão para fala e reduziram o custo de acrescentar um novo idioma.

Whisper

Em setembro de 2022, a OpenAI lançou o Whisper, treinado com 680.000 horas de áudio coletadas da web, cobrindo quase 100 idiomas, com os pesos do modelo publicados para quem quisesse rodá-lo. Não era o sistema mais preciso em todos os benchmarks, mas era robusto a sotaques, ruído de fundo e vocabulário técnico de um jeito que os modelos acadêmicos anteriores não eram, e era gratuito. Em poucos meses estava dentro de milhares de produtos, e a pergunta para as empresas de transcrição deixou de ser se conseguiam reconhecer a fala e passou a ser o que construíam em torno da transcrição.

O que isso significa para você hoje

Uma gravação de uma hora enviada ao Sonix volta como transcrição em cerca de 5 a 6 minutos, com identificação de falantes, marcadores de tempo e 99% de precisão em áudio limpo, em qualquer um dos 54+ idiomas. O Sonix foi fundado em 2017, o ano da corrida pela paridade humana, e acompanhou cada passo desde então: os modelos melhoram a cada ano, e o trabalho agora vai para o editor, os resumos, as traduções e as exportações que tornam uma transcrição útil. As sete décadas acima explicam por que uma primeira transcrição hoje não custa nada: seus primeiros 30 minutos são gratuitos.

A identificação automática de idioma tem história própria

Saber qual idioma está sendo falado é um problema diferente de saber quais palavras foram ditas, e levou seus próprios 50 anos para ser resolvido.

Da estatística de fonemas aos i-vectors

Os primeiros experimentos de identificação de idioma, nos anos 1970, tentavam distinguir as línguas pela estatística de seus sons, partindo da teoria de que cada idioma usa uma mistura diferente de fonemas em frequências diferentes. Nos anos 1990, isso virou a abordagem fonotática: rodar um reconhecedor de fonemas e então verificar com os padrões de fonemas de qual idioma o resultado combina melhor. O NIST, o instituto de padrões dos Estados Unidos, começou as avaliações formais de reconhecimento de idioma em 1996, e a cultura de benchmarks que impulsionou o reconhecimento de fala impulsionou também a identificação de idioma. Nos anos 2010, o i-vector, um resumo compacto e de tamanho fixo de uma gravação, emprestado do reconhecimento de locutor, produziu sistemas capazes de nomear um idioma a partir de poucos segundos de áudio.

Embutida no modelo

Os reconhecedores multilíngues modernos fundem os dois problemas. O Whisper e seus sucessores preveem o idioma como o primeiro token da transcrição, de modo que a identificação é um subproduto do reconhecimento, e não uma etapa separada. É isso que permite a um único produto lidar com 54+ idiomas sem um reconhecedor separado para cada um, e é por isso que o idioma que você fala deixou de ser um limite para o que você pode transcrever.

O que vem a seguir: a voz vira a interface

A tecnologia necessária para aplicações de voz agora é barata e precisa, e a pergunta deixou de ser se as máquinas conseguem ouvir e passou a ser o que devem fazer com o que ouvem.

Produtos voice-first

Os dispositivos voice-first, das caixas de som inteligentes aos fones de ouvido e aos carros, tornaram banal falar com uma máquina, e a precisão que levou 70 anos para ser alcançada agora é um pressuposto, não um diferencial. A linguagem é a única interface que quase todas as pessoas já têm, e é por isso que uma pequena melhoria no reconhecimento alcança mais gente do que qualquer tela nova conseguiria. As empresas que constroem sobre a voz desde cedo tendem a manter a dianteira, como fizeram as empresas mobile-first dos anos 2010.

Além da transcrição

A transcrição em si virou a matéria-prima. Os grandes modelos de linguagem resumem reuniões, respondem a perguntas sobre uma entrevista, traduzem uma palestra e redigem o e-mail de acompanhamento a partir dela, e fazem tudo isso bem apenas porque a transcrição por baixo é precisa. No Sonix, o trabalho é esse: o reconhecimento é a fundação erguida por todos os que foram citados acima, e o produto é o que você consegue fazer com as palavras depois que elas existem.

Perguntas frequentes

História do reconhecimento de fala,
as dúvidas respondidas

Quando e onde o reconhecimento de fala foi inventado?

Em 1952. O sistema Audrey, da Bell Labs, construído por K. H. Davis, R. Biddulph e S. Balashek, reconhecia os dígitos falados de 0 a 9 de um único locutor. O Shoebox, da IBM, veio em 1962 com 16 palavras, e o primeiro produto que você podia comprar, o Dragon Dictate, chegou em 1990.

Quem inventou o reconhecimento de fala?

Ninguém sozinho. Três engenheiros da Bell Labs construíram o primeiro reconhecedor, a Audrey, em 1952. James Baker e Fred Jelinek tornaram o reconhecimento estatístico com modelos ocultos de Markov nos anos 1970, o Sphinx de Kai-Fu Lee o tornou contínuo e independente de locutor em 1988, e os colaboradores de Geoffrey Hinton trouxeram o aprendizado profundo para a área em 2012.

Qual foi o primeiro software de reconhecimento de fala?

O Dragon Dictate, lançado pela Dragon Systems em 1990 por cerca de US$ 9.000, foi o primeiro software de reconhecimento de fala vendido ao público. Exigia uma pausa entre as palavras. O Dragon NaturallySpeaking, lançado em 1997, foi o primeiro produto de ditado de fala contínua para computadores domésticos.

Reconhecimento de fala ou de voz: qual é a diferença?

O reconhecimento de fala identifica as palavras que foram ditas. O reconhecimento de voz identifica quem as disse a partir das características da voz, que é como um celular se desbloqueia para o dono. No dia a dia, os termos se confundem à vontade. Este artigo é sobre reconhecer palavras, a tecnologia por trás da transcrição, do ditado e dos assistentes de voz.

O reconhecimento de fala é uma forma de IA?

Sim. Desde 2012, todo reconhecedor de fala competitivo é uma rede neural profunda treinada com grandes volumes de áudio, a mesma família de métodos por trás dos grandes modelos de linguagem. Antes disso, os modelos ocultos de Markov também eram uma forma de aprendizado de máquina: aprendiam probabilidades a partir de fala gravada em vez de seguir regras escritas à mão.

Qual é a precisão do reconhecimento de fala hoje?

Em gravações de conversas com áudio limpo, os melhores sistemas igualam transcritores profissionais: a Microsoft mediu uma taxa de erro de palavras de 5,1% no benchmark Switchboard em 2017, e os modelos melhoraram desde então. O Sonix chega a 99% de precisão em áudio de boa qualidade. Sotaques fortes, falas sobrepostas e ruído de fundo ainda elevam a taxa de erro, e é por isso que toda transcrição vem com um editor.

Comece agora

Experimente o Sonix gratuitamente

O Sonix transcreve, gera carimbos de data/hora e organiza seus arquivos de áudio e vídeo para que você possa pesquisar, editar e compartilhar sua mídia.

Inclui 30 minutes minutos de transcrição gratuita

Continue lendo

99% de precisão. Cada palavra importa.

Transcrição e tradução por IA em 54+ idiomas.

30 minutes grátis
Sem cartão de crédito
Cancele a qualquer momento