 Stephen Hopkins
Bir bakışta konuşma tanıma
- İcadı
- Konuşma tanıma 1952'de, Bell Labs'in Audrey sistemi tek bir sesin söylediği 0'dan 9'a kadar rakamları tanıdığında icat edildi.
- İlk tüketici yazılımı
- 1990'da yaklaşık 9.000 dolara piyasaya çıkan Dragon Dictate, halka satılan ilk konuşma tanıma ürünüydü ve her kelimeden sonra duraklama gerektiriyordu.
- İlk 1.000 kelimelik dağarcık
- Carnegie Mellon'un Harpy sistemi 1976'da 1.011 kelime anlıyordu ve DARPA'nın beş yıllık Konuşma Anlama Araştırması programı için koyduğu hedefi tutturmuştu.
- İnsan düzeyi
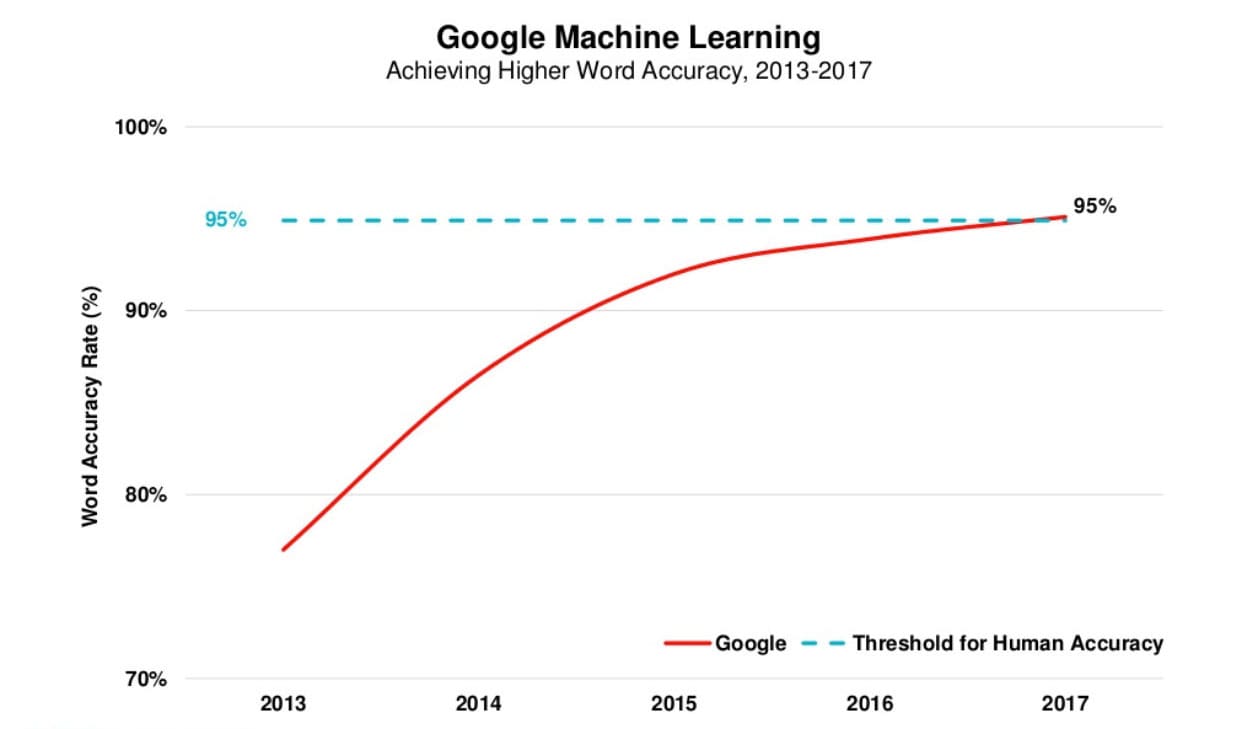
- Microsoft 2017'de Switchboard telefon kıyaslamasında %5,1 kelime hata oranı ölçtü; bu, aynı görüşmeleri yazıya döken profesyonel deşifre uzmanlarıyla aynı düzeydi.
- Açık modeller
- OpenAI'ın Eylül 2022'de yayımladığı Whisper 680.000 saatlik ses kaydıyla eğitildi; ağırlıkları herkese açık ve 100'e yakın dili deşifre edebiliyor.
- Bugün
- 2017 yılında kurulan Sonix, 54+ dili 99% doğrulukla deşifre ediyor ve bir saatlik dosyayı yaklaşık 5 ila 6 dakikada teslim ediyor.
Konuşma tanıma 1952'de icat edildi
İlk konuşma tanıyıcı 1952'de Bell Labs'te yapıldı ve tam olarak on kelime anlıyordu: sıfırdan dokuza kadar rakamlar.
Audrey, Otomatik Rakam Tanıyıcı
K. H. Davis, R. Biddulph ve S. Balashek, Audrey'yi yaklaşık iki metrelik bir röle rafını dolduran analog devrelerden yaptı. Konuşmacı telefon ahizesine bir rakam söylüyor, makine ünlü formantlarını ölçüyor ve duyduğu rakamın yanındaki lamba yanıyordu. Tasarımcılarının sesine ayarlandığında yüzde 97 ile 99 arasında başarı gösteriyor, yabancı seslerde ise sınıfta kalıyordu. Numaraları çeviren bir insan operatör daha ucuza geldiği için Audrey laboratuvardan hiç çıkmadı; ama bir makinenin duyup duyamayacağı sorusunu kesin olarak yanıtladı.
IBM'in Shoebox'ı ve 1960'lar
IBM, 1962'de Shoebox'ı Seattle Dünya Fuarı'nda sergiledi. Sistem 16 sözlü kelimeyi, yani on rakamla altı aritmetik komutu tanıyor ve bunlarla bir toplama makinesini çalıştırıyordu. On yıl boyunca ABD, İngiltere, Japonya ve Sovyetler Birliği'ndeki laboratuvarlar ünlüler, ünsüzler ve küçük kelime listeleri için tanıyıcılar geliştirdi; 1968'de Taras Vintsyuk, makinenin farklı hızlarda söylenmiş konuşmaları karşılaştırmasını sağlayan hizalama yöntemi dinamik zaman bükmeyi tanımladı. 1969'a gelindiğinde alanın hırsı vardı ama kuramı yoktu: Bell Labs'ten John Pierce bunu suyu benzine çevirme planlarına benzetti ve laboratuvar yıllarca bu işe para ayırmadı.
DARPA'nın Konuşma Anlama Araştırması programıyla kelime dağarcıkları 1.000 kelimeyi aştı
DARPA 1971 ile 1976 arasında o güne kadarki en büyük konuşma tanıma çalışmasını finanse etti ve Carnegie Mellon'un Harpy sistemi 1.000 kelimelik hedefe ulaştı.
Beş yıllık hedef
Konuşma Anlama Araştırması programı, birden çok konuşmacının bağlantılı konuşmasını 1.000 kelimelik bir dağarcıkta yüzde 10'un altında hatayla anlayabilen bir sistem istiyor ve yarışmaları için Carnegie Mellon, BBN, SRI ve başkalarına para ödüyordu. Bitiş çizgisine üç sistem ulaştı: Carnegie Mellon'daki Hearsay-II ile Harpy ve BBN'deki HWIM. 1976'da tamamlanan Harpy, kabaca üç yaşındaki bir çocuğun dağarcığı kadar, 1.011 kelime anlıyordu ve hedefi tutturan tek sistem oldu. Püf noktası, her olasılığı tartmak yerine düşük olasılıklı kelime dizilerini erkenden budayan bir aramaydı; bu fikir bugün de her kod çözücünün kalbinde yer alıyor.
İstatistiksel dönemeç
Aynı yıllar, sonraki 40 yıl boyunca diğer her şeyi geride bırakacak fikri de doğurdu. Carnegie Mellon'da James Baker'ın 1975 tarihli tezi, konuşmayı bir saklı Markov modeli olarak ele alan ve hangi kelimelerin söylendiğine elle yazılmış kurallar yerine olasılıkların karar vermesini sağlayan DRAGON sistemini tanımlıyordu. IBM'de Fred Jelinek'in ekibi aynı yaklaşımı bir araştırma amaçlı dikte sistemine yerleştirdi ve n-gram dil modelleri ekledi; böylece tanıyıcı, son iki kelimeye bakarak bir sonrakini tahmin edebiliyordu. Bu arada Bell Labs tek sesten çok sese geçti ve telefon uygulamalarının gerektirdiği, konuşmacıdan bağımsız çalışan tanıyıcılar geliştirdi.
Saklı Markov modelleri 1980'lerde konuşma tanımayı istatistiksel hale getirdi
1980'ler örüntü eşlemenin yerine olasılığı koydu ve kelime dağarcıkları on yılda birkaç yüz kelimeden 20.000'e çıktı.
Saklı Markov modeli nasıl duyar
Saklı Markov modeli bir sesi bir şablonla eşleştirmeye çalışmaz. Önce aldığı ses kaydını en büyük olasılıkla hangi konuşma sesi dizisinin ürettiğini, sonra o sesleri en büyük olasılıkla hangi kelime dizisinin ürettiğini sorar. Olasılıklar kayıtlı konuşmayla yapılan eğitimle belirlenir; yani daha çok veri daha iyi tanıyıcı demektir ve internet geldiğinde bu özellik muazzam önem kazanacaktı. HMM, n-gram dil modelleriyle birleşince her araştırma laboratuvarında standart mimari haline geldi ve 2012'de derin öğrenme onu tahtından edene kadar orada kaldı.
Tangora, Sphinx ve ilk ürünler
IBM'in Tangora sistemi 1980'lerin ortasında 20.000 kelimelik bir dağarcığı tanıyordu; gerçi kelimeler arasında duraklama ve her konuşmacı için ayrı eğitim gerektiriyordu. 1988'de Kai-Fu Lee'nin Carnegie Mellon'daki Sphinx sistemi, geniş dağarcığı, sürekli konuşmayı ve konuşmacıdan bağımsızlığı tek bir tanıyıcıda birleştiren ilk sistem oldu. James ve Janet Baker'ın 1982'de kurduğu Dragon Systems, kişisel bilgisayarlar için tanıma yazılımı satmaya başladı. Ses tanıma da ilk kez tüketiciye ulaştı: Worlds of Wonder'ın Julie bebeği 1987'de birkaç sözlü ifadeye yanıt veriyordu, telefon şirketleri ise sesle aramayı denemeye başlamıştı. Oyuncaklar kabaydı ama "ses tanıma" ifadesini sıradan evlere soktu.
1990'lar konuşma tanımayı kişisel bilgisayarlara taşıdı
Daha hızlı işlemciler dikteyi laboratuvar gösterisinden raflarda satılan yazılıma dönüştürdü; ortak bir kıyaslama seti de ilerlemeyi ölçmeyi kolaylaştırdı.
Dragon Dictate'ten NaturallySpeaking'e
Dragon Dictate 1990'da yaklaşık 9.000 dolara piyasaya çıktı. Sıradan bir kullanıcının satın alabildiği ilk konuşma tanıma ürünüydü ve her kelimeden sonra duraklama istiyordu. 1997'de Dragon NaturallySpeaking bu duraklamayı ortadan kaldırdı: ev bilgisayarında sürekli konuşmayı dakikada yaklaşık 100 kelime hızında tanıyordu; IBM de aynı yıl ViaVoice ile karşılık verdi. Bir avukat, bir doktor ya da bir yazar ilk kez bilgisayarla konuşup, onu eğitmek ve düzeltmek koşuluyla, işe yarar bir metin elde edebiliyordu.
Telefon menüleri ve ilk kıyaslamalar
BellSouth 1996'da sözlü soruları yanıtlayan, telefonla aranan bir ses portalı olan VAL'ı hizmete aldı; o günden beri tartıştığınız her otomatik telefon sistemi onun soyundan geliyor. Perde arkasında DARPA ile Ulusal Standartlar ve Teknoloji Enstitüsü, Switchboard telefon derlemi gibi ortak kayıtlar üzerinde yıllık değerlendirmeler yapıyordu ve kelime hata oranı her laboratuvarın raporladığı sayı haline geldi. O andan itibaren konuşma tanımanın tarihi, büyük ölçüde bu sayının düşüşünün tarihidir.
2000'ler konuşma tanımayı buluta taşıdı
Doğruluk on yılın büyük bölümünde yüzde 80 civarında takılı kaldı; ta ki Google tanımayı cihazdan alıp kendi sunucularına taşıyana kadar.
Durgunluk
2001'e gelindiğinde en iyi sistemler dikte edilen konuşmayı kabaca yüzde 80 doğrulukla yazıya döküyordu; sonraki yıllar sıçrama değil, ince ayar getirdi. Masaüstü dikte niş bir alan olarak kaldı, telefon menüleri sinir bozucu olmaya devam etti, araştırma fonları da azaldı. Saklı Markov modeli tavanına yaklaşmıştı; yerini alacak modellerin ise ihtiyaç duydukları işlem gücü ve veri henüz ortada yoktu.
Google Voice Search
Google'ın 2007'de başlattığı GOOG-411 rehber servisi, milyonlarca sözlü sorgu toplamanın bir yoluydu. Şirket Kasım 2008'de Google Voice Search'ü iPhone uygulaması olarak yayımladı ve konuşma tanıma biçim değiştirdi: telefon yalnızca kayıt yapıyor, tanıma ise Google'ın veri merkezlerinde, hiçbir cihaza sığmayacak kadar büyük modeller üzerinde çalışıyordu. Google'ın İngilizce sistemi 230 milyar kelimelik arama sorgusuyla eğitilmişti; bu sayede insanların ne söyleme ihtimalinin yüksek olduğunu tahmin edebiliyordu ve her yeni sorgu bir sonraki modeli besliyordu. Tanıma bir programdan çok bir hizmete dönüştü; bugün de bu biçimini koruyor.