语音识别
发展史

1952 年,语音识别在贝尔实验室诞生。从最初只能听懂十个口述数字,到如今支持 54+ 种语言,本文按年代为您逐一梳理。

语音识别一览

诞生
语音识别诞生于 1952 年:贝尔实验室的 Audrey 系统能识别单一说话人念出的 0 到 9 十个数字。
首款消费级软件
1990 年上市的 Dragon Dictate 售价约 9,000 美元,是第一款面向公众销售的语音识别产品,用户每说一个词都得停顿一下。
首次听懂 1,000 个词
1976 年,卡内基梅隆大学的 Harpy 能听懂 1,011 个词,正是 DARPA 为其五年期语音理解研究计划定下的目标。
与人类持平
2017 年,Microsoft 在 Switchboard 电话语音基准上测得 5.1% 的词错误率,与转录同一批通话的专业转录员打成平手。
开放模型
OpenAI 于 2022 年 9 月发布的 Whisper 以 680,000 小时音频训练而成,能转录近 100 种语言,模型权重公开。
今天
Sonix 创立于 2017 年,支持 54+ 种语言,准确率达 99%,一小时的文件约 5 到 6 分钟即可转录完成。

语音识别诞生于 1952 年

第一台语音识别机 1952 年诞生于贝尔实验室,它只听得懂十个词:从零到九的数字。

Audrey:自动数字识别器

K. H. Davis、R. Biddulph 和 S. Balashek 用模拟电路搭建了 Audrey,整套设备装满了一个六英尺高的继电器机架。说话人对着电话听筒念出一个数字,机器测量元音的共振峰,听到哪个数字,旁边的指示灯就会亮起。按设计者本人的声音调校后,识别率可达 97% 到 99%;换成陌生人就基本失灵。Audrey 从未走出实验室,因为让接线员拨号更便宜,但它回答了一个根本问题:机器到底能不能听懂人说话。

IBM Shoebox 与 1960 年代

1962 年,IBM 在西雅图世界博览会上展示了 Shoebox。它能识别 16 个口述词,也就是十个数字和六个算术指令,并用它们驱动一台加法机。整个 1960 年代,美国、英国、日本和苏联的实验室陆续造出了识别元音、辅音和小词表的机器;1968 年,Taras Vintsyuk 提出了动态时间规整,这种对齐方法让机器可以比较语速不同的语音。到 1969 年,这个领域雄心有余而理论不足:贝尔实验室的 John Pierce 把它比作把水变成汽油那类把戏,贝尔实验室随后多年不再资助这项研究。

DARPA 的语音理解研究计划把词汇量推过了 1,000 词

1971 至 1976 年,DARPA 资助了当时规模最大的语音识别研究,卡内基梅隆大学的 Harpy 达成了 1,000 词的目标。

五年目标

语音理解研究计划要求做出这样一套系统:能听懂多位说话人的连续语音,词汇量 1,000 词,错误率低于 10%;DARPA 出资让卡内基梅隆大学、BBN、SRI 等机构同台竞争。三套系统跑到了终点:卡内基梅隆大学的 Hearsay-II 和 Harpy,以及 BBN 的 HWIM。1976 年完成的 Harpy 能听懂 1,011 个词,大致相当于三岁孩子的词汇量,也是唯一达标的系统。它的诀窍在于搜索时尽早剪掉不太可能的词序列,而不是逐一权衡所有可能,这个思路至今仍是每一个解码器的核心。

统计方法的转向

同一时期还诞生了此后 40 年间无人能敌的思路。在卡内基梅隆大学,James Baker 1975 年的博士论文描述了 DRAGON 系统,它把语音当作隐马尔可夫模型来处理,让概率而非手写规则来判断说了哪些词。在 IBM,Fred Jelinek 的团队把同样的方法做进了一套研究用听写系统,并加入 n-gram 语言模型,识别器因此可以根据前两个词猜测下一个词。与此同时,贝尔实验室从单一说话人转向多人,造出了能跨说话人工作的识别器,这正是电话应用所需要的。

1980 年代,隐马尔可夫模型让语音识别走向统计化

1980 年代用概率取代了模式匹配,词汇量在十年间从几百个词增长到 20,000 个。

隐马尔可夫模型如何“听”

隐马尔可夫模型并不试图把声音和模板逐一比对。它问的是:哪一串音素最有可能产生收到的这段音频,然后哪一串词最有可能产生这串音素。概率由录音语料训练得出,所以数据越多,识别器就越好,这一特性在互联网到来之后变得举足轻重。隐马尔可夫模型与 n-gram 语言模型结合,成为每一个研究实验室的标准架构,直到 2012 年被深度学习取代。

Tangora、Sphinx 与第一批产品

到 1980 年代中期,IBM 的 Tangora 已能识别 20,000 词的词汇量,不过它要求词与词之间停顿,还得针对每位说话人单独训练。1988 年,李开复 (Kai-Fu Lee) 在卡内基梅隆大学开发的 Sphinx 系统首次把大词汇量、连续语音和说话人无关三者集于一台识别器。James Baker 和 Janet Baker 于 1982 年创立的 Dragon Systems 开始销售面向个人电脑的识别软件。语音识别也第一次走进了消费者的生活:1987 年,Worlds of Wonder 的 Julie 玩偶能回应几句口语,电话公司也开始试用语音拨号。这些玩具很粗糙,却把“语音识别”这个说法带进了寻常人家。

1990 年代,语音识别登上个人电脑

更快的处理器让听写从实验室演示变成了盒装软件,一套共同的基准也让进展变得容易衡量。

Dragon Dictate 到 NaturallySpeaking

Dragon Dictate 于 1990 年上市,售价约 9,000 美元。它是第一款普通公众能买到的语音识别产品,但要求每说一个词就停顿一下。1997 年,Dragon NaturallySpeaking 去掉了这个停顿:它能在家用 PC 上识别连续语音,速度约为每分钟 100 词,同年 IBM 以 ViaVoice 应战。律师、医生或作家第一次可以对着电脑说话并得到可用的文字,前提是先训练它,再逐一纠错。

电话语音菜单与最早的基准

1996 年,BellSouth 推出了 VAL,一个能回答口头提问的拨入式语音门户,此后您与之周旋过的每一套自动电话系统都是它的后代。在幕后,DARPA 和美国国家标准与技术研究院每年在 Switchboard 电话语料库等共享录音上组织评测,词错误率成了每个实验室都要汇报的数字。从那时起,语音识别的历史很大程度上就是这个数字不断下降的历史。

2000 年代,语音识别搬上了云端

这十年的大部分时间里,准确率停在 80% 左右,直到 Google 把识别从设备搬到了自己的服务器上。

平台期

到 2001 年,最好的系统转录听写语音的准确率约为 80%,之后几年带来的是修修补补,而非飞跃。桌面听写始终是小众市场,电话语音菜单依旧让人恼火,研究经费也日渐减少。隐马尔可夫模型已接近天花板,而将要取代它的模型还没有等来所需的算力和数据。

Google Voice Search

Google 2007 年推出的 GOOG-411 号码查询服务,其实是一种收集数百万条口语查询的手段。2008 年 11 月,该公司以 iPhone 应用的形式发布了 Google Voice Search,语音识别的形态从此改变:手机只负责录音,识别则在 Google 的数据中心里运行,模型规模远超任何设备所能容纳。Google 的英语系统用 2300 亿词的搜索查询训练而成,因此能预测人们可能会说什么,而每一条新查询又都喂给了下一代模型。识别从一个程序变成了一项服务,至今仍是这个形态。
时间线

语音识别里程碑, 逐年梳理

下表每一条都标注了年份。表格前后的章节会解释它们各自为何重要。

年份里程碑为何重要
1952贝尔实验室造出 Audrey第一台能识别语音的机器:单一说话人的 0 到 9
1962IBM 展示 Shoebox16 个词,在西雅图世界博览会上公开亮相
1971DARPA 启动语音理解研究计划五年资助,目标 1,000 词
1976卡内基梅隆大学的 Harpy 达标1,011 个词,剪枝搜索沿用至今
1986IBM 的 Tangora 达到 20,000 词隐马尔可夫模型和 n-gram 语言模型成为标准
1988卡内基梅隆大学的 Sphinx连续语音、说话人无关、大词汇量,三者合一
1990Dragon Dictate 上市第一款面向消费者销售的语音识别产品
1997Dragon NaturallySpeaking 与 IBM ViaVoice家用 PC 上的连续听写,约每分钟 100 词
2008Google Voice Search识别搬上云端,从每一条查询中学习
2011Apple 推出 Siri主流手机内置语音助手
2012深度神经网络取代高斯混合模型错误率一步下降最多三分之一
2016Microsoft 在 Switchboard 报告 5.9%首次在会话基准上宣称达到人类水平
2017Microsoft 5.1%、IBM 5.5%、Google 4.9%;Transformer 发表人类水平之争落幕,下一代架构登场
2020wav2vec 2.0 与 Conformer自监督学习减少了对标注数据的依赖
2022OpenAI 发布 Whisper680,000 小时训练数据,近 100 种语言,权重开放

2010 年代,深度学习让错误率下降过半

2011 至 2017 年,会话电话语音的词错误率从百分之十几降到了 5% 左右,语音助手也走进了家庭。

Siri 与语音助手

2011 年 10 月,Apple 随 iPhone 4S 推出了 Siri,主流手机第一次在 Home 键背后装上了语音助手。Amazon 于 2014 年在 Echo 上推出 Alexa,Google 则于 2016 年推出 Google Home。这些助手的意义不在识别本身(它们和 Google Voice Search 一样在云端运行),而在于它们培养出的习惯:数亿人开始每天和机器说话,每一句话都成了训练数据。

神经网络这一步

2012 年,来自 Microsoft、Google、IBM 和多伦多大学的研究人员(其中包括 Geoffrey Hinton)联合发表论文,证明在声学建模这一侧用深度神经网络训练,错误率比 HMM 系统沿用了 25 年的高斯混合模型最多可降低三分之一。2014 年,百度的 Deep Speech 更进一步,端到端训练单个循环神经网络,从音频直接输出字符,不需要发音词典,也不需要手工搭建的流水线。语音识别成了一个深度学习问题,GPU 和数据最多的实验室由此领先。

向人类水平冲刺

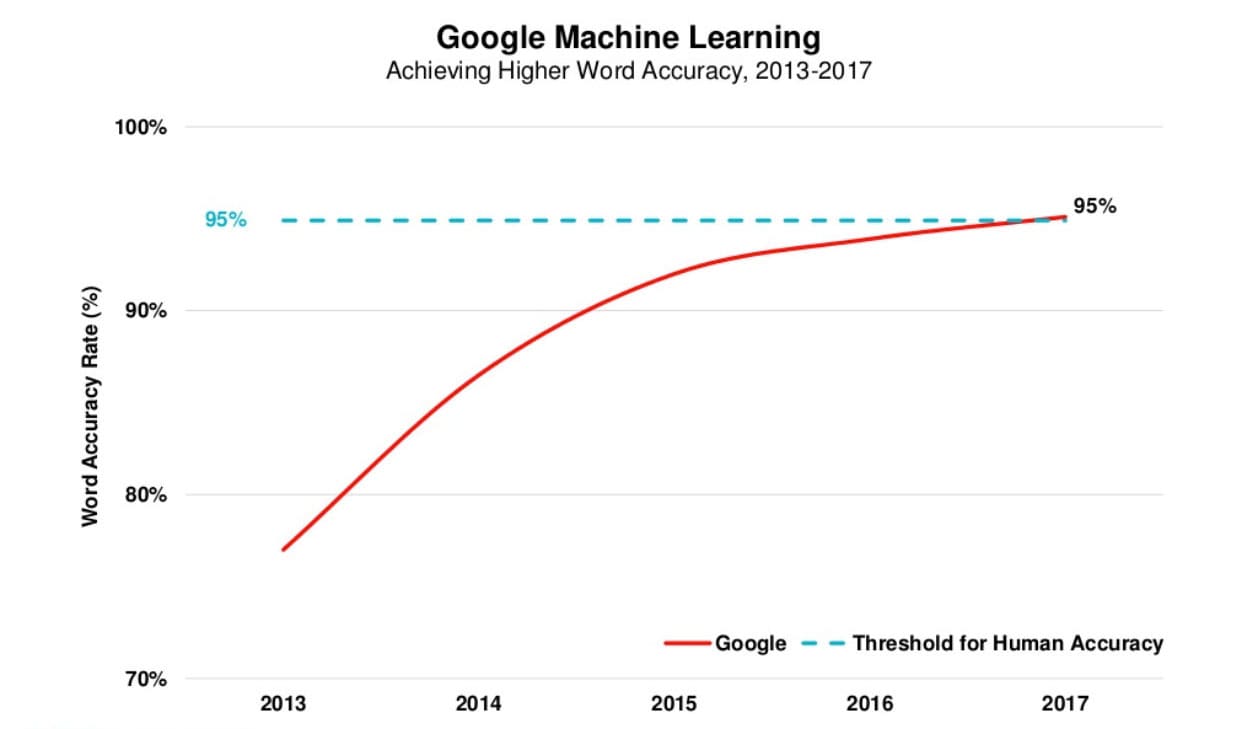
Switchboard 基准是一组电话对话录音,它成了这场比赛的记分牌。2016 年 10 月,Microsoft 报告了 5.9% 的词错误率,与其雇来转录同一批通话的专业转录员持平,并称之为达到人类水平。IBM 于 2017 年 3 月以 5.5% 应战,Google 当年 5 月宣布在自家测试集上达到 4.9%;2017 年 8 月,Microsoft 在更严谨的人类基线测量下达到了 5.1%。下图出自 Mary Meeker 的 2017 年《互联网趋势》报告,显示 Google 的词准确率越过了业界视为人类门槛的 95% 线。同年,Transformer 架构为机器翻译而发表,不到三年就同样接管了语音领域。

图表:Google 的词准确率突破 95%,出自 Mary Meeker 的 2017 年《互联网趋势》报告

Whisper 与 Transformer 让转录成为标配

自监督训练加上一个开放模型,把准确的多语言转录从科技巨头的专属能力,变成了任何产品都能提供的功能。

从无标注音频中学习

2010 年代的瓶颈是标注数据:每一小时训练音频都需要人工转录稿。2020 年,Facebook AI 的 wav2vec 2.0 先从未经转录的原始音频中学习语音表征,随后只需十分钟的标注语音就能微调出一个可用的识别器。Google 同年发表的 Conformer 把卷积与 Transformer 注意力结合起来,在标准基准上刷新了纪录。两者一起让 Transformer 成为语音领域的默认架构,也大幅降低了新增一门语言的成本。

Whisper

2022 年 9 月,OpenAI 发布了 Whisper,它用从网络上收集的 680,000 小时音频训练而成,覆盖近 100 种语言,模型权重公开,任何人都能运行。它并非在每项基准上都最准确,但面对口音、背景噪音和专业词汇时的稳健程度是早先的学术模型所不及的,而且它是免费的。几个月内它就进入了成千上万的产品,转录公司要回答的问题也从“能不能识别语音”变成了“围绕转录稿能做出什么”。

这对今天的您意味着什么

上传到 Sonix 的一小时录音,大约 5 到 6 分钟就能拿到转录稿,带说话人标签和时间戳,清晰音频的准确率达 99%,54+ 种语言任选。Sonix 创立于 2017 年,正是人类水平之争的那一年,此后的每一次进步它都跟上了:模型逐年进步,功夫则花在了编辑器、摘要、翻译和导出上,正是这些让一份转录稿真正有用。上面这七十年,就是今天第一份转录稿分文不取的原因:您的前 30 分钟免费。

自动语种识别有自己的一段历史

判断说的是哪种语言,和判断说了哪些词是两个不同的问题,它也用了整整半个世纪才得以解决。

从音素统计到 i-vector

1970 年代最早的语种识别实验试图靠声音的统计特征来区分语言,理论依据是每种语言使用音素的组合和频率各不相同。到 1990 年代,这演变成了音位配列法:先跑一个音素识别器,再看哪种语言的音素模式最吻合。美国国家标准与技术研究院从 1996 年起举办正式的语种识别评测,推动语音识别前进的那套基准文化同样推动了语种识别。2010 年代,从说话人识别借来的 i-vector,即一段录音的紧凑定长摘要,催生了只需几秒音频就能判断语种的系统。

内置于模型之中

现代多语言识别器把这两个问题合二为一。Whisper 及其后继者把语种作为转录稿的第一个 token 来预测,语种识别因此成了识别的副产品,而不再是单独的一步。正因如此,一个产品无需为每种语言各配一台识别器就能处理 54+ 种语言,您说的是哪种语言,也不再限制您能转录什么。

下一步:语音成为交互界面

语音应用所需的技术如今既便宜又准确,问题已经从机器能不能听,变成了机器听到之后该做什么。

语音优先的产品

从智能音箱到耳机和汽车,语音优先的设备已经让和机器说话变得稀松平常,花了 70 年才达到的准确率如今是理所当然的前提,而不是卖点。语言是几乎每个人都已经掌握的唯一一种界面,所以识别上的一点小改进,触及的人数是任何新屏幕都比不上的。早早押注语音的公司往往能守住这块阵地,就像 2010 年代那些移动优先的公司一样。

转录稿之外

转录稿本身已经成了原材料。大语言模型能总结会议、回答关于一场访谈的问题、翻译一堂讲座,还能据此起草跟进邮件,而它们之所以做得好,只是因为底下那份转录稿足够准确。在 Sonix,这正是我们的工作:识别是上面提到的所有人打下的地基,产品则是有了文字之后您能用它做的事。

常见问题

语音识别发展史, 常见疑问解答

语音识别是什么时候、在哪里发明的?

1952 年。贝尔实验室的 Audrey 系统由 K. H. Davis、R. Biddulph 和 S. Balashek 建造,能识别单一说话人念出的 0 到 9。1962 年 IBM 的 Shoebox 随之而来,能识别 16 个词;第一款能买到的产品 Dragon Dictate 则于 1990 年问世。

语音识别是谁发明的?

没有单独的发明者。1952 年,贝尔实验室的三位工程师造出了第一台识别器 Audrey。1970 年代,James Baker 和 Fred Jelinek 用隐马尔可夫模型让识别走向统计化;1988 年,李开复 (Kai-Fu Lee) 的 Sphinx 实现了连续语音和说话人无关;2012 年,Geoffrey Hinton 的合作者们把深度学习引入了这个领域。

最早的语音识别软件是哪一款?

Dragon Systems 于 1990 年发布的 Dragon Dictate,售价约 9,000 美元,是第一款面向公众销售的语音识别软件,它要求词与词之间停顿。1997 年发布的 Dragon NaturallySpeaking 则是第一款面向家用电脑的连续语音听写产品。

语音识别和声纹识别有什么区别?

语音识别判断的是说了哪些词。声纹识别(也叫说话人识别)根据声音特征判断是谁在说话,手机能为机主解锁靠的就是它。日常口语中这两个说法常被混用。本文讲的是识别词语的技术,也就是转录、听写和语音助手背后的技术。

语音识别算人工智能吗?

算。2012 年以来,每一个有竞争力的语音识别器都是用大量音频训练出来的深度神经网络,与大语言模型属于同一类方法。在那之前,隐马尔可夫模型同样属于机器学习:它从录音中学习概率,而不是遵循手写的规则。

语音识别现在的准确率有多高?

在清晰的会话录音上,最好的系统已能与专业转录员持平:2017 年 Microsoft 在 Switchboard 基准上测得 5.1% 的词错误率,此后模型还在继续进步。Sonix 在音质良好的音频上准确率可达 99%。浓重的口音、多人抢话和背景噪音仍会推高错误率,所以每份转录稿都配有编辑器。

立即开始

免费试用 Sonix

Sonix 对您的音频和视频文件进行转录、添加时间戳和整理,以便您搜索、编辑和共享您的媒体。

包含 30 minutes 分钟免费转录

继续阅读

99% 准确度。 每个字都很重要。

支持 54+ 种语言的 AI 转录和翻译。

30 minutes 免费
无需信用卡
随时取消