Автоматическое распознавание речи:
как оно работает и история распознавания речи с 1952 года

ASR превращает устную речь в письменный текст. В этом руководстве: что это такое, как устроены современные движки, как измеряют точность и как развивалось распознавание речи, от десяти цифр системы Audrey из Bell Labs в 1952 году до 54+ языков сегодня.

Что такое ASR?

Автоматическое распознавание речи (ASR) это технология, которая превращает устную речь в письменный текст. Система ASR получает аудиосигнал, анализирует звуки в нем и подбирает наиболее вероятную последовательность слов. На ней работают программы транскрибации, голосовые ассистенты, живые субтитры, сервисы диктовки и голосовой поиск.

ASR расшифровывается как automatic speech recognition, то есть автоматическое распознавание речи; некоторые компании пишут automated speech recognition, но смысл тот же. Если вам нужна короткая версия на две минуты, прочитайте наш обзор ASR. Здесь мы копнем глубже: от устройства движка до 70 лет исследований, которые за ним стоят.

Этот термин часто путают с тремя соседними, и каждый из них отвечает на свой вопрос:

  • ASR (автоматическое распознавание речи) превращает звучащую речь в текст и отвечает на вопрос «что было сказано?»
  • Speech-to-text (речь в текст) та же технология, только под продуктовым названием; она тоже отвечает на вопрос «что было сказано?»
  • Распознавание голоса (идентификация диктора) определяет или подтверждает, кто говорит, и отвечает на вопрос «кто это сказал?»
  • NLP (обработка естественного языка) понимает смысл текста и отвечает на вопрос «что это значит?»

На практике ASR и speech-to-text взаимозаменяемы: первое название инженерное, второе продуктовое. Чаще всего путают с распознаванием голоса. Оно узнает конкретного человека, как телефон, который разблокируется только для владельца, а ASR записывает слова любого говорящего, и ему неважно, кто именно их произнес. NLP работает на следующем шаге: сначала аудио превращается в текст, а затем NLP делает по нему краткое содержание, отвечает на вопрос или выполняет команду.

Как работает ASR?

Современное ASR представляет собой одну нейросеть, которая переводит аудио прямо в текст, но большую часть своей истории распознавание было конвейером из пяти отдельных моделей.

Классический конвейер, который история ниже собирает по частям, устроен так:

  1. Запись и предобработка. Звук оцифровывается, очищается и нарезается на короткие кадры, обычно длиной в десятки миллисекунд.
  2. Извлечение признаков. Каждый кадр превращается в компактное числовое описание того, сколько энергии приходится на разные частоты.
  3. Акустическая модель. Эта модель сопоставляет признаки с фонемами, базовыми звуковыми единицами языка, и оценивает, какие звуки, скорее всего, были произнесены.
  4. Языковая модель. Эта модель знает, какие последовательности слов вероятны. Поэтому движок напишет «распознать речь», а не «раз познать печь»: под звук подходят оба варианта, но только один подходит под язык.
  5. Декодер. Декодер перебирает совместные вероятности акустической и языковой моделей и выдает самое вероятное предложение.

Переход к сквозным моделям

С середины 2010-х сквозные (end-to-end) модели глубокого обучения, большинство из которых сегодня построено на архитектуре Transformer, напрямую учатся переводить сырое аудио в текст на сотнях тысяч часов речи. Ни вручную составленного словаря произношений, ни отдельной акустической модели: сеть усваивает все это сразу. Именно поэтому точность транскрибации выросла за 2010-е сильнее, чем за четыре предыдущих десятилетия.

Такие модели учатся на огромных объемах аудио, поэтому справляются с акцентами, фоновым шумом и живым разговором гораздо лучше конвейерных систем. Пунктуацию и заглавные буквы они расставляют за тот же проход, так что современная расшифровка читается как готовый документ.

Как измеряют точность ASR

Стандартная метрика называется пословная ошибка (WER): машинную расшифровку сравнивают с тщательной ручной, и каждое замененное, пропущенное или лишнее слово считается ошибкой. WER 5% означает примерно одну ошибку на 20 слов, то есть точность 95%. WER целиком зависит от тестовых записей, поэтому заявления о точности двух разных поставщиков редко можно сравнивать напрямую. В нашем руководстве разобрана формула и есть калькулятор.

Распознавание речи: коротко о главном

Изобретение
Распознавание речи изобрели в 1952 году: система Audrey из Bell Labs распознавала цифры от 0 до 9, произнесенные одним голосом.
Первая программа в продаже
Dragon Dictate вышла в 1990 году по цене около 9000 долларов и стала первым продуктом для распознавания речи в открытой продаже, но требовала паузы после каждого слова.
Первый словарь на 1000 слов
В 1976 году система Harpy из Carnegie Mellon понимала 1011 слов: именно такую планку агентство DARPA поставило перед своей пятилетней программой Speech Understanding Research.
Уровень человека
В 2017 году Microsoft зафиксировала пословную ошибку (WER) 5,1% на телефонном бенчмарке Switchboard, сравнявшись с профессиональными транскрибаторами, которые расшифровывали те же звонки.
Открытые модели
Whisper от OpenAI вышла в сентябре 2022 года: модель обучена на 680 000 часов аудио, транскрибирует почти 100 языков, а ее веса опубликованы в открытом доступе.
Сегодня
Sonix, основанный в 2017 году, распознает речь на 54+ языках с точностью 99% и расшифровывает часовую запись примерно за 5-6 минут.

История распознавания речи начинается в Bell Labs в 1952 году

Первую систему распознавания речи построили в Bell Labs в 1952 году, и понимала она ровно десять слов: цифры от нуля до девяти.

Audrey, автоматический распознаватель цифр

K. H. Davis, R. Biddulph и S. Balashek собрали Audrey из аналоговых схем, занимавших почти двухметровую релейную стойку. Диктор произносил цифру в телефонную трубку, машина измеряла форманты гласных, и рядом с услышанной цифрой загоралась лампочка. Настроенная на голоса своих создателей, она давала от 97 до 99 процентов верных ответов, а на чужих голосах разваливалась. Audrey так и не покинула лабораторию: живой оператор, набирающий номера, обходился дешевле. Но она закрыла вопрос о том, способна ли машина слышать в принципе.

Shoebox от IBM и 1960-е

В 1962 году IBM показала систему Shoebox на Всемирной выставке в Сиэтле. Она распознавала 16 слов, десять цифр и шесть арифметических команд, и управляла ими счетной машиной. Лаборатории в США, Великобритании, Японии и Советском Союзе создавали распознаватели гласных и небольших списков слов, а в 1968 году Тарас Винцюк описал динамическое трансформирование временной шкалы (DTW), которое позволило машине сравнивать речь, произнесенную с разной скоростью. К 1969 году амбиций у области было много, а теории не было, и Джон Пирс из Bell Labs сравнил ее с проектами превращения воды в бензин.

Программа DARPA Speech Understanding Research подняла словари выше 1000 слов

С 1971 по 1976 год агентство DARPA финансировало крупнейший на тот момент проект по распознаванию речи, и Harpy из Carnegie Mellon достигла цели в 1000 слов.

Пятилетняя цель

Программа Speech Understanding Research требовала системы, которая понимала бы слитную речь нескольких дикторов со словарем в 1000 слов и долей ошибок ниже 10 процентов, и DARPA финансировала соревнование Carnegie Mellon, BBN, SRI и других. Harpy, завершенная в Carnegie Mellon в 1976 году, понимала 1011 слов, примерно словарный запас трехлетнего ребенка, и оказалась единственной системой, достигшей цели. Ее секрет был в поиске, который рано отсекал маловероятные последовательности слов вместо того, чтобы взвешивать все варианты. Эта идея до сих пор лежит в основе любого декодера.

Статистический поворот

В те же годы родилась идея, которая следующие 40 лет побеждала все остальные. В Carnegie Mellon Джеймс Бейкер в диссертации 1975 года описал систему DRAGON: она рассматривала речь как скрытую марковскую модель, и какие слова были произнесены, решали вероятности, а не написанные вручную правила. В IBM группа Фредерика Елинека заложила тот же подход в исследовательскую систему диктовки и добавила n-граммные языковые модели, чтобы распознаватель угадывал следующее слово по двум предыдущим. Bell Labs тем временем перешла от одного голоса ко многим и построила распознаватели, работавшие с разными дикторами, чего требовали телефонные приложения.

В 1980-е скрытые марковские модели сделали распознавание речи статистическим

В 1980-е сопоставление с шаблонами уступило место вероятностям, и словари за десятилетие выросли с нескольких сотен слов до 20 000.

Как слышит скрытая марковская модель

Скрытая марковская модель не пытается подогнать звук под шаблон. Она спрашивает, какая последовательность звуков речи вероятнее всего породила полученное аудио, а затем какая последовательность слов вероятнее всего породила эти звуки. Вероятности задаются обучением на записанной речи, поэтому чем больше данных, тем лучше распознаватель, и это свойство приобрело огромное значение с приходом интернета. В сочетании с n-граммными языковыми моделями HMM стала стандартной архитектурой в каждой исследовательской лаборатории и оставалась ею, пока в 2012 году ее не вытеснило глубокое обучение.

Tangora, Sphinx и первые продукты

К середине 1980-х Tangora от IBM распознавала словарь в 20 000 слов, хотя требовала паузы между словами и обучения под каждого диктора. В 1988 году система Sphinx Кай-Фу Ли из Carnegie Mellon первой объединила в одном распознавателе большой словарь, слитную речь и независимость от диктора. Dragon Systems, основанная Джеймсом и Джанет Бейкер в 1982 году, начала продавать программы распознавания для персональных компьютеров. Распознавание голоса впервые дошло и до обычных покупателей: кукла Julie от Worlds of Wonder в 1987 году отвечала на несколько произнесенных фраз, а телефонные компании испытывали голосовой набор номера. Игрушки были грубыми, но именно они принесли словосочетание «распознавание голоса» в обычные дома.

В 1990-е распознавание речи пришло на персональные компьютеры

Более быстрые процессоры превратили диктовку из лабораторной демонстрации в коробочный продукт, а общий бенчмарк позволил легко измерять прогресс.

От Dragon Dictate до NaturallySpeaking

Dragon Dictate вышла в 1990 году по цене около 9000 долларов. Это был первый продукт для распознавания речи, который мог купить любой желающий, и он требовал паузы после каждого слова. В 1997 году Dragon NaturallySpeaking избавилась от паузы: программа распознавала слитную речь со скоростью около 100 слов в минуту на домашнем ПК, и в том же году IBM ответила ViaVoice. Впервые юрист, врач или писатель мог поговорить с компьютером и получить пригодный текст, если сначала обучил программу и потом поправил результат.

Телефонные меню и первые бенчмарки

В 1996 году BellSouth запустила VAL, голосовой портал с дозвоном, который отвечал на произнесенные вопросы, и от него ведет родословную каждая автоматическая телефонная система, с которой вы с тех пор ругались. За кулисами DARPA и Национальный институт стандартов и технологий проводили ежегодные оценки на общих записях, таких как телефонный корпус Switchboard, и пословная ошибка (WER) стала числом, о котором отчитывалась каждая лаборатория. С тех пор история распознавания речи сводится во многом к истории падения этого числа.

В 2000-е распознавание речи переехало в облако

Большую часть десятилетия точность топталась около 80 процентов, пока Google не перенесла распознавание с устройства на свои серверы.

Плато

К 2001 году лучшие системы транскрибировали диктовку с точностью около 80 процентов, а следующие годы принесли доработки, но не рывки. Диктовка на настольных компьютерах осталась нишевой, телефонные меню продолжали раздражать, финансирование исследований иссякало. Скрытая марковская модель подошла к своему потолку, а моделям, которым предстояло ее сменить, еще не хватало ни вычислительной мощности, ни данных.

Google Voice Search

Справочная служба Google GOOG-411, запущенная в 2007 году, собрала миллионы голосовых запросов. В ноябре 2008 года вышло приложение Google Voice Search для iPhone, и распознавание изменилось: телефон только записывал звук, а распознавание шло в дата-центрах Google на моделях, намного больших, чем мог вместить любой телефон, и обученных на 230 миллиардах слов из поисковых запросов. Распознавание стало сервисом, а не программой, и остается им до сих пор.

Хронология

История распознавания речи, год за годом

У каждого события ниже есть дата. Разделы вокруг этой таблицы объясняют, почему каждое из них было важно.

ГодВехаПочему это важно
1952Bell Labs строит AudreyПервая машина, распознающая речь: цифры от 0 до 9 от одного диктора
1962IBM показывает Shoebox16 слов, показанных публике на Всемирной выставке в Сиэтле
1971DARPA запускает программу Speech Understanding ResearchПять лет финансирования и цель в 1000 слов
1976Harpy из Carnegie Mellon берет планку1011 слов и поиск с отсечением, которым декодеры пользуются до сих пор
1986Tangora от IBM достигает 20 000 словСкрытые марковские модели и n-граммные языковые модели становятся стандартом
1988Sphinx в Carnegie MellonСлитная речь, независимость от диктора и большой словарь в одной системе
1990Выходит Dragon DictateПервый продукт для распознавания речи в открытой продаже
1997Dragon NaturallySpeaking и IBM ViaVoiceСлитная диктовка на домашнем ПК, около 100 слов в минуту
2008Google Voice SearchРаспознавание переезжает в облако и учится на каждом запросе
2011Apple выпускает SiriГолосовой помощник в массовом телефоне
2012Глубокие нейросети сменяют смеси гауссовых распределенийДоля ошибок падает почти на треть за один шаг
2016Microsoft сообщает о 5,9% на SwitchboardПервое заявление об уровне человека на разговорном бенчмарке
2017Microsoft 5,1%, IBM 5,5%, Google 4,9%; опубликован TransformerГонка за уровень человека завершена, приходит новая архитектура
2020wav2vec 2.0 и ConformerСамообучение снижает потребность в размеченных данных
2022OpenAI выпускает Whisper680 000 часов обучения, почти 100 языков, открытые веса

В 2010-е глубокое обучение сократило долю ошибок более чем вдвое

С 2011 по 2017 год пословная ошибка на разговорной телефонной речи упала с уровня чуть выше 10 процентов до примерно 5 процентов, а голосовые помощники поселились в домах.

Siri и голосовые помощники

Apple выпустила Siri вместе с iPhone 4S в октябре 2011 года, Amazon ответила Alexa в колонке Echo в 2014 году, а Google в 2016 году представила Google Home. Ассистенты были важны не столько своим распознаванием, которое, как и у Google Voice Search, работало в облаке, сколько привычкой, которую они сформировали: сотни миллионов людей стали каждый день разговаривать с машинами, и каждая их фраза превращалась в данные для обучения.

Шаг к нейросетям

В 2012 году исследователи из Microsoft, Google, IBM и Университета Торонто, среди них Джеффри Хинтон, опубликовали совместную статью, показавшую, что глубокие нейросети, обученные на акустической части задачи, снижают долю ошибок почти на треть по сравнению со смесями гауссовых распределений, которыми системы на HMM пользовались 25 лет. Система Deep Speech от Baidu в 2014 году пошла дальше и обучила одну рекуррентную сеть сквозным образом, от аудио до символов, без словаря произношений и без собранного вручную конвейера. Распознавание стало задачей глубокого обучения, и вперед вырвались лаборатории с наибольшим числом GPU и данных.

Гонка за уровнем человека

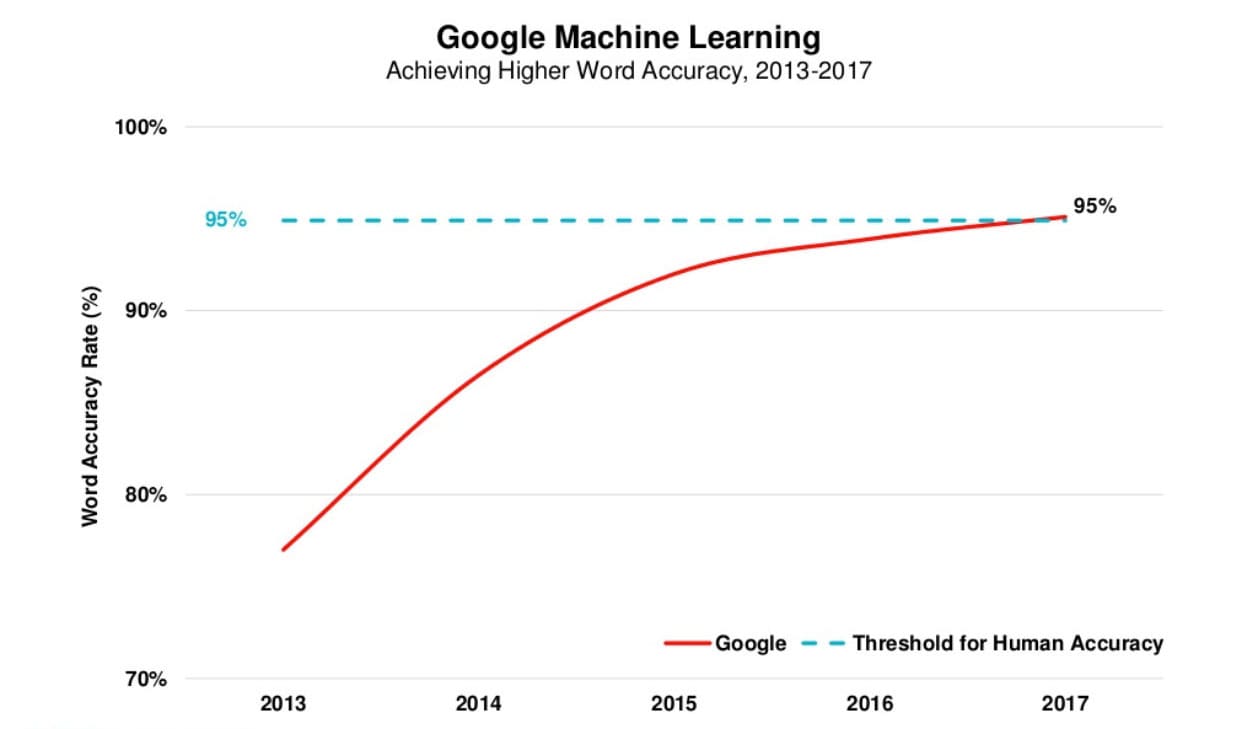
Табло результатов стал бенчмарк Switchboard, набор записанных телефонных разговоров. В октябре 2016 года Microsoft сообщила о пословной ошибке 5,9 процента, такой же, как у профессиональных транскрибаторов, которых компания наняла расшифровать те же звонки, и назвала это паритетом с человеком. IBM ответила результатом 5,5 процента в марте 2017 года, в мае Google объявила о 4,9 процента на собственных тестовых наборах, а в августе 2017 года Microsoft достигла 5,1 процента при более строгом человеческом эталоне. На графике ниже из отчета Мэри Микер Internet Trends 2017 видно, как точность распознавания слов у Google преодолевает отметку в 95 процентов. В том же году была опубликована архитектура Transformer, и через три года она захватила и распознавание речи.

График точности распознавания слов Google, преодолевающей 95 процентов, из отчета Мэри Микер Internet Trends за 2017 год

Whisper и Transformer сделали транскрибацию общедоступной

Самообучение на неразмеченных данных и одна открытая модель превратили точную многоязычную транскрибацию из привилегии технологических гигантов в то, что может предложить любой продукт.

Обучение на неразмеченном аудио

Узким местом 2010-х были размеченные данные: на каждый час обучения требовалась расшифровка, сделанная человеком. В 2020 году модель wav2vec 2.0 от Facebook AI сначала выучила представления речи на сыром, нерасшифрованном аудио, а для дообучения пригодного распознавателя ей хватало всего десяти минут размеченной речи. Conformer от Google, опубликованный в том же году, соединил свертки с вниманием из Transformer и поставил новые рекорды на стандартных бенчмарках. Вместе они сделали Transformer архитектурой по умолчанию для речи и удешевили добавление нового языка.

Whisper

В сентябре 2022 года OpenAI выпустила Whisper: модель обучена на 680 000 часов аудио, собранного в интернете, охватывает почти 100 языков, а ее веса опубликованы, чтобы запустить ее мог кто угодно. Она не была самой точной на каждом бенчмарке, но устойчиво справлялась с акцентами, фоновым шумом и технической лексикой, чего прежние академические модели не умели, и была бесплатной. За считанные месяцы она оказалась внутри тысяч продуктов, и вопрос для компаний, занимающихся транскрибацией, сместился с того, умеют ли они распознавать речь, к тому, что они строят вокруг расшифровки.

У автоматического определения языка своя история

Понять, на каком языке говорят, и понять, какие именно слова сказаны, это две разные задачи, и на решение первой ушли свои 50 лет.

От статистики фонем до i-векторов

Первые эксперименты по определению языка в 1970-х различали языки по статистике их звуков. В 1990-х из этого вырос фонотактический подход: сначала работает распознаватель фонем, затем система смотрит, фонемные шаблоны какого языка подходят лучше всего. В 1996 году NIST начал официальные оценки Language Recognition Evaluation. В 2010-х i-вектор, компактное описание записи, заимствованное из распознавания дикторов, позволил создать системы, которые называли язык по нескольким секундам аудио.

Встроено в модель

Современные многоязычные распознаватели сводят обе задачи в одну. Whisper и ее наследники предсказывают язык первым токеном расшифровки, так что определение языка становится побочным продуктом распознавания, а не отдельным шагом. Именно это позволяет одному продукту работать с 54+ языками без отдельного распознавателя для каждого, и именно поэтому язык, на котором вы говорите, перестал ограничивать то, что вы можете расшифровать.

Где ASR находится сегодня

На чистом, качественно записанном аудио задача ASR почти решена, поэтому движки теперь различаются тем, как справляются со сложными записями и что делают с готовой расшифровкой.

Результаты серьезных движков на бенчмарках сблизились, поэтому главный вопрос к поставщику уже не «какая у вас точность?», а как движок справится с вашим аудио и что он сделает с расшифровкой. Вот как выглядит промышленное ASR в 2026 году на примере Sonix:

Честно измеренная точность

Sonix достигает точности 99% на чистых записях высокого качества и с помощью автоматической транскрибации расшифровывает часовой файл примерно за 5-6 минут. Любая цифра точности, включая нашу, зависит от аудио, поэтому единственный значимый бенчмарк это тест на ваших собственных записях.

Языки

Sonix транскрибирует и переводит на 54+ языках. С моделями эпохи Whisper широкий охват языков стал нормой, а не исключением, и точность для каждого языка зависит от того, сколько обучающего аудио для него существует.

В реальном времени

Транскрибация в реальном времени выводит субтитры с задержкой меньше 2 секунд, пока люди еще говорят. Это прямая заслуга сквозной архитектуры.

Кто что сказал

Движки теперь сами разделяют говорящих, эта задача называется диаризацией дикторов. В нашем руководстве по диаризации объясняется, как это работает и где пока возникают трудности.

Больше, чем расшифровка

Краткое содержание, главы и перевод превращают сырой текст в то, с чем можно работать. ASR стало первым этапом конвейера понимания, а не конечным продуктом, и первые 30 минут в Sonix бесплатны: проверьте это на своем аудио.

Куда движется ASR: сложное аудио, приватность и понимание

Гонка бенчмарков окончена, и остались задачи менее эффектные: сложное аудио, локальное развертывание и переход от слов к пониманию.

Сложные случаи

Перебивающие друг друга собеседники, удаленные микрофоны, сильный акцент, переход на другой язык посреди фразы и узкоспециальная лексика по-прежнему снижают точность любого движка, в том числе нашего. Сквозные модели принесли и новый тип сбоев: иногда во время тишины или шума они «галлюцинируют» гладкий текст. Это открытая исследовательская задача, а не решенная.

Прямо на устройстве

Все больше распознавания будет работать на телефонах, ноутбуках и наушниках, а не в облаке, ради приватности и скорости. Те же методы сжатия, которые уменьшили модели класса Whisper, приносят точное распознавание на устройства, которые никуда не отправляют звук.

От расшифровки к пониманию

Большие языковые модели уже делают краткие итоги встреч, отвечают на вопросы по интервью и готовят план действий по лекции, и делают это хорошо только потому, что под ними точная расшифровка. Голос становится все более популярным интерфейсом. Обещания, что он заменит все экраны, звучат с 1990-х, а нас вполне устроит, если он будет надежно фиксировать то, что люди на самом деле сказали.

Частые вопросы

ASR и распознавание речи:
ответы на вопросы

Как расшифровывается ASR?

ASR означает automatic speech recognition, то есть автоматическое распознавание речи: технология, которая превращает устную речь в письменный текст. Встречается и вариант automated speech recognition, смысл у них одинаковый. В транскрибации термины ASR, распознавание речи и speech-to-text используются как синонимы.

ASR, speech-to-text и распознавание голоса: одно и то же?

ASR и speech-to-text одно и то же: ASR это технический термин, а speech-to-text описывает результат. Распознавание голоса устроено иначе. Оно определяет, кто говорит, по особенностям голоса, именно так телефон разблокируется для владельца, а ASR записывает, что сказал любой человек.

Чем ASR отличается от NLP?

ASR превращает звучащую речь в текст, а NLP (обработка естественного языка) понимает, что этот текст означает. Они работают последовательно: когда вы задаете вопрос голосовому ассистенту, ASR записывает ваши слова, а NLP определяет намерение и находит ответ. В Sonix ASR создает расшифровку, а функции на основе NLP делают по ней краткое содержание и анализ.

Насколько точно ASR?

На чистых записях разговоров лучшие системы не уступают профессиональным транскрибаторам: в 2017 году Microsoft получила пословную ошибку 5,1% на бенчмарке Switchboard, и с тех пор модели стали еще лучше. Sonix достигает точности 99% на качественном аудио. Фоновый шум, удаленные микрофоны, сильный акцент и перебивания по-прежнему повышают долю ошибок, поэтому проверяйте на своих записях.

Когда и где изобрели распознавание речи?

В 1952 году. Система Audrey из Bell Labs, которую построили К. Х. Дэвис, Р. Биддалф и С. Балашек, распознавала цифры от 0 до 9, произнесенные одним человеком. В 1962 году появилась Shoebox от IBM со словарем из 16 слов, а первый продукт, который можно было купить, Dragon Dictate, вышел в 1990 году.

Кто изобрел распознавание речи?

Не один человек. Три инженера Bell Labs построили первый распознаватель, Audrey, в 1952 году. Джеймс Бейкер и Фред Елинек сделали распознавание статистическим с помощью скрытых марковских моделей в 1970-х, система Sphinx Кай-Фу Ли в 1988 году научилась распознавать слитную речь независимо от диктора, а соавторы Джеффри Хинтона принесли в эту область глубокое обучение в 2012 году.

Какая программа распознавания речи была первой?

Dragon Dictate, выпущенная Dragon Systems в 1990 году по цене около 9000 долларов, стала первой программой распознавания речи в открытой продаже. Между словами в ней нужно было делать паузы. Dragon NaturallySpeaking, вышедшая в 1997 году, стала первой массовой программой для диктовки слитной речи на домашних компьютерах.

Может ли ASR распознавать другие языки, кроме английского?

Да. Благодаря многоязычным обучающим данным широкий охват языков стал стандартом, и современные системы работают с десятками языков. Sonix транскрибирует и переводит на 54+ языках, включая испанский, французский, немецкий, китайский (путунхуа), японский и арабский. Точность зависит от языка и от того, сколько обучающего аудио для него существует.

Начните работу

Попробуйте Sonix бесплатно

Sonix транскрибирует, расставляет временные метки и систематизирует ваши аудио- и видеофайлы, чтобы вы могли искать, редактировать и делиться своим контентом.

Включает 30 minutes минут бесплатной транскрипции

Продолжить чтение

Точность 99%. Каждое слово имеет значение.

AI-транскрипция и перевод на 54+ языках.

30 minutes бесплатно
Без кредитной карты
Отмена в любое время