 Stephen Hopkins
Spracherkennung auf einen Blick
- Erfunden
- Die Spracherkennung wurde 1952 erfunden, als das Audrey-System der Bell Labs die Ziffern 0 bis 9 einer einzelnen Stimme erkannte.
- Erste Software für Endkunden
- Dragon Dictate, 1990 für rund 9.000 Dollar erschienen, war das erste Spracherkennungsprodukt für die Öffentlichkeit, und es brauchte nach jedem Wort eine Pause.
- Erstmals 1.000 Wörter
- 1976 verstand Harpy von der Carnegie Mellon University 1.011 Wörter, genau das Ziel, das die DARPA für ihr fünfjähriges Programm Speech Understanding Research gesetzt hatte.
- Auf Augenhöhe
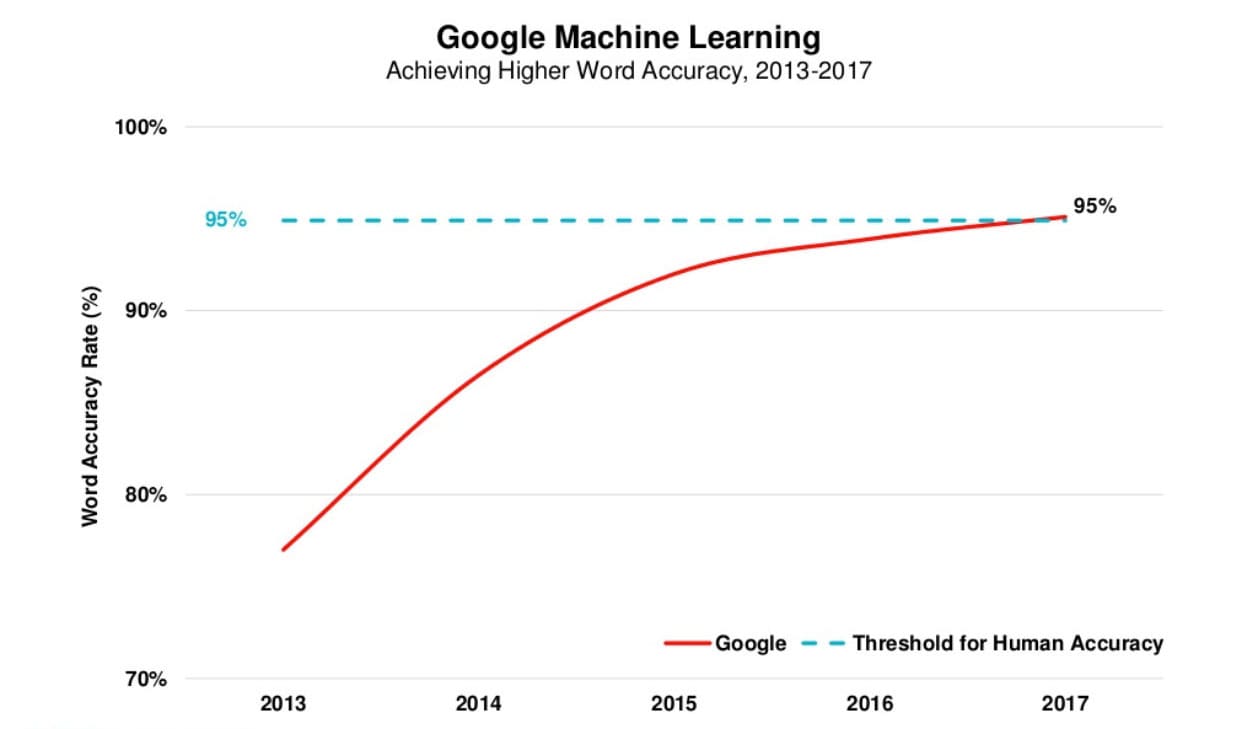
- 2017 maß Microsoft auf dem Telefon-Benchmark Switchboard eine Wortfehlerrate von 5,1% und lag damit gleichauf mit den professionellen Transkribenten, die dieselben Gespräche bearbeitet hatten.
- Offene Modelle
- Whisper von OpenAI, veröffentlicht im September 2022, wurde mit 680.000 Stunden Audio trainiert und transkribiert fast 100 Sprachen, die Gewichte sind frei verfügbar.
- Heute
- Sonix, gegründet 2017, transkribiert 54+ Sprachen mit 99% Genauigkeit und liefert eine einstündige Datei in etwa 5 bis 6 Minuten zurück.
Die Spracherkennung wurde 1952 erfunden
Der erste Spracherkenner entstand 1952 in den Bell Labs und verstand genau zehn Wörter: die Ziffern null bis neun.
Audrey, der Automatic Digit Recognizer
K. H. Davis, R. Biddulph und S. Balashek bauten Audrey aus analogen Schaltungen, die einen gut 1,80 Meter hohen Relaisschrank füllten. Ein Sprecher sagte eine Ziffer in einen Telefonhörer, die Maschine maß die Vokalformanten, und neben der erkannten Ziffer leuchtete eine Lampe auf. Auf die Stimmen ihrer Entwickler abgestimmt erreichte sie 97 bis 99 Prozent; bei Fremden brach sie ein. Audrey verließ das Labor nie, weil ein Mensch, der die Nummern wählte, billiger war, aber sie klärte die Frage, ob eine Maschine überhaupt hören kann.
IBMs Shoebox und die 1960er Jahre
1962 führte IBM Shoebox auf der Weltausstellung in Seattle vor. Das Gerät erkannte 16 gesprochene Wörter, die zehn Ziffern und sechs Rechenbefehle, und steuerte damit eine Addiermaschine. Im Laufe des Jahrzehnts bauten Labore in den USA, Großbritannien, Japan und der Sowjetunion Erkenner für Vokale, Konsonanten und kleine Wortlisten, und 1968 beschrieb Taras Vintsyuk das Dynamic Time Warping, das Ausrichtungsverfahren, mit dem eine Maschine unterschiedlich schnell gesprochene Sprache vergleichen konnte. 1969 hatte das Feld Ehrgeiz, aber keine Theorie: John Pierce von den Bell Labs verglich es mit Plänen, Wasser in Benzin zu verwandeln, und das Labor stellte die Förderung für Jahre ein.
Das DARPA-Programm Speech Understanding Research brachte den Wortschatz auf über 1.000 Wörter
Zwischen 1971 und 1976 finanzierte die DARPA das bis dahin größte Vorhaben zur Spracherkennung, und Harpy von der Carnegie Mellon University erreichte das Ziel von 1.000 Wörtern.
Das Fünfjahresziel
Das Programm Speech Understanding Research verlangte ein System, das zusammenhängende Sprache mehrerer Sprecher bei einem Wortschatz von 1.000 Wörtern mit weniger als 10 Prozent Fehlern versteht, und bezahlte Carnegie Mellon, BBN, SRI und andere dafür, gegeneinander anzutreten. Drei Systeme erreichten die Ziellinie: Hearsay-II und Harpy an der Carnegie Mellon University sowie HWIM bei BBN. Harpy, 1976 fertiggestellt, verstand 1.011 Wörter, ungefähr den Wortschatz eines Dreijährigen, und war das einzige System, das die Vorgabe erfüllte. Sein Kniff war eine Suche, die unwahrscheinliche Wortfolgen früh verwarf, statt jede Möglichkeit abzuwägen, eine Idee, die bis heute im Kern jedes Decoders steckt.
Die statistische Wende
Aus denselben Jahren stammt die Idee, die für die nächsten 40 Jahre alles andere schlug. An der Carnegie Mellon University beschrieb James Baker 1975 in seiner Dissertation das System DRAGON, das Sprache als Hidden-Markov-Modell behandelte und Wahrscheinlichkeiten statt handgeschriebener Regeln entscheiden ließ, welche Wörter gesagt worden waren. Bei IBM baute die Gruppe um Fred Jelinek denselben Ansatz in ein Forschungssystem fürs Diktieren ein und ergänzte n-Gramm-Sprachmodelle, sodass der Erkenner das nächste Wort aus den beiden vorherigen erraten konnte. Die Bell Labs gingen derweil von einer Stimme zu vielen über und bauten Erkenner, die über Sprecher hinweg funktionierten, wie es Telefonanwendungen verlangten.
Hidden-Markov-Modelle machten die Spracherkennung in den 1980ern statistisch
Die 1980er ersetzten den Mustervergleich durch Wahrscheinlichkeiten, und der Wortschatz wuchs innerhalb eines Jahrzehnts von wenigen hundert auf 20.000 Wörter.
Wie ein Hidden-Markov-Modell hört
Ein Hidden-Markov-Modell versucht nicht, einen Klang mit einer Vorlage abzugleichen. Es fragt, welche Folge von Sprachlauten das empfangene Audio am wahrscheinlichsten erzeugt hat, und dann, welche Wortfolge am wahrscheinlichsten diese Laute erzeugt hat. Das Training mit aufgezeichneter Sprache legt die Wahrscheinlichkeiten fest, mehr Daten bedeuten also einen besseren Erkenner, eine Eigenschaft, die mit dem Aufkommen des Internets enorm wichtig werden sollte. In Kombination mit n-Gramm-Sprachmodellen wurde das HMM zur Standardarchitektur in jedem Forschungslabor und blieb es, bis Deep Learning es 2012 verdrängte.
Tangora, Sphinx und die ersten Produkte
IBMs Tangora erkannte Mitte der 1980er einen Wortschatz von 20.000 Wörtern, brauchte aber eine Pause zwischen den Wörtern und ein Training auf jeden Sprecher. 1988 vereinte Kai-Fu Lees System Sphinx an der Carnegie Mellon University als erstes großen Wortschatz, kontinuierliche Sprache und Sprecherunabhängigkeit in einem Erkenner. Dragon Systems, 1982 von James und Janet Baker gegründet, begann Erkennungssoftware für Personal Computer zu verkaufen. Auch Verbraucher kamen erstmals mit Spracherkennung in Berührung: Die Puppe Julie von Worlds of Wonder reagierte 1987 auf eine Handvoll gesprochener Sätze, und Telefongesellschaften erprobten die Sprachwahl. Die Spielzeuge waren primitiv, aber sie brachten das Wort "Spracherkennung" in ganz normale Haushalte.
Die 1990er brachten die Spracherkennung auf den PC
Schnellere Prozessoren machten aus dem Diktieren im Labor Software aus dem Regal, und ein gemeinsamer Benchmark machte den Fortschritt leicht messbar.
Von Dragon Dictate zu NaturallySpeaking
Dragon Dictate kam 1990 für rund 9.000 Dollar auf den Markt. Es war das erste Spracherkennungsprodukt, das jeder kaufen konnte, und es verlangte nach jedem Wort eine Pause. 1997 schaffte Dragon NaturallySpeaking die Pause ab: Es erkannte kontinuierliche Sprache mit rund 100 Wörtern pro Minute auf einem Heim-PC, und IBM antwortete im selben Jahr mit ViaVoice. Zum ersten Mal konnten Anwälte, Ärzte oder Autoren mit einem Computer sprechen und brauchbaren Text bekommen, sofern sie ihn trainierten und korrigierten.
Telefonmenüs und die ersten Benchmarks
1996 startete BellSouth VAL, ein Sprachportal zum Anrufen, das gesprochene Fragen beantwortete, und jedes automatische Telefonsystem, mit dem Sie sich seither gestritten haben, stammt davon ab. Im Hintergrund führten die DARPA und das National Institute of Standards and Technology jährliche Auswertungen auf gemeinsamen Aufnahmen wie dem Telefonkorpus Switchboard durch, und die Wortfehlerrate wurde zur Kennzahl, die jedes Labor meldete. Von da an ist die Geschichte der Spracherkennung weitgehend die Geschichte dieser sinkenden Zahl.
Die 2000er verlagerten die Spracherkennung in die Cloud
Die Genauigkeit stagnierte den Großteil des Jahrzehnts bei etwa 80 Prozent, bis Google die Erkennung vom Gerät auf seine Server verlegte.
Das Plateau
2001 transkribierten die besten Systeme diktierte Sprache mit rund 80 Prozent Genauigkeit, und die folgenden Jahre brachten Feinschliff statt Sprünge. Diktieren am Desktop blieb eine Nische, die Telefonmenüs blieben frustrierend, und die Forschungsgelder wurden knapper. Das Hidden-Markov-Modell war nahe an seiner Obergrenze, und den Modellen, die es ablösen sollten, fehlten noch die Rechenleistung und die Daten.
Google Voice Search
Googles Auskunftsdienst GOOG-411, gestartet 2007, war ein Weg, Millionen gesprochener Anfragen zu sammeln. Im November 2008 veröffentlichte das Unternehmen Google Voice Search als iPhone-App, und die Spracherkennung änderte ihre Gestalt: Das Telefon nahm nur noch auf, die Erkennung lief in Googles Rechenzentren auf Modellen, die weit größer waren, als jedes Gerät hätte fassen können. Googles englisches System war mit 230 Milliarden Wörtern aus Suchanfragen trainiert, es konnte also vorhersagen, was Menschen wahrscheinlich sagen würden, und jede neue Anfrage floss ins nächste Modell. Aus dem Programm wurde ein Dienst, und das ist die Spracherkennung bis heute geblieben.