Historien om
talegenkendelse

Talegenkendelse blev opfundet hos Bell Labs i 1952. Her er historien om, hvordan den gik fra ti talte cifre til 54+ sprog, årti for årti.

Talegenkendelse i korte træk

Opfundet
Talegenkendelse blev opfundet i 1952, da Bell Labs' Audrey-system genkendte cifrene 0 til 9, udtalt af en enkelt stemme.
Første forbrugersoftware
Dragon Dictate, der udkom i 1990 til omkring 9.000 dollars, var det første talegenkendelsesprodukt, der blev solgt til offentligheden, og det krævede en pause efter hvert ord.
Første ordforråd på 1.000 ord
Carnegie Mellons Harpy forstod 1.011 ord i 1976, det mål DARPA havde sat for sit femårige Speech Understanding Research-program.
Menneskeniveau
I 2017 målte Microsoft en ordfejlrate (WER) på 5,1 % på telefonbenchmarken Switchboard, på højde med de professionelle transskribenter, der arbejdede med de samme opkald.
Åbne modeller
OpenAI's Whisper, der udkom i september 2022, blev trænet på 680.000 timers lyd og transskriberer næsten 100 sprog med offentliggjorte vægte.
I dag
Sonix, grundlagt i 2017, transskriberer 54+ sprog med 99% nøjagtighed og har en times optagelse transskriberet på omkring 5 til 6 minutter.

Talegenkendelse blev opfundet i 1952

Det første talegenkendelsessystem blev bygget hos Bell Labs i 1952, og det forstod præcis ti ord: cifrene fra nul til ni.

Audrey, den automatiske cifergenkender

K. H. Davis, R. Biddulph og S. Balashek byggede Audrey af analoge kredsløb, der fyldte et relæstativ på knap to meter. En taler sagde et ciffer ind i et telefonrør, maskinen målte vokalernes formanter, og en lampe lyste op ved siden af det ciffer, den hørte. Indstillet efter konstruktørernes egne stemmer ramte den rigtigt i 97 til 99 procent af tilfældene; med fremmede stemmer faldt den fra hinanden. Audrey forlod aldrig laboratoriet, fordi en telefonist, der tastede numrene ind, var billigere, men den afgjorde spørgsmålet om, hvorvidt en maskine overhovedet kunne høre.

IBM's Shoebox og 1960'erne

I 1962 demonstrerede IBM Shoebox på verdensudstillingen i Seattle. Den genkendte 16 talte ord, de ti cifre og seks regnekommandoer, og styrede en regnemaskine med dem. Gennem årtiet byggede laboratorier i USA, Storbritannien, Japan og Sovjetunionen systemer, der kunne genkende vokaler, konsonanter og små ordlister, og i 1968 beskrev Taras Vintsyuk dynamic time warping, den alignment-metode, der lod en maskine sammenligne tale udtalt i forskelligt tempo. I 1969 havde feltet ambitioner, men ingen teori: John Pierce fra Bell Labs sammenlignede det med planer om at lave vand om til benzin, og laboratoriet lukkede for bevillingerne i årevis.

DARPA's Speech Understanding Research-program bragte ordforrådet over 1.000 ord

Fra 1971 til 1976 finansierede DARPA den hidtil største satsning på talegenkendelse, og Carnegie Mellons Harpy nåede målet på 1.000 ord.

Det femårige mål

Speech Understanding Research-programmet efterspurgte et system, der kunne forstå sammenhængende tale fra flere talere med et ordforråd på 1.000 ord og under 10 procent fejl, og det betalte Carnegie Mellon, BBN, SRI og andre for at konkurrere. Tre systemer nåede i mål: Hearsay-II og Harpy fra Carnegie Mellon og HWIM fra BBN. Harpy, der stod færdig i 1976, forstod 1.011 ord, nogenlunde en treårigs ordforråd, og var det eneste, der levede op til målet. Kunstgrebet var en søgning, der tidligt skar usandsynlige ordsekvenser fra i stedet for at veje alle muligheder, en idé, der stadig er kernen i enhver dekoder.

Den statistiske vending

De samme år fostrede den idé, der slog alt andet af banen de næste 40 år. På Carnegie Mellon beskrev James Bakers afhandling fra 1975 DRAGON-systemet, som behandlede tale som en skjult Markov-model og lod sandsynligheder, ikke håndskrevne regler, afgøre, hvilke ord der var blevet sagt. Hos IBM byggede Fred Jelineks gruppe samme tilgang ind i et dikteringssystem til forskningsbrug og tilføjede n-gram-sprogmodeller, så systemet kunne gætte det næste ord ud fra de to foregående. Bell Labs gik i mellemtiden fra én stemme til mange og byggede systemer, der virkede på tværs af talere, hvilket telefonanvendelser krævede.

Skjulte Markov-modeller gjorde talegenkendelse statistisk i 1980'erne

I 1980'erne blev mønstersammenligning afløst af sandsynlighedsregning, og ordforrådet voksede fra nogle få hundrede ord til 20.000 på et årti.

Sådan hører en skjult Markov-model

En skjult Markov-model forsøger ikke at matche en lyd med en skabelon. Den spørger, hvilken sekvens af talelyde der mest sandsynligt frembragte den lyd, den modtog, og dernæst hvilken sekvens af ord der mest sandsynligt frembragte de lyde. Træning på optaget tale fastlægger sandsynlighederne, så flere data giver et bedre system, en egenskab, der skulle vise sig at betyde enormt meget, da internettet kom. Kombineret med n-gram-sprogmodeller blev HMM'en standardarkitekturen i alle forskningslaboratorier og blev der, indtil deep learning fortrængte den i 2012.

Tangora, Sphinx og de første produkter

IBM's Tangora genkendte et ordforråd på 20.000 ord i midten af 1980'erne, men krævede en pause mellem ordene og træning på hver enkelt taler. I 1988 blev Kai-Fu Lees Sphinx-system på Carnegie Mellon det første, der kombinerede et stort ordforråd, sammenhængende tale og taleruafhængighed i ét system. Dragon Systems, grundlagt af James og Janet Baker i 1982, begyndte at sælge genkendelsessoftware til personlige computere. Stemmegenkendelse nåede også ud til forbrugerne for første gang: Worlds of Wonders Julie-dukke svarede på en håndfuld talte sætninger i 1987, og telefonselskaberne afprøvede stemmestyret opkald. Legetøjet var primitivt, men det bragte udtrykket "stemmegenkendelse" ind i almindelige hjem.

I 1990'erne kom talegenkendelse ud på pc'en

Hurtigere processorer forvandlede diktering fra en laboratoriedemonstration til hyldevare, og en fælles benchmark gjorde fremskridt lette at måle.

Fra Dragon Dictate til NaturallySpeaking

Dragon Dictate kom på markedet i 1990 til omkring 9.000 dollars. Det var det første talegenkendelsesprodukt, en almindelig borger kunne købe, og det krævede en pause efter hvert ord. I 1997 fjernede Dragon NaturallySpeaking pausen: Det genkendte sammenhængende tale med omkring 100 ord i minuttet på en hjemme-pc, og IBM svarede igen med ViaVoice samme år. For første gang kunne en advokat, en læge eller en forfatter tale til en computer og få brugbar tekst ud af det, forudsat at de trænede og rettede den.

Telefonmenuer og de første benchmarks

I 1996 lancerede BellSouth VAL, en stemmeportal, man ringede op til, og som besvarede talte spørgsmål, og alle de automatiske telefonsystemer, du har skændtes med siden, nedstammer fra den. Bag kulisserne kørte DARPA og National Institute of Standards and Technology årlige evalueringer på fælles optagelser som telefonkorpusset Switchboard, og ordfejlraten (WER) blev det tal, alle laboratorier rapporterede. Fra da af er talegenkendelsens historie i høj grad historien om ét tal, der falder.

2000'erne flyttede talegenkendelse op i skyen

Nøjagtigheden gik i stå omkring 80 procent det meste af årtiet, indtil Google flyttede genkendelsen væk fra enheden og over på sine servere.

Plateauet

I 2001 transskriberede de bedste systemer dikteret tale med omkring 80 procent nøjagtighed, og de følgende år bød på finjusteringer snarere end spring. Diktering på skrivebordet forblev en niche, telefonmenuerne forblev frustrerende, og forskningsmidlerne svandt ind. Den skjulte Markov-model var tæt på sit loft, og de modeller, der skulle afløse den, havde endnu hverken regnekraften eller de data, de behøvede.

Google Voice Search

Googles nummeroplysningstjeneste GOOG-411, lanceret i 2007, var en måde at indsamle millioner af talte forespørgsler på. I november 2008 udgav virksomheden Google Voice Search som en iPhone-app, og talegenkendelse skiftede form: Telefonen optog kun, og selve genkendelsen kørte i Googles datacentre på modeller langt større, end nogen enhed kunne rumme. Googles engelske system var trænet på 230 milliarder ord fra søgeforespørgsler, så det kunne forudsige, hvad folk sandsynligvis ville sige, og hver ny forespørgsel fodrede den næste model. Genkendelse blev en tjeneste frem for et program, og den form har den stadig.
Tidslinje

Talegenkendelsens milepæle, år for år

Hver begivenhed nedenfor har et årstal. Afsnittene omkring tabellen forklarer, hvorfor hver enkelt betød noget.

ÅrMilepælBetydning
1952Bell Labs bygger AudreyDen første maskine, der genkender tale: cifrene 0 til 9 fra én taler
1962IBM demonstrerer Shoebox16 ord, vist for offentligheden på verdensudstillingen i Seattle
1971DARPA starter Speech Understanding Research-programmetFem års finansiering og et mål på 1.000 ord
1976Carnegie Mellons Harpy når målet1.011 ord, med en beskåret søgning, som dekodere stadig bruger
1986IBM's Tangora når 20.000 ordSkjulte Markov-modeller og n-gram-sprogmodeller bliver standarden
1988Sphinx på Carnegie MellonSammenhængende, taleruafhængig genkendelse med stort ordforråd i ét system
1990Dragon Dictate udkommerDet første talegenkendelsesprodukt solgt til forbrugere
1997Dragon NaturallySpeaking og IBM ViaVoiceSammenhængende diktering på en hjemme-pc med omkring 100 ord i minuttet
2008Google Voice SearchGenkendelsen flytter i skyen og lærer af hver forespørgsel
2011Apple lancerer SiriEn stemmeassistent i en almindelig telefon
2012Dybe neurale netværk afløser gaussiske blandingsmodellerFejlraterne falder med op til en tredjedel i ét hug
2016Microsoft rapporterer 5,9 % på SwitchboardDen første påstand om menneskeniveau på en samtalebenchmark
2017Microsoft 5,1 %, IBM 5,5 %, Google 4,9 %; Transformer-arkitekturen offentliggøresKapløbet om menneskeniveau slutter, og den næste arkitektur ankommer
2020wav2vec 2.0 og ConformerSelvsuperviseret læring mindsker behovet for annoterede data
2022OpenAI udgiver Whisper680.000 træningstimer, næsten 100 sprog, åbne vægte

Deep learning mere end halverede fejlraterne i 2010'erne

Fra 2011 til 2017 faldt ordfejlraten på telefonsamtaler fra godt ti procent til omkring 5 procent, og stemmeassistenterne flyttede ind i hjemmet.

Siri og assistenterne

Apple leverede Siri med iPhone 4S i oktober 2011, og for første gang kom en telefon til det brede marked med en stemmeassistent bag hjemknappen. Amazon fulgte efter med Alexa på Echo i 2014 og Google med Google Home i 2016. Assistenterne betød mindre for deres genkendelse, som kørte i skyen ligesom Google Voice Search, end for den vane, de skabte: Hundredvis af millioner mennesker begyndte at tale til maskiner hver dag, og hver eneste ytring blev til træningsdata.

Skridtet til neurale netværk

I 2012 offentliggjorde forskere fra Microsoft, Google, IBM og University of Toronto, heriblandt Geoffrey Hinton, en fælles artikel, der viste, at dybe neurale netværk trænet på den akustiske side af problemet skar fejlraterne ned med op til en tredjedel sammenlignet med de gaussiske blandingsmodeller, HMM-systemerne havde brugt i 25 år. Baidus Deep Speech gik skridtet videre i 2014 og trænede ét enkelt rekurrent netværk end-to-end, fra lyd til bogstaver, uden udtaleordbog og uden håndbygget pipeline. Genkendelse blev et deep learning-problem, og de laboratorier, der havde flest GPU'er og mest data, trak fra.

Kapløbet om menneskeniveau

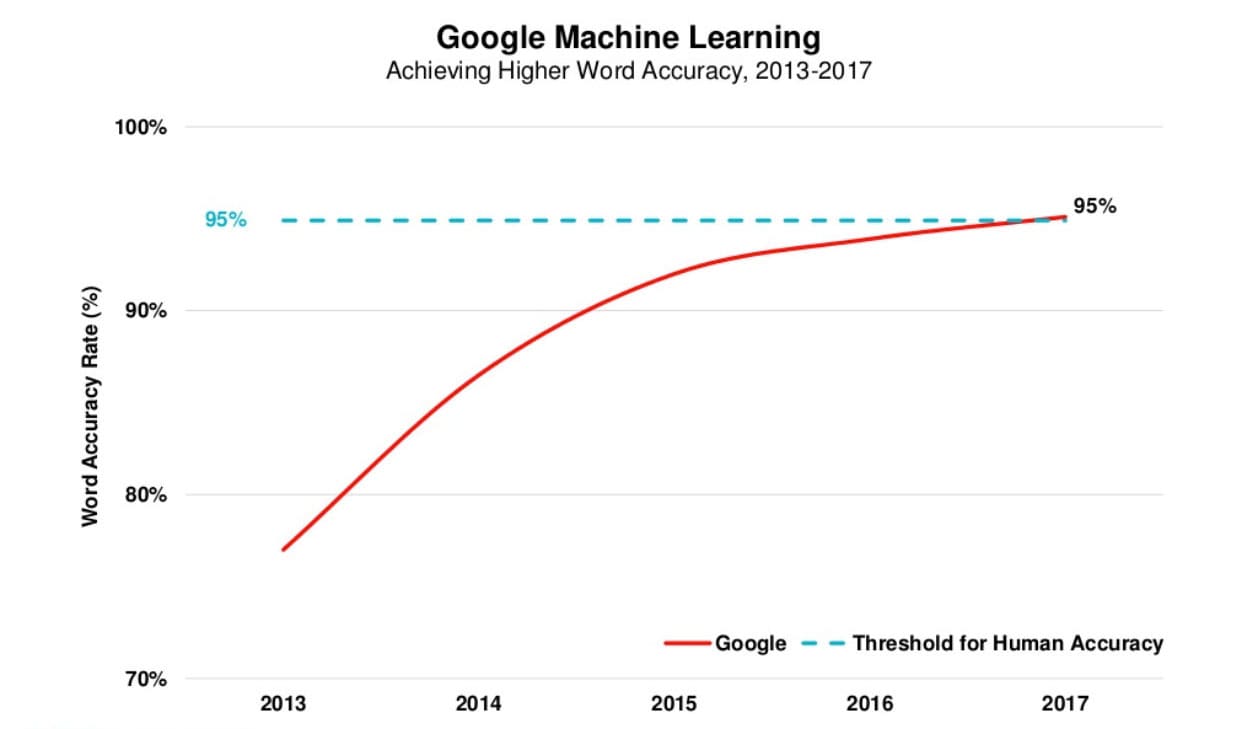
Switchboard-benchmarken, et sæt optagne telefonsamtaler, blev resultattavlen. I oktober 2016 rapporterede Microsoft en ordfejlrate på 5,9 procent, det samme som de professionelle transskribenter, virksomheden hyrede til at arbejde med de samme opkald, og kaldte det menneskeniveau. IBM svarede med 5,5 procent i marts 2017, Google meldte om 4,9 procent på sine egne testsæt i maj samme år, og i august 2017 nåede Microsoft 5,1 procent målt mod en mere omhyggelig opgørelse af den menneskelige baseline. Grafen nedenfor, fra Mary Meekers Internet Trends-rapport fra 2017, viser Googles ordnøjagtighed passere de 95 procent, som branchen regnede for den menneskelige tærskel. Samme år blev Transformer-arkitekturen offentliggjort til maskinoversættelse, og inden for tre år havde den også overtaget talegenkendelsen.

Graf over Googles ordnøjagtighed, der passerer 95 procent, fra Mary Meekers Internet Trends-rapport fra 2017

Whisper og Transformer-arkitekturen gjorde transskription til allemandseje

Selvsuperviseret træning og én åben model forvandlede præcis flersproget transskription fra noget, kun tech-giganterne kunne, til noget, ethvert produkt kan tilbyde.

Læring fra uannoteret lyd

Flaskehalsen i 2010'erne var annoterede data: Hver træningstime krævede en transskription lavet af et menneske. I 2020 lærte Facebook AI's wav2vec 2.0 først talerepræsentationer fra rå, utransskriberet lyd og behøvede så lidt som ti minutters annoteret tale for at finjustere et brugbart genkendelsessystem. Googles Conformer, offentliggjort samme år, kombinerede konvolution med Transformer-attention og satte nye rekorder på standardbenchmarkene. Tilsammen gjorde de Transformeren til standardarkitekturen for tale og sænkede prisen på at tilføje et nyt sprog.

Whisper

I september 2022 udgav OpenAI Whisper, trænet på 680.000 timers lyd indsamlet fra nettet, dækkende næsten 100 sprog, og med modelvægtene offentliggjort, så alle kunne køre den. Det var ikke det mest præcise system på alle benchmarks, men det var robust over for accenter, baggrundsstøj og fagligt ordforråd på en måde, tidligere akademiske modeller ikke var, og det var gratis. Inden for få måneder sad det i tusindvis af produkter, og spørgsmålet for transskriptionsvirksomhederne flyttede sig fra, om de kunne genkende tale, til hvad de byggede rundt om transskriptionen.

Hvad det betyder for dig i dag

En times optagelse uploadet til Sonix kommer tilbage som en transskription på omkring 5 til 6 minutter, med talermarkeringer, tidsstempler og 99% nøjagtighed på klar lyd, uanset hvilket af de 54+ sprog der tales. Sonix blev grundlagt i 2017, året for kapløbet om menneskeniveau, og har været med på hvert skridt siden: Modellerne bliver bedre år for år, og kræfterne bruges nu på editoren, resuméerne, oversættelserne og eksporterne, der gør en transskription nyttig. De syv årtier ovenfor er grunden til, at den første transskription i dag ikke koster noget: Dine første 30 minutter er gratis.

Automatisk sprogidentifikation har sin egen historie

At vide, hvilket sprog der tales, er et andet problem end at vide, hvilke ord der siges, og det tog sine egne 50 år at løse.

Fra fonemstatistik til i-vektorer

De første forsøg med sprogidentifikation i 1970'erne prøvede at skelne sprog fra hinanden ud fra statistikken over deres lyde, ud fra teorien om at hvert sprog bruger sin egen blanding af fonemer med forskellig hyppighed. I 1990'erne blev det til den fonotaktiske tilgang: Kør en fonemgenkender, og spørg derefter, hvilket sprogs fonemmønstre der passer bedst. National Institute of Standards and Technology indledte formelle Language Recognition Evaluations i 1996, og den benchmarkkultur, der drev talegenkendelsen, drev også sprogidentifikationen. I 2010'erne kom i-vektoren, en kompakt sammenfatning af en optagelse med fast længde lånt fra talergenkendelse, og med den systemer, der kunne udpege et sprog ud fra nogle få sekunders lyd.

Indbygget i modellen

Moderne flersprogede genkendelsessystemer slår de to problemer sammen. Whisper og dens efterfølgere forudsiger sproget som transskriptionens første token, så identifikationen er et biprodukt af genkendelsen snarere end et separat trin. Det er det, der lader ét produkt håndtere 54+ sprog uden et separat system til hvert af dem, og grunden til, at det sprog, du taler, ikke længere sætter grænser for, hvad du kan transskribere.

Det næste skridt: Stemmen bliver grænsefladen

Teknologien bag stemmeapplikationer er nu billig og præcis, og spørgsmålet har flyttet sig fra, om maskiner kan høre, til hvad de skal stille op med det, de hører.

Voice-first-produkter

Voice-first-enheder, fra smarthøjttalere til øretelefoner og biler, har gjort det helt almindeligt at tale til en maskine, og den nøjagtighed, det tog 70 år at nå, er nu en forudsætning snarere end en funktion. Sproget er den ene grænseflade, næsten alle mennesker allerede har, og derfor når en lille forbedring i genkendelsen ud til flere mennesker, end en ny skærm nogensinde kunne. De virksomheder, der bygger på stemmen tidligt, har en tendens til at beholde den position, ligesom 2010'ernes mobile-first-virksomheder gjorde.

Ud over transskriptionen

Selve transskriptionen er blevet råmaterialet. Store sprogmodeller opsummerer møder, besvarer spørgsmål om et interview, oversætter en forelæsning og skriver et udkast til opfølgningsmailen ud fra den, og de gør de ting godt, udelukkende fordi transskriptionen nedenunder er præcis. Hos Sonix er det arbejdet: Genkendelsen er fundamentet, som alle de nævnte ovenfor har lagt, og produktet er det, du kan gøre med ordene, når først de findes.

Spørgsmål og svar

Talegenkendelsens historie,
spørgsmålene besvaret

Hvornår blev talegenkendelse opfundet, og hvor?

I 1952. Bell Labs' Audrey-system, bygget af K. H. Davis, R. Biddulph og S. Balashek, genkendte de talte cifre 0 til 9 fra en enkelt taler. IBM's Shoebox fulgte i 1962 med 16 ord, og det første produkt, man kunne købe, Dragon Dictate, kom i 1990.

Hvem opfandt talegenkendelse?

Ikke én enkelt person. Tre ingeniører hos Bell Labs byggede det første genkendelsessystem, Audrey, i 1952. James Baker og Fred Jelinek gjorde genkendelsen statistisk med skjulte Markov-modeller i 1970'erne, Kai-Fu Lees Sphinx gjorde den sammenhængende og taleruafhængig i 1988, og Geoffrey Hintons samarbejdspartnere bragte deep learning ind i den i 2012.

Hvilken talegenkendelsessoftware kom først?

Dragon Dictate, udgivet af Dragon Systems i 1990 til omkring 9.000 dollars, var den første talegenkendelsessoftware, der blev solgt til offentligheden. Den krævede en pause mellem ordene. Dragon NaturallySpeaking, udgivet i 1997, var det første dikteringsprodukt til sammenhængende tale på hjemmecomputere.

Talegenkendelse kontra stemmegenkendelse: Hvad er forskellen?

Talegenkendelse identificerer de ord, der blev sagt. Stemmegenkendelse identificerer, hvem der sagde dem, ud fra stemmens karakteristika, og det er sådan, en telefon låser op for sin ejer. I daglig tale bruges begreberne i flæng. Denne artikel handler om at genkende ord, teknologien bag transskription, diktering og stemmeassistenter.

Er talegenkendelse en form for AI?

Ja. Siden 2012 har alle konkurrencedygtige talegenkendelsessystemer været dybe neurale netværk trænet på store mængder lyd, den samme familie af metoder, der ligger bag store sprogmodeller. Før da var skjulte Markov-modeller også en form for maskinlæring: De lærte sandsynligheder fra optaget tale i stedet for at følge håndskrevne regler.

Hvor præcis er talegenkendelse lige nu?

På klare samtaleoptagelser matcher de bedste systemer professionelle transskribenter: Microsoft målte en ordfejlrate på 5,1 % på Switchboard-benchmarken i 2017, og modellerne er blevet bedre siden. Sonix når 99% nøjagtighed på god lyd. Kraftige accenter, overlappende tale og baggrundsstøj hæver stadig fejlraten, og derfor følger der en editor med hver transskription.

Kom i gang

Prøv Sonix gratis

Sonix transskriberer, tidsstempler og organiserer dine lyd- og videofiler, så du kan søge i, redigere og dele dine medier.

Inkluderer 30 minutes minutters gratis transskription

Læs videre

99% nøjagtighed. Hvert ord tæller.

AI-transskription og oversættelse på 54+ sprog.

30 minutes gratis
Intet kreditkort
Afmeld når som helst