 Stephen Hopkins
¿Qué es el ASR?
El reconocimiento automático de voz (ASR, por sus siglas en inglés) es la tecnología que convierte el lenguaje hablado en texto escrito. Un sistema ASR recibe una señal de audio, analiza los sonidos que contiene y predice la secuencia de palabras más probable. Es la base del software de transcripción, los asistentes de voz, los subtítulos en directo, las herramientas de dictado y la búsqueda por voz.
ASR son las siglas en inglés de automatic speech recognition, es decir, reconocimiento automático de voz; algunos proveedores lo llaman reconocimiento de voz automatizado, y ambos términos significan lo mismo. Si busca la versión de dos minutos, lea nuestra introducción al ASR. Esta guía profundiza más, desde el motor hasta los 70 años de investigación que lo respaldan.
El término suele confundirse con otros tres, y cada uno responde a una pregunta distinta:
- ASR (reconocimiento automático de voz) convierte el audio de voz en texto y responde a la pregunta «¿qué se dijo?»
- Voz a texto es la misma tecnología con su nombre comercial; también responde a «¿qué se dijo?»
- Reconocimiento del hablante (biometría de voz) identifica o verifica quién habla y responde a «¿quién lo dijo?»
- PLN (procesamiento del lenguaje natural) interpreta el significado del texto y responde a «¿qué significa?»
En la práctica, ASR y voz a texto son sinónimos: ASR es el término de ingeniería y voz a texto el nombre del producto. La confusión habitual es con el reconocimiento del hablante, que identifica a una persona concreta, como el teléfono que solo se desbloquea con la voz de su dueño, mientras que el ASR transcribe las palabras de cualquiera sin importarle quién las dijo. El PLN entra después: primero el audio se convierte en texto y luego el PLN lo resume, responde preguntas sobre él o actúa en consecuencia.
¿Cómo funciona el ASR?
El ASR moderno es una sola red neuronal que pasa directamente del audio al texto, pero durante la mayor parte de su historia fue una cadena de cinco modelos independientes.
La cadena clásica, que la historia de más abajo va armando pieza a pieza, funciona así:
- Captura y preprocesamiento. El audio se digitaliza, se limpia y se divide en tramas cortas, normalmente de unas decenas de milisegundos.
- Extracción de características. Cada trama se convierte en una descripción numérica compacta de su energía en distintas frecuencias.
- Modelo acústico. Este modelo asocia esas características con fonemas, las unidades básicas de sonido de una lengua, y estima qué sonidos se pronunciaron probablemente.
- Modelo de lenguaje. Este modelo sabe qué secuencias de palabras son probables. Por eso un motor escribe «votar en las elecciones» y no «botar en las elecciones»: las dos suenan igual, pero solo una tiene sentido en la lengua.
- Decodificador. El decodificador recorre las probabilidades combinadas del modelo acústico y del modelo de lenguaje y devuelve la frase más probable.
El cambio a extremo a extremo
Desde mediados de la década de 2010, los modelos de aprendizaje profundo de extremo a extremo, hoy casi todos basados en la arquitectura Transformer, aprenden directamente a pasar del audio en bruto al texto, entrenados con cientos de miles de horas de habla. No hay diccionario de pronunciación hecho a mano ni modelo acústico aparte: la red lo aprende todo a la vez. Ese cambio es la principal razón por la que la precisión de la transcripción mejoró más en los años 2010 que en las cuatro décadas anteriores.
Como estos modelos aprenden de cantidades enormes de audio, manejan los acentos, el ruido de fondo y la conversación natural mucho mejor que los sistemas por etapas, y predicen la puntuación y las mayúsculas en la misma pasada, de modo que una transcripción moderna se lee como un documento.
Cómo se mide la precisión del ASR
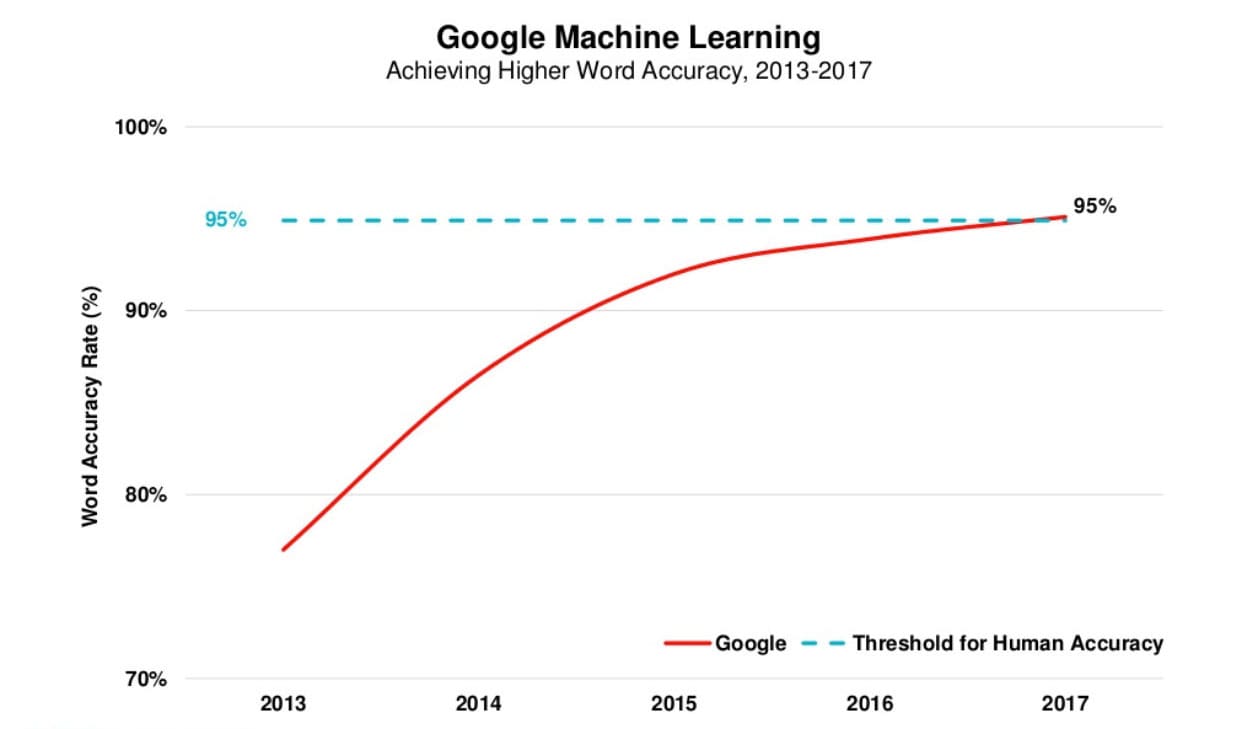
La métrica de referencia es la tasa de error de palabras (WER): se compara la transcripción automática con una transcripción humana cuidadosa y cada palabra sustituida, omitida o insertada cuenta como un error. Un WER del 5% equivale a más o menos un error cada 20 palabras, es decir, un 95% de precisión. El WER depende por completo del audio de prueba, y por eso las cifras de precisión de dos proveedores rara vez son comparables; nuestra guía explica la fórmula e incluye una calculadora.
El reconocimiento de voz de un vistazo
- Invención
- El reconocimiento de voz se inventó en 1952, cuando el sistema Audrey de Bell Labs reconoció los dígitos del 0 al 9 pronunciados por una sola voz.
- Primer software de consumo
- Dragon Dictate, lanzado en 1990 por unos 9,000 dólares, fue el primer producto de reconocimiento de voz vendido al público, y exigía una pausa después de cada palabra.
- Primer vocabulario de 1,000 palabras
- Harpy, de Carnegie Mellon, entendía 1,011 palabras en 1976, la meta que DARPA había fijado para su programa quinquenal Speech Understanding Research.
- Paridad humana
- En 2017 Microsoft midió una tasa de error de palabras del 5.1% en el benchmark telefónico Switchboard, igualando a los transcriptores profesionales que trabajaron las mismas llamadas.
- Modelos abiertos
- Whisper, de OpenAI, lanzado en septiembre de 2022, se entrenó con 680,000 horas de audio y transcribe casi 100 idiomas con pesos publicados.
- Hoy
- Sonix, fundada en 2017, transcribe 54+ idiomas con una precisión del 99% y devuelve una grabación de una hora en unos 5 a 6 minutos.
La historia del reconocimiento de voz empieza en Bell Labs en 1952
El primer reconocedor de voz se construyó en Bell Labs en 1952 y entendía exactamente diez palabras: los dígitos del cero al nueve.
Audrey, el reconocedor automático de dígitos
K. H. Davis, R. Biddulph y S. Balashek construyeron Audrey con circuitos analógicos que llenaban un bastidor de relés de casi dos metros. El hablante decía un dígito por el auricular de un teléfono, la máquina medía los formantes de las vocales y se encendía una lámpara junto al dígito que había oído. Ajustada a las voces de sus diseñadores acertaba entre el 97 y el 99 por ciento; con desconocidos se venía abajo. Audrey nunca salió del laboratorio, porque salía más barato que una operadora marcara los números, pero zanjó la duda de si una máquina podía oír siquiera.
El Shoebox de IBM y los años 60
En 1962 IBM presentó Shoebox en la Feria Mundial de Seattle. Reconocía 16 palabras habladas, los diez dígitos y seis órdenes aritméticas, y con ellas manejaba una máquina de sumar. Laboratorios de Estados Unidos, Gran Bretaña, Japón y la Unión Soviética construyeron reconocedores de vocales y de listas cortas de palabras, y en 1968 Taras Vintsyuk describió el alineamiento temporal dinámico, que permitía a una máquina comparar habla pronunciada a distintas velocidades. En 1969 el campo tenía ambición pero no teoría, y John Pierce, de Bell Labs, lo comparó con los planes para convertir agua en gasolina.
El programa Speech Understanding Research de DARPA llevó los vocabularios más allá de las 1,000 palabras
Entre 1971 y 1976 DARPA financió el mayor esfuerzo en reconocimiento de voz hasta la fecha, y Harpy, de Carnegie Mellon, alcanzó su meta de 1,000 palabras.
La meta a cinco años
El programa Speech Understanding Research pedía un sistema capaz de entender habla continua de varios hablantes con un vocabulario de 1,000 palabras y menos del 10 por ciento de error, y pagó a Carnegie Mellon, BBN, SRI y otros para que compitieran. Harpy, terminado en Carnegie Mellon en 1976, entendía 1,011 palabras, más o menos el vocabulario de un niño de tres años, y fue el único sistema que cumplió el objetivo. Su truco era una búsqueda que descartaba pronto las secuencias de palabras improbables en lugar de sopesar cada posibilidad, una idea que sigue siendo el núcleo de todo decodificador.
El giro estadístico
De esos mismos años salió la idea que se impuso a todas las demás durante los 40 años siguientes. En Carnegie Mellon, la tesis de James Baker de 1975 describía el sistema DRAGON, que trataba el habla como un modelo oculto de Márkov y dejaba que las probabilidades, y no reglas escritas a mano, decidieran qué palabras se habían dicho. En IBM, el grupo de Fred Jelinek incorporó el mismo enfoque a un sistema de dictado experimental y añadió modelos de lenguaje de n-gramas, de modo que el reconocedor podía adivinar la siguiente palabra a partir de las dos anteriores. Bell Labs, mientras tanto, pasó de una voz a muchas y construyó reconocedores que funcionaban con distintos hablantes, algo que las aplicaciones telefónicas exigían.
Los modelos ocultos de Márkov hicieron estadístico el reconocimiento de voz en los años 80
Los años 80 sustituyeron la comparación de patrones por la probabilidad, y los vocabularios pasaron de unos cientos de palabras a 20,000 en una década.
Cómo oye un modelo oculto de Márkov
Un modelo oculto de Márkov no intenta emparejar un sonido con una plantilla. Se pregunta qué secuencia de sonidos del habla produjo con mayor probabilidad el audio que recibió, y después qué secuencia de palabras produjo con mayor probabilidad esos sonidos. Las probabilidades se fijan entrenando con habla grabada, así que más datos significan un reconocedor mejor, una propiedad que importaría muchísimo cuando llegara internet. Combinado con modelos de lenguaje de n-gramas, el HMM se convirtió en la arquitectura estándar de todos los laboratorios de investigación y ahí se quedó hasta que el aprendizaje profundo lo desplazó en 2012.
Tangora, Sphinx y los primeros productos
Tangora, de IBM, reconocía un vocabulario de 20,000 palabras a mediados de los años 80, aunque necesitaba una pausa entre palabras y entrenarse con cada hablante. En 1988 el sistema Sphinx de Kai-Fu Lee, en Carnegie Mellon, fue el primero en combinar vocabulario amplio, habla continua e independencia del hablante en un solo reconocedor. Dragon Systems, fundada por James y Janet Baker en 1982, empezó a vender software de reconocimiento para computadoras personales. El reconocimiento de voz también llegó por primera vez a los consumidores: la muñeca Julie, de Worlds of Wonder, respondía a un puñado de frases habladas en 1987, y las compañías telefónicas probaron la marcación por voz. Los juguetes eran rudimentarios, pero metieron la expresión "reconocimiento de voz" en los hogares de la gente común.
Los años 90 llevaron el reconocimiento de voz a las computadoras personales
Procesadores más rápidos convirtieron el dictado de una demostración de laboratorio en software vendido en caja, y una prueba de referencia compartida facilitó medir el progreso.
De Dragon Dictate a NaturallySpeaking
Dragon Dictate salió a la venta en 1990 por unos 9,000 dólares. Fue el primer producto de reconocimiento de voz que cualquier persona podía comprar, y exigía una pausa después de cada palabra. En 1997 Dragon NaturallySpeaking eliminó la pausa: reconocía habla continua a unas 100 palabras por minuto en una computadora doméstica, e IBM respondió con ViaVoice ese mismo año. Por primera vez un abogado, un médico o un escritor podía hablarle a una computadora y obtener texto utilizable, siempre que lo entrenara y lo corrigiera.
Menús telefónicos y las primeras evaluaciones
En 1996 BellSouth lanzó VAL, un portal de voz al que se llamaba por teléfono y que respondía preguntas habladas; de él descienden todos los sistemas telefónicos automáticos con los que usted ha discutido desde entonces. Tras bambalinas, DARPA y el Instituto Nacional de Estándares y Tecnología (NIST) organizaban evaluaciones anuales sobre grabaciones compartidas como el corpus telefónico Switchboard, y la tasa de error de palabras se convirtió en la cifra que todos los laboratorios reportaban. A partir de ahí, la historia del reconocimiento de voz es en buena medida la historia de cómo fue bajando esa cifra.
Los años 2000 llevaron el reconocimiento de voz a la nube
La precisión se estancó cerca del 80 por ciento durante casi toda la década, hasta que Google sacó el reconocimiento del dispositivo y lo llevó a sus servidores.
La meseta
Hacia 2001 los mejores sistemas transcribían habla dictada con una precisión cercana al 80 por ciento, y los años siguientes trajeron retoques más que saltos. El dictado de escritorio siguió siendo un nicho, los menús telefónicos siguieron siendo frustrantes y el financiamiento de la investigación se redujo. El modelo oculto de Márkov estaba cerca de su techo, y los modelos que lo reemplazarían todavía no tenían la capacidad de cómputo ni los datos que necesitaban.
Google Voice Search
GOOG-411, el servicio de información telefónica que Google lanzó en 2007, reunió millones de consultas habladas. En noviembre de 2008 llegó Google Voice Search como app para iPhone, y el reconocimiento cambió de forma: el teléfono solo grababa, y el reconocimiento se hacía en los centros de datos de Google con modelos mucho más grandes de lo que cabía en cualquier dispositivo, entrenados con 230,000 millones de palabras de consultas de búsqueda. El reconocimiento pasó de ser un programa a ser un servicio, y así sigue hoy.