Reconnaissance automatique de la parole :
fonctionnement et histoire de la reconnaissance vocale depuis 1952

L'ASR transforme la parole en texte écrit. Ce guide explique ce qu'elle est, comment fonctionnent les moteurs actuels, comment on mesure leur précision, et retrace l'histoire de la reconnaissance vocale, d'Audrey, qui reconnaissait dix chiffres à Bell Labs en 1952, aux 54+ langues d'aujourd'hui.

Qu'est-ce que l'ASR ?

La reconnaissance automatique de la parole (ASR, pour Automatic Speech Recognition) est la technologie qui convertit la langue parlée en texte écrit. Un système d'ASR reçoit un signal audio, en analyse les sons et prédit la suite de mots la plus probable. C'est elle qui fait tourner les logiciels de transcription, les assistants vocaux, le sous-titrage en direct, les outils de dictée et la recherche vocale.

ASR signifie Automatic Speech Recognition, que l'on traduit par reconnaissance automatique de la parole (RAP) ; certains éditeurs parlent aussi d'Automated Speech Recognition, et les deux désignent la même chose. Pour l'essentiel en deux minutes, lisez notre présentation de l'ASR. Ce guide va plus loin, du moteur lui-même aux 70 ans de recherche qui l'ont rendu possible.

Le terme se confond souvent avec trois notions voisines, et chacune répond à une question différente :

  • ASR (reconnaissance automatique de la parole) convertit l'audio parlé en texte et répond à la question « qu'est-ce qui a été dit ? »
  • Speech-to-text (parole en texte) désigne la même technologie sous son nom commercial ; elle répond elle aussi à « qu'est-ce qui a été dit ? »
  • Reconnaissance du locuteur identifie ou authentifie la personne qui parle et répond à « qui l'a dit ? »
  • TALN (traitement automatique du langage naturel) interprète le sens d'un texte et répond à « qu'est-ce que cela veut dire ? »

Dans la pratique, ASR et speech-to-text sont interchangeables : ASR est le terme des ingénieurs, speech-to-text celui des produits. La confusion la plus fréquente concerne la reconnaissance du locuteur. Elle reconnaît une personne, comme un téléphone qui ne se déverrouille que pour son propriétaire, alors que l'ASR transcrit les paroles de n'importe qui sans se soucier de qui parle. Le TALN intervient ensuite : l'audio devient d'abord du texte, puis le TALN le résume, répond à une question à son sujet ou déclenche une action.

Comment fonctionne l'ASR ?

L'ASR moderne repose sur un seul réseau de neurones qui passe directement de l'audio au texte, mais pendant l'essentiel de son histoire, c'était une chaîne de cinq modèles distincts.

La chaîne classique, que l'histoire racontée plus bas assemble pièce par pièce, fonctionne ainsi :

  1. Acquisition et prétraitement. L'audio est numérisé, nettoyé et découpé en trames courtes, généralement de quelques dizaines de millisecondes.
  2. Extraction des caractéristiques. Chaque trame est réduite à une description numérique compacte de son énergie dans les différentes fréquences.
  3. Modèle acoustique. Ce modèle associe ces caractéristiques à des phonèmes, les unités sonores de base d'une langue, et estime quels sons ont probablement été prononcés.
  4. Modèle de langage. Ce modèle sait quelles suites de mots sont plausibles. C'est pour cela qu'un moteur écrit « l'eau de la mer » plutôt que « l'eau de la mère » : les deux collent à l'audio, une seule colle à la langue.
  5. Décodeur. Le décodeur explore les probabilités combinées des modèles acoustique et de langage, puis produit la phrase la plus probable.

Le passage au bout-en-bout

Depuis le milieu des années 2010, des modèles d'apprentissage profond de bout en bout, aujourd'hui construits pour la plupart sur l'architecture Transformer, apprennent directement à passer de l'audio brut au texte, entraînés sur des centaines de milliers d'heures de parole. Plus de dictionnaire de prononciation construit à la main, plus de modèle acoustique séparé : le réseau apprend tout d'un bloc. C'est la principale raison pour laquelle la précision de la transcription a davantage progressé dans les années 2010 qu'au cours des quarante années précédentes.

Comme ils apprennent sur des volumes d'audio considérables, ces modèles gèrent bien mieux les accents, le bruit de fond et la conversation naturelle que les anciennes chaînes. Ils prédisent aussi la ponctuation et les majuscules dans le même passage, si bien qu'une transcription moderne se lit comme un document.

Comment mesurer la précision de l'ASR

La métrique de référence est le taux d'erreur de mots (WER) : on compare la transcription automatique à une transcription humaine soignée, et chaque mot remplacé, supprimé ou ajouté compte comme une erreur. Un WER de 5 % correspond à peu près à une erreur tous les 20 mots, soit 95 % de précision. Le WER dépend entièrement de l'audio testé, c'est pourquoi les chiffres de précision de deux éditeurs sont rarement comparables. Notre guide détaille la formule et propose un calculateur.

La reconnaissance vocale en bref

Invention
La reconnaissance vocale a été inventée en 1952, lorsque le système Audrey de Bell Labs a reconnu les chiffres de 0 à 9 prononcés par une seule voix.
Premier logiciel grand public
Dragon Dictate, lancé en 1990 pour environ 9 000 dollars, a été le premier produit de reconnaissance vocale vendu au grand public, et il exigeait une pause après chaque mot.
Premier vocabulaire de 1 000 mots
Harpy, à Carnegie Mellon, comprenait 1 011 mots en 1976, l'objectif que la DARPA avait fixé à son programme quinquennal Speech Understanding Research.
Parité humaine
En 2017, Microsoft a mesuré un taux d'erreur de mots de 5,1 % sur le corpus téléphonique Switchboard, à égalité avec les transcripteurs professionnels chargés des mêmes appels.
Modèles ouverts
Whisper, publié par OpenAI en septembre 2022, a été entraîné sur 680 000 heures d'audio et transcrit près de 100 langues, avec des poids rendus publics.
Aujourd'hui
Sonix, fondée en 2017, transcrit 54+ langues avec une précision de 99% et renvoie un enregistrement d'une heure en 5 à 6 minutes environ.

L'histoire de la reconnaissance vocale commence à Bell Labs en 1952

Le premier système de reconnaissance de la parole a été construit à Bell Labs en 1952, et il comprenait exactement dix mots : les chiffres de zéro à neuf.

Audrey, le reconnaisseur automatique de chiffres

K. H. Davis, R. Biddulph et S. Balashek ont construit Audrey à partir de circuits analogiques qui remplissaient une baie de relais de six pieds, soit près de deux mètres de haut. Le locuteur prononçait un chiffre dans un combiné téléphonique, la machine mesurait les formants des voyelles et une lampe s'allumait à côté du chiffre reconnu. Réglée sur la voix de ses concepteurs, elle atteignait 97 à 99 pour cent de réussite ; face à des inconnus, elle s'effondrait. Audrey n'a jamais quitté le laboratoire, parce qu'un opérateur humain qui composait les numéros revenait moins cher, mais elle a tranché une question : oui, une machine pouvait entendre.

Shoebox d'IBM et les années 1960

En 1962, IBM a présenté Shoebox à l'Exposition universelle de Seattle. La machine reconnaissait 16 mots parlés, les dix chiffres et six commandes arithmétiques, et pilotait avec eux une machine à additionner. Des laboratoires aux États-Unis, en Grande-Bretagne, au Japon et en Union soviétique ont construit des reconnaisseurs de voyelles et de petites listes de mots, et en 1968 Taras Vintsyuk a décrit l'alignement temporel dynamique (DTW), qui permettait à une machine de comparer des paroles prononcées à des vitesses différentes. En 1969, le domaine avait de l'ambition mais pas de théorie, et John Pierce, de Bell Labs, l'a comparé aux projets visant à transformer l'eau en essence.

Le programme Speech Understanding Research de la DARPA a porté les vocabulaires au-delà de 1 000 mots

De 1971 à 1976, la DARPA a financé le plus vaste effort de reconnaissance vocale jamais entrepris jusque-là, et Harpy, à Carnegie Mellon, a atteint l'objectif des 1 000 mots.

L'objectif sur cinq ans

Le programme Speech Understanding Research réclamait un système capable de comprendre de la parole enchaînée, prononcée par plusieurs locuteurs, sur un vocabulaire de 1 000 mots avec moins de 10 pour cent d'erreur, et il a financé Carnegie Mellon, BBN, SRI et d'autres pour qu'ils se mesurent les uns aux autres. Harpy, achevé à Carnegie Mellon en 1976, comprenait 1 011 mots, à peu près le vocabulaire d'un enfant de trois ans, et a été le seul système à atteindre la cible. Son astuce : une recherche qui élaguait tôt les séquences de mots improbables au lieu de peser chaque possibilité, une idée qui reste au cœur de tout décodeur.

Le tournant statistique

Ces mêmes années ont produit l'idée qui allait surpasser toutes les autres pendant 40 ans. À Carnegie Mellon, la thèse de James Baker, en 1975, décrivait le système DRAGON, qui traitait la parole comme un modèle de Markov caché et laissait les probabilités, et non des règles écrites à la main, décider des mots prononcés. Chez IBM, l'équipe de Fred Jelinek a intégré la même approche dans un système de dictée expérimental et y a ajouté des modèles de langage n-grammes, pour que le reconnaisseur puisse deviner le mot suivant à partir des deux précédents. Bell Labs, de son côté, est passé d'une voix à plusieurs et a construit des reconnaisseurs qui fonctionnaient d'un locuteur à l'autre, ce qu'exigeaient les applications téléphoniques.

Dans les années 1980, les modèles de Markov cachés ont rendu la reconnaissance vocale statistique

Les années 1980 ont remplacé l'appariement de formes par les probabilités, et les vocabulaires sont passés de quelques centaines de mots à 20 000 en une décennie.

Comment entend un modèle de Markov caché

Un modèle de Markov caché ne cherche pas à faire correspondre un son à un gabarit. Il se demande quelle séquence de sons de parole a le plus probablement produit l'audio reçu, puis quelle séquence de mots a le plus probablement produit ces sons. L'entraînement sur de la parole enregistrée fixe les probabilités : plus de données, c'est un meilleur reconnaisseur, une propriété qui allait compter énormément avec l'arrivée d'internet. Combiné aux modèles de langage n-grammes, le HMM est devenu l'architecture de référence dans tous les laboratoires de recherche, et il y est resté jusqu'à ce que l'apprentissage profond le supplante en 2012.

Tangora, Sphinx et les premiers produits

Au milieu des années 1980, Tangora, chez IBM, reconnaissait un vocabulaire de 20 000 mots, à condition de marquer une pause entre les mots et d'entraîner le système sur chaque locuteur. En 1988, le système Sphinx de Kai-Fu Lee, à Carnegie Mellon, a été le premier à réunir grand vocabulaire, parole continue et indépendance vis-à-vis du locuteur dans un seul reconnaisseur. Dragon Systems, fondée par James et Janet Baker en 1982, a commencé à vendre des logiciels de reconnaissance pour ordinateurs personnels. La reconnaissance vocale est aussi entrée pour la première fois chez les particuliers : la poupée Julie de Worlds of Wonder répondait à une poignée de phrases en 1987, et les opérateurs téléphoniques testaient la numérotation vocale. Ces jouets étaient rudimentaires, mais ils ont fait entrer l'expression « reconnaissance vocale » dans les foyers.

Les années 1990 ont mis la reconnaissance vocale sur les PC

Des processeurs plus rapides ont transformé la dictée, jusque-là démonstration de laboratoire, en logiciel vendu en boîte, et un corpus de référence commun a rendu les progrès faciles à mesurer.

De Dragon Dictate à NaturallySpeaking

Dragon Dictate est sorti en 1990 pour environ 9 000 dollars. C'était le premier produit de reconnaissance vocale qu'un particulier pouvait acheter, et il imposait une pause après chaque mot. En 1997, Dragon NaturallySpeaking a supprimé la pause : il reconnaissait la parole continue à environ 100 mots par minute sur un PC familial, et IBM a répliqué la même année avec ViaVoice. Pour la première fois, un avocat, un médecin ou un écrivain pouvait parler à un ordinateur et obtenir un texte exploitable, à condition de l'entraîner et de le corriger.

Serveurs vocaux et premiers benchmarks

En 1996, BellSouth a lancé VAL, un portail vocal accessible par téléphone qui répondait à des questions parlées, et tous les serveurs vocaux contre lesquels vous avez pesté depuis en descendent. En coulisses, la DARPA et le National Institute of Standards and Technology organisaient des évaluations annuelles sur des enregistrements communs comme le corpus téléphonique Switchboard, et le taux d'erreur de mots est devenu le chiffre que chaque laboratoire publiait. À partir de là, l'histoire de la reconnaissance vocale est en grande partie celle de la chute de ce chiffre.

Les années 2000 ont envoyé la reconnaissance vocale dans le cloud

La précision a plafonné autour de 80 pour cent pendant l'essentiel de la décennie, jusqu'à ce que Google déplace la reconnaissance de l'appareil vers ses serveurs.

Le plateau

En 2001, les meilleurs systèmes transcrivaient la parole dictée avec une précision d'environ 80 pour cent, et les années suivantes ont apporté des raffinements plutôt que des bonds. La dictée sur ordinateur est restée une niche, les serveurs vocaux sont restés agaçants et les financements de la recherche se sont raréfiés. Le modèle de Markov caché approchait de son plafond, et les modèles appelés à le remplacer n'avaient pas encore la puissance de calcul ni les données dont ils avaient besoin.

Google Voice Search

Le service de renseignements téléphoniques GOOG-411 de Google, lancé en 2007, a recueilli des millions de requêtes parlées. En novembre 2008, Google Voice Search est arrivé sous forme d'application iPhone, et la reconnaissance a changé de forme : le téléphone se contentait d'enregistrer, et la reconnaissance tournait dans les centres de données de Google, sur des modèles bien plus gros que ce qu'un appareil pouvait contenir, entraînés sur 230 milliards de mots issus de requêtes de recherche. La reconnaissance est devenue un service plutôt qu'un programme, la forme qu'elle a gardée depuis.

Chronologie

L'histoire de la reconnaissance vocale,
année par année

Chaque événement ci-dessous est daté. Les sections qui entourent ce tableau expliquent pourquoi chacun a compté.

AnnéeJalonPourquoi cela compte
1952Bell Labs construit AudreyLa première machine à reconnaître la parole : les chiffres de 0 à 9 d'un seul locuteur
1962IBM présente Shoebox16 mots, présentés au public à l'Exposition universelle de Seattle
1971La DARPA lance le programme Speech Understanding ResearchCinq ans de financement et un objectif de 1 000 mots
1976Harpy, à Carnegie Mellon, atteint l'objectif1 011 mots, avec une recherche élaguée que les décodeurs utilisent encore
1986Tangora, chez IBM, atteint 20 000 motsLes modèles de Markov cachés et les modèles de langage n-grammes deviennent la norme
1988Sphinx à Carnegie MellonParole continue, indépendance du locuteur et grand vocabulaire dans un seul système
1990Sortie de Dragon DictateLe premier produit de reconnaissance vocale vendu au grand public
1997Dragon NaturallySpeaking et IBM ViaVoiceDictée continue sur un PC familial à environ 100 mots par minute
2008Google Voice SearchLa reconnaissance passe dans le cloud et apprend de chaque requête
2011Apple lance SiriUn assistant vocal dans un téléphone grand public
2012Les réseaux de neurones profonds remplacent les mélanges de gaussiennesJusqu'à un tiers d'erreurs en moins, d'un seul coup
2016Microsoft annonce 5,9 % sur SwitchboardPremière revendication de parité humaine sur un benchmark conversationnel
2017Microsoft 5,1 %, IBM 5,5 %, Google 4,9 % ; le Transformer est publiéLa course à la parité s'achève et l'architecture suivante arrive
2020wav2vec 2.0 et le ConformerL'apprentissage auto-supervisé réduit le besoin de données annotées
2022OpenAI publie Whisper680 000 heures d'entraînement, près de 100 langues, poids ouverts

Dans les années 2010, l'apprentissage profond a divisé les taux d'erreur par plus de deux

De 2011 à 2017, le taux d'erreur de mots sur la parole téléphonique conversationnelle est passé d'un peu plus de 10 pour cent à environ 5 pour cent, et les assistants vocaux se sont installés dans les foyers.

Siri et les assistants

Apple a livré Siri avec l'iPhone 4S en octobre 2011, Amazon a suivi avec Alexa sur l'Echo en 2014, puis Google avec Google Home en 2016. Ces assistants ont moins compté pour leur reconnaissance, qui tournait dans le cloud à la manière de Google Voice Search, que pour l'habitude qu'ils ont installée : des centaines de millions de personnes se sont mises à parler chaque jour à des machines, et chaque phrase prononcée est devenue une donnée d'entraînement.

L'étape des réseaux de neurones

En 2012, des chercheurs de Microsoft, Google, IBM et de l'université de Toronto, dont Geoffrey Hinton, ont publié un article commun montrant que des réseaux de neurones profonds entraînés sur le volet acoustique du problème réduisaient les taux d'erreur d'un tiers, dans les meilleurs cas, par rapport aux modèles de mélange de gaussiennes que les systèmes HMM utilisaient depuis 25 ans. Deep Speech, de Baidu, est allé plus loin en 2014 en entraînant un seul réseau récurrent de bout en bout, de l'audio aux caractères, sans dictionnaire de prononciation ni chaîne de traitement construite à la main. La reconnaissance est devenue un problème d'apprentissage profond, et les laboratoires disposant du plus de GPU et de données ont pris les devants.

La course à la parité humaine

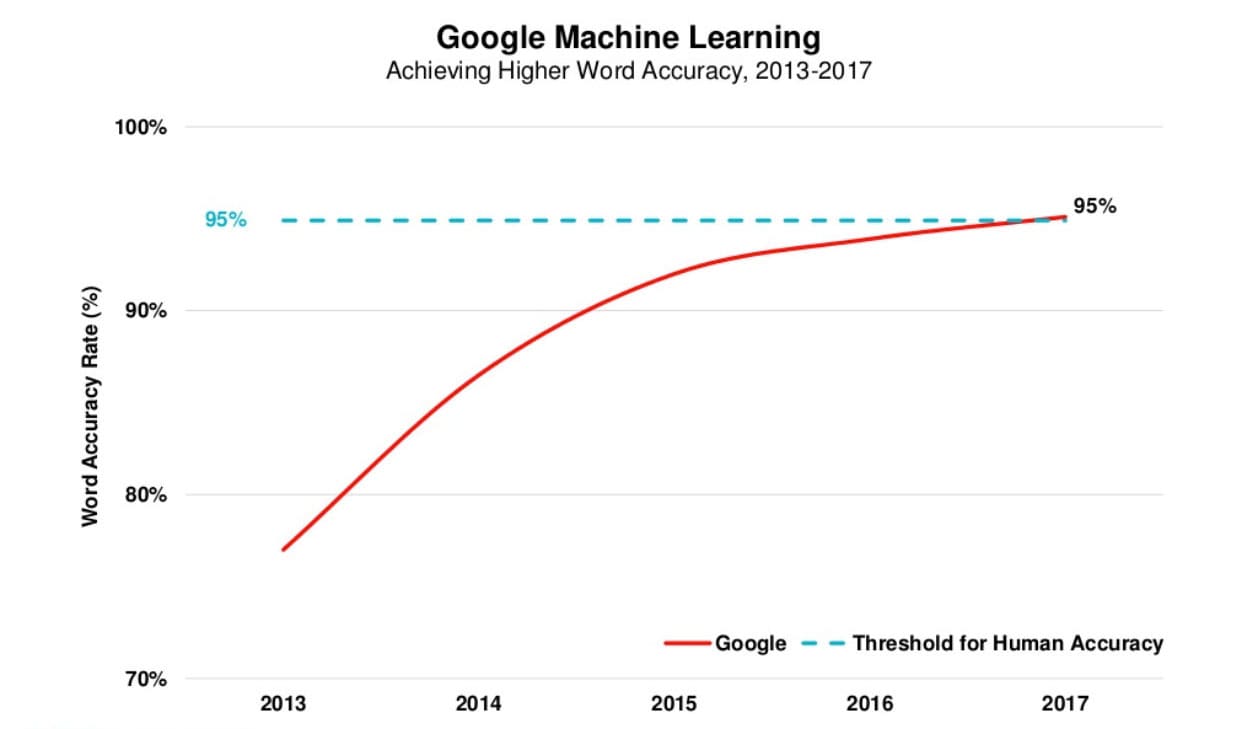
Le benchmark Switchboard, un ensemble de conversations téléphoniques enregistrées, est devenu le tableau des scores. En octobre 2016, Microsoft a annoncé 5,9 pour cent de taux d'erreur de mots, autant que les transcripteurs professionnels engagés pour traiter les mêmes appels, et a parlé de parité humaine. IBM a répondu avec 5,5 pour cent en mars 2017, Google a annoncé 4,9 pour cent sur ses propres jeux de test en mai, et en août 2017 Microsoft a atteint 5,1 pour cent face à une référence humaine plus rigoureuse. Le graphique ci-dessous, tiré du rapport Internet Trends 2017 de Mary Meeker, montre la précision par mot de Google franchissant la barre des 95 pour cent. La même année, l'architecture Transformer a été publiée, et en trois ans elle avait aussi conquis la parole.

Graphique du taux de précision par mot de Google dépassant 95 pour cent, tiré du rapport Internet Trends 2017 de Mary Meeker

Whisper et le Transformer ont banalisé la transcription

L'entraînement auto-supervisé et un seul modèle ouvert ont transformé la transcription multilingue précise, jusque-là réservée aux géants de la tech, en une fonction que n'importe quel produit peut proposer.

Apprendre à partir d'audio non annoté

Le goulet d'étranglement des années 2010, c'étaient les données annotées : chaque heure d'entraînement exigeait une transcription humaine. En 2020, wav2vec 2.0, de Facebook AI, a d'abord appris des représentations de la parole à partir d'audio brut, non transcrit, et n'a eu besoin que de dix minutes de parole annotée pour affiner un reconnaisseur utilisable. Le Conformer de Google, publié la même année, a combiné convolution et attention de type Transformer et établi de nouveaux records sur les benchmarks standard. À eux deux, ils ont fait du Transformer l'architecture par défaut pour la parole et réduit le coût d'ajout d'une nouvelle langue.

Whisper

En septembre 2022, OpenAI a publié Whisper, entraîné sur 680 000 heures d'audio collectées sur le web, couvrant près de 100 langues, avec des poids de modèle publiés pour que chacun puisse l'exécuter. Ce n'était pas le système le plus précis sur chaque benchmark, mais il résistait aux accents, au bruit de fond et au vocabulaire technique comme aucun modèle académique avant lui, et il était gratuit. En quelques mois, il équipait des milliers de produits, et pour les entreprises de transcription la question n'était plus de savoir si elles pouvaient reconnaître la parole, mais ce qu'elles construisaient autour de la transcription.

L'identification automatique de la langue a sa propre histoire

Savoir quelle langue est parlée est un problème distinct de savoir quels mots le sont, et il a lui aussi fallu 50 ans pour le résoudre.

Des statistiques de phonèmes aux i-vectors

Les premières expériences d'identification de la langue, dans les années 1970, distinguaient les langues par les statistiques de leurs sons. Dans les années 1990, c'est devenu l'approche phonotactique : on fait tourner un reconnaisseur de phonèmes, puis on cherche la langue dont les enchaînements de phonèmes correspondent le mieux, et le NIST a lancé en 1996 ses évaluations formelles, les Language Recognition Evaluations. Dans les années 2010, l'i-vector, un résumé compact d'un enregistrement emprunté à la reconnaissance du locuteur, a produit des systèmes capables de nommer une langue à partir de quelques secondes d'audio.

Intégrée au modèle

Les reconnaisseurs multilingues modernes fusionnent les deux problèmes. Whisper et ses successeurs prédisent la langue comme premier token de la transcription, si bien que l'identification est un sous-produit de la reconnaissance plutôt qu'une étape à part. C'est ce qui permet à un seul produit de gérer 54+ langues sans un reconnaisseur distinct pour chacune, et c'est pourquoi la langue que vous parlez ne limite plus ce que vous pouvez transcrire.

Où en est l'ASR aujourd'hui

Sur un audio net et bien enregistré, l'ASR moderne est un problème presque résolu. Les moteurs se distinguent donc sur l'audio difficile et sur ce qu'ils font une fois la transcription obtenue.

Les scores des moteurs sérieux se sont resserrés sur les benchmarks. La bonne question à poser à un éditeur n'est donc plus « quelle est votre précision ? », mais comment il traite votre audio et ce qu'il fait de la transcription. Sonix est un exemple concret d'ASR en production en 2026 :

Une précision mesurée honnêtement

Sonix atteint une précision de 99% sur un audio net et de bonne qualité, et renvoie un enregistrement d'une heure en 5 à 6 minutes environ grâce à la transcription automatique. Tout chiffre de précision, le nôtre compris, dépend de l'audio : le seul benchmark qui compte est un test sur vos propres enregistrements.

Langues

Sonix transcrit et traduit en 54+ langues. Les modèles de l'ère Whisper ont fait d'une large couverture linguistique la norme plutôt que l'exception, et la précision dans chaque langue dépend de la quantité d'audio d'entraînement disponible pour elle.

Temps réel

La transcription en temps réel affiche les sous-titres en moins de 2 secondes pendant que les gens parlent encore, un bénéfice direct de l'architecture de bout en bout.

Qui a dit quoi

Les moteurs séparent désormais les locuteurs automatiquement, une tâche appelée diarisation ; notre guide de la diarisation des locuteurs explique comment elle fonctionne et où elle bute encore.

Au-delà de la transcription

Résumés, chapitres et traduction transforment le texte brut en quelque chose d'exploitable. L'ASR est devenue la première étape d'une chaîne de compréhension plutôt que le produit final, et vos 30 premières minutes sur Sonix sont gratuites pour le vérifier sur votre propre audio.

L'avenir de l'ASR : audio difficile, confidentialité et compréhension

La course aux benchmarks est terminée, et il reste les problèmes les moins spectaculaires : l'audio difficile, le déploiement en local et le passage des mots à la compréhension.

Les cas difficiles

Les voix qui se chevauchent, les micros éloignés, les accents marqués, les changements de langue en pleine phrase et le vocabulaire spécialisé dégradent encore tous les moteurs, le nôtre compris. Les modèles de bout en bout ont aussi introduit un nouveau type d'erreur : ils hallucinent parfois un texte parfaitement fluide pendant un silence ou du bruit, un sujet de recherche encore ouvert.

Directement sur l'appareil

La reconnaissance va de plus en plus tourner sur les téléphones, les ordinateurs portables et les écouteurs plutôt que dans le cloud, pour la confidentialité comme pour la rapidité. Le travail de compression qui a allégé les modèles de la classe de Whisper apporte une reconnaissance précise à du matériel qui n'envoie jamais l'audio nulle part.

De la transcription à la compréhension

Les grands modèles de langage résument désormais des réunions, répondent à des questions sur un entretien et rédigent le suivi d'un cours, et ils ne le font bien que parce que la transcription sous-jacente est exacte. La voix prend de plus en plus de place comme interface. On annonce depuis les années 1990 qu'elle remplacera tous les écrans ; nous nous contenterions qu'elle capte fidèlement ce que les gens ont vraiment dit.

Questions fréquentes

ASR et reconnaissance vocale,
vos questions, nos réponses

Que signifie ASR ?

ASR signifie Automatic Speech Recognition, en français reconnaissance automatique de la parole : la technologie qui convertit la langue parlée en texte écrit. On rencontre aussi la forme Automated Speech Recognition, qui veut dire la même chose. En transcription, ASR, reconnaissance vocale et speech-to-text s'emploient indifféremment.

L'ASR, est-ce la même chose que le speech-to-text ou la reconnaissance du locuteur ?

L'ASR et le speech-to-text, c'est la même chose : ASR est le terme technique, speech-to-text décrit le résultat. La reconnaissance du locuteur est différente. Elle identifie qui parle d'après les caractéristiques de sa voix, ce qui permet à un téléphone de se déverrouiller pour son propriétaire, alors que l'ASR transcrit ce que dit n'importe qui.

Quelle différence entre l'ASR et le TALN ?

L'ASR convertit l'audio parlé en texte ; le TALN (traitement automatique du langage naturel) interprète le sens de ce texte. Les deux s'enchaînent : quand vous posez une question à un assistant vocal, l'ASR transcrit vos mots, puis le TALN en déduit l'intention et la réponse. Dans Sonix, l'ASR produit la transcription, et des fonctions fondées sur le TALN la résument et l'analysent.

Quelle est la précision de l'ASR ?

Sur des enregistrements conversationnels nets, les meilleurs systèmes égalent les transcripteurs professionnels : Microsoft a mesuré un taux d'erreur de mots de 5,1 % sur le benchmark Switchboard en 2017, et les modèles ont progressé depuis. Sonix atteint une précision de 99% sur un bon audio. Le bruit de fond, les micros éloignés, les accents marqués et les voix qui se chevauchent font encore grimper le taux d'erreur : testez donc sur vos propres enregistrements.

Quand et où la reconnaissance vocale a-t-elle été inventée ?

En 1952. Le système Audrey de Bell Labs, construit par K. H. Davis, R. Biddulph et S. Balashek, reconnaissait les chiffres de 0 à 9 prononcés par un seul locuteur. Shoebox, d'IBM, a suivi en 1962 avec 16 mots, et le premier produit que l'on pouvait acheter, Dragon Dictate, est arrivé en 1990.

Qui a inventé la reconnaissance vocale ?

Personne en particulier. Trois ingénieurs de Bell Labs ont construit le premier reconnaisseur, Audrey, en 1952. James Baker et Fred Jelinek ont rendu la reconnaissance statistique avec les modèles de Markov cachés dans les années 1970, le Sphinx de Kai-Fu Lee l'a rendue continue et indépendante du locuteur en 1988, et les collaborateurs de Geoffrey Hinton y ont apporté l'apprentissage profond en 2012.

Quel a été le premier logiciel de reconnaissance vocale ?

Dragon Dictate, lancé par Dragon Systems en 1990 pour environ 9 000 dollars, a été le premier logiciel de reconnaissance vocale vendu au grand public. Il exigeait une pause entre les mots. Dragon NaturallySpeaking, sorti en 1997, a été le premier logiciel de dictée en parole continue largement adopté sur les ordinateurs familiaux.

L'ASR peut-elle transcrire d'autres langues que l'anglais ?

Oui. Grâce aux données d'entraînement multilingues, une large couverture est devenue la norme, et les systèmes actuels gèrent des dizaines de langues. Sonix transcrit et traduit en 54+ langues, dont l'espagnol, le français, l'allemand, le mandarin, le japonais et l'arabe. La précision varie selon la langue et dépend de la quantité d'audio d'entraînement disponible pour chacune.

Commencer

Essayez Sonix gratuitement

Sonix transcrit, ajoute des horodatages et organise vos fichiers audio et vidéo afin que vous puissiez rechercher, éditer et partager vos médias.

Comprend 30 minutes de transcription gratuite

Continuer la lecture

Précision de 99 %. Chaque mot compte.

Transcription et traduction par IA en 54+ langues.

30 minutes gratuit
Sans carte de crédit
Annulez à tout moment