 Stephen Hopkins
Wat is ASR?
Automatische spraakherkenning (ASR) is de technologie die gesproken taal omzet in geschreven tekst. Een ASR-systeem neemt een audiosignaal, analyseert de klanken erin en voorspelt de meest waarschijnlijke reeks woorden. Het is de motor achter transcriptiesoftware, spraakassistenten, live ondertiteling, dicteertools en gesproken zoekopdrachten.
ASR staat voor automatic speech recognition, in het Nederlands automatische spraakherkenning. Sommige leveranciers schrijven het uit als automated speech recognition, maar dat betekent precies hetzelfde. Wilt u de korte versie, lees dan ons ASR-overzicht. Deze gids gaat dieper, van de engine tot de 70 jaar onderzoek erachter.
De term raakt vaak verstrikt met drie verwante begrippen, en elk beantwoordt een andere vraag:
- ASR (automatische spraakherkenning) zet spraakaudio om in tekst en beantwoordt de vraag "wat werd er gezegd?"
- Spraak-naar-tekst is dezelfde technologie onder haar productnaam en beantwoordt dus ook "wat werd er gezegd?"
- Stemherkenning (sprekerherkenning) stelt vast of controleert wie er spreekt en beantwoordt "wie zei het?"
- NLP (natuurlijke taalverwerking) interpreteert de betekenis van tekst en beantwoordt "wat betekent het?"
In de praktijk zijn ASR en spraak-naar-tekst inwisselbaar: ASR is de technische term, spraak-naar-tekst de productterm. Stemherkenning is de klassieke verwarring. Die herkent een spreker, zoals een telefoon die alleen voor de eigenaar ontgrendelt, terwijl ASR de woorden van iedereen uitschrijft, ongeacht wie ze uitspreekt. NLP komt daarna: eerst wordt de audio tekst, daarna vat NLP die samen, beantwoordt er een vraag over of handelt ernaar.
Hoe werkt ASR?
Moderne ASR is één neuraal netwerk dat audio rechtstreeks omzet in tekst, maar het grootste deel van zijn geschiedenis was het een keten van vijf afzonderlijke modellen.
De klassieke keten, die de geschiedenis hieronder stukje bij beetje opbouwt, werkt zo:
- Opnemen en voorbewerken. De audio wordt gedigitaliseerd, opgeschoond en in korte frames verdeeld, meestal enkele tientallen milliseconden lang.
- Kenmerkextractie. Elk frame wordt een compacte numerieke beschrijving van de energie op verschillende frequenties.
- Akoestisch model. Dit model koppelt die kenmerken aan fonemen, de basisklanken van een taal, en bepaalt welke klanken waarschijnlijk zijn uitgesproken.
- Taalmodel. Dit model weet welke woordreeksen waarschijnlijk zijn. Daarom schrijft een engine "recognize speech" en niet "wreck a nice beach": beide passen bij de audio, maar alleen het eerste past bij de taal.
- Decoder. De decoder doorzoekt de gecombineerde kansen van het akoestische model en het taalmodel en geeft de meest waarschijnlijke zin terug.
De omslag naar end-to-end
Sinds het midden van de jaren 2010 leren end-to-end deep-learningmodellen, tegenwoordig grotendeels gebouwd op de Transformer-architectuur, de weg van ruwe audio naar tekst rechtstreeks, getraind op honderdduizenden uren spraak. Er is geen handgemaakt uitspraakwoordenboek meer en geen apart akoestisch model: het netwerk leert alles tegelijk. Die omslag is de belangrijkste reden dat de nauwkeurigheid van transcriptie in de jaren 2010 meer vooruitging dan in de veertig jaar daarvoor.
Omdat deze modellen van enorme hoeveelheden audio leren, gaan ze veel beter om met accenten, achtergrondgeluid en natuurlijke gesprekken dan de oude ketens. Ze voorspellen in dezelfde stap ook interpunctie en hoofdletters, zodat een modern transcript leest als een gewoon document.
Hoe ASR-nauwkeurigheid wordt gemeten
De standaardmaatstaf is het woordfoutpercentage (WER): het machinetranscript wordt vergeleken met een zorgvuldig menselijk transcript, en elk vervangen, weggelaten of toegevoegd woord telt als fout. Een WER van 5% betekent ruwweg één fout per 20 woorden, oftewel 95% nauwkeurigheid. De WER hangt volledig af van de testaudio, en daarom zijn de nauwkeurigheidsclaims van twee leveranciers zelden vergelijkbaar. Onze gids legt de formule uit en bevat een rekentool.
Spraakherkenning in een oogopslag
- Uitgevonden
- Spraakherkenning werd in 1952 uitgevonden, toen het Audrey-systeem van Bell Labs de cijfers 0 tot 9 herkende, uitgesproken door één stem.
- Eerste consumentensoftware
- Dragon Dictate, in 1990 uitgebracht voor ongeveer 9.000 dollar, was het eerste spraakherkenningsproduct dat aan het publiek werd verkocht, en het had na elk woord een pauze nodig.
- Eerste woordenschat van 1.000 woorden
- In 1976 begreep Harpy van Carnegie Mellon 1.011 woorden, het doel dat DARPA voor zijn vijfjarige Speech Understanding Research-programma had gesteld.
- Menselijk niveau
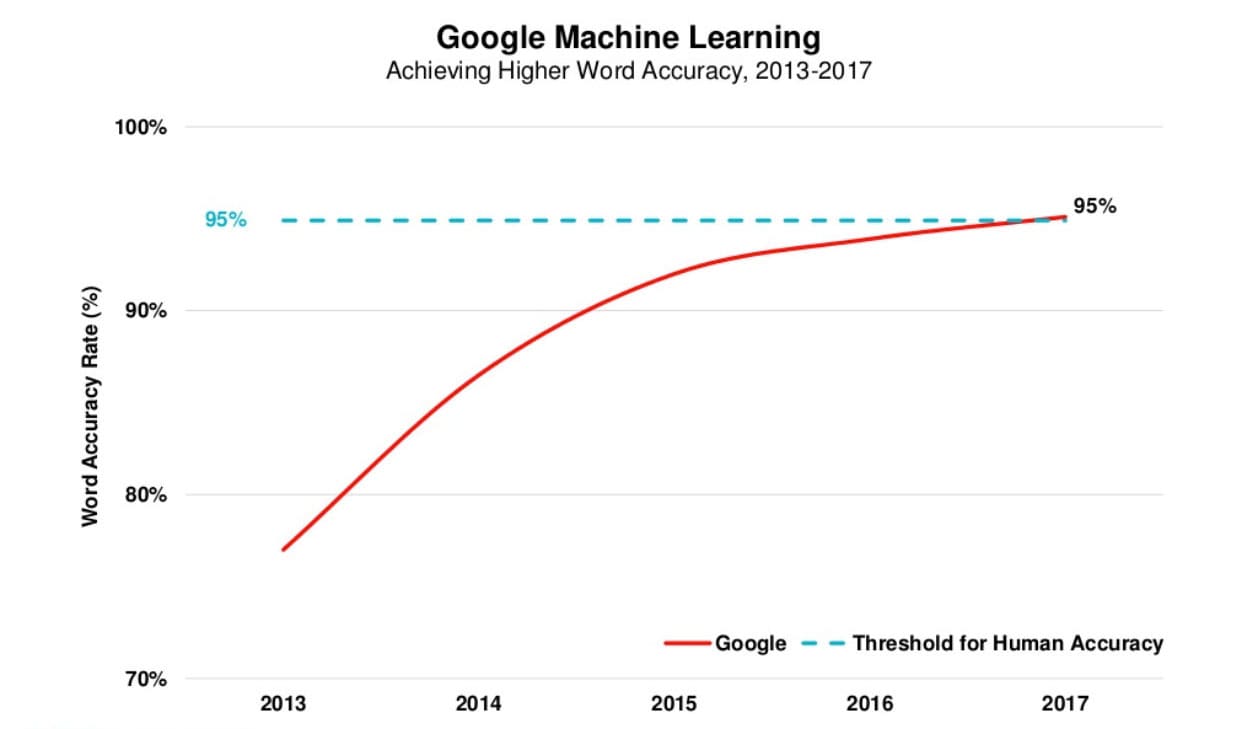
- In 2017 mat Microsoft een woordfoutpercentage van 5,1% op de Switchboard-telefoonbenchmark, gelijk aan de professionele transcribenten die dezelfde gesprekken uitwerkten.
- Open modellen
- Whisper van OpenAI, uitgebracht in september 2022, is getraind op 680.000 uur audio en transcribeert bijna 100 talen met gepubliceerde gewichten.
- Vandaag
- Sonix, opgericht in 2017, transcribeert 54+ talen met 99% nauwkeurigheid en levert een opname van een uur in ongeveer 5 tot 6 minuten terug.
De geschiedenis van spraakherkenning begint in 1952 bij Bell Labs
De eerste spraakherkenner werd in 1952 bij Bell Labs gebouwd en begreep precies tien woorden: de cijfers nul tot en met negen.
Audrey, de Automatic Digit Recognizer
K. H. Davis, R. Biddulph en S. Balashek bouwden Audrey uit analoge schakelingen die een relaisrek van 1,8 meter hoog vulden. Een spreker zei een cijfer in een telefoonhoorn, de machine mat de klinkerformanten en naast het herkende cijfer ging een lampje branden. Afgestemd op de stemmen van de ontwerpers haalde Audrey 97 tot 99 procent; bij vreemden ging het mis. Audrey heeft het laboratorium nooit verlaten, omdat een telefoniste die nummers draaide goedkoper was, maar het beslechtte wel de vraag of een machine überhaupt kon horen.
IBM's Shoebox en de jaren 60
In 1962 demonstreerde IBM Shoebox op de wereldtentoonstelling in Seattle. Het herkende 16 gesproken woorden, de tien cijfers en zes rekencommando's, en stuurde daarmee een telmachine aan. Laboratoria in de Verenigde Staten, Groot-Brittannië, Japan en de Sovjet-Unie bouwden herkenners voor klinkers en kleine woordenlijsten, en in 1968 beschreef Taras Vintsyuk dynamic time warping, waarmee een machine spraak in verschillende tempo's kon vergelijken. Tegen 1969 had het vakgebied wel ambitie maar geen theorie, en John Pierce van Bell Labs vergeleek het met plannen om van water benzine te maken.
DARPA's Speech Understanding Research-programma bracht de woordenschat voorbij de 1.000 woorden
Tussen 1971 en 1976 financierde DARPA de grootste spraakherkenningsinspanning tot dan toe, en Harpy van Carnegie Mellon haalde het doel van 1.000 woorden.
Het vijfjarige doel
Het Speech Understanding Research-programma vroeg om een systeem dat aaneengesloten spraak van meerdere sprekers kon begrijpen, met een woordenschat van 1.000 woorden en minder dan 10 procent fouten, en betaalde Carnegie Mellon, BBN, SRI en anderen om met elkaar te wedijveren. Harpy, in 1976 bij Carnegie Mellon voltooid, begreep 1.011 woorden, ruwweg de woordenschat van een driejarige, en was het enige systeem dat het doel haalde. De truc was een zoekmethode die onwaarschijnlijke woordreeksen vroegtijdig wegsnoeide in plaats van elke mogelijkheid af te wegen, een idee dat nog altijd de kern van elke decoder vormt.
De statistische wending
Diezelfde jaren brachten het idee voort dat de volgende 40 jaar alles zou verslaan. Aan Carnegie Mellon beschreef James Baker in zijn proefschrift uit 1975 het DRAGON-systeem, dat spraak behandelde als een hidden-markovmodel en waarschijnlijkheden, niet handgeschreven regels, liet bepalen welke woorden er waren gezegd. Bij IBM bouwde de groep van Fred Jelinek dezelfde aanpak in een dicteersysteem voor onderzoek en voegde n-gram-taalmodellen toe, zodat de herkenner het volgende woord uit de vorige twee kon raden. Bell Labs ging intussen van één stem naar vele en bouwde herkenners die met verschillende sprekers overweg konden, een vereiste voor telefoontoepassingen.
Hidden-markovmodellen maakten spraakherkenning in de jaren 80 statistisch
In de jaren 80 maakte patroonherkenning plaats voor waarschijnlijkheid, en de woordenschat groeide in tien jaar van een paar honderd woorden naar 20.000.
Hoe een hidden-markovmodel hoort
Een hidden-markovmodel probeert een klank niet aan een sjabloon te koppelen. Het vraagt welke reeks spraakklanken de ontvangen audio het meest waarschijnlijk heeft voortgebracht, en vervolgens welke reeks woorden die klanken het meest waarschijnlijk heeft voortgebracht. Trainen op opgenomen spraak stelt de waarschijnlijkheden vast, dus meer data betekent een betere herkenner, een eigenschap die enorm zou gaan tellen zodra het internet er was. Gecombineerd met n-gram-taalmodellen werd het HMM de standaardarchitectuur in elk onderzoekslab, en dat bleef zo totdat deep learning het in 2012 verdrong.
Tangora, Sphinx en de eerste producten
Tangora van IBM herkende halverwege de jaren 80 een woordenschat van 20.000 woorden, al had het een pauze tussen de woorden nodig en training per spreker. In 1988 was het Sphinx-systeem van Kai-Fu Lee aan Carnegie Mellon het eerste dat een grote woordenschat, aaneengesloten spraak en sprekeronafhankelijkheid in één herkenner combineerde. Dragon Systems, in 1982 opgericht door James en Janet Baker, begon herkenningssoftware voor personal computers te verkopen. Ook consumenten kwamen voor het eerst met stemherkenning in aanraking: de Julie-pop van Worlds of Wonder reageerde in 1987 op een handvol gesproken zinnen, en telefoonmaatschappijen testten spraakgestuurd bellen. Het speelgoed was primitief, maar het bracht de term "stemherkenning" in gewone huiskamers.
De jaren 90 brachten spraakherkenning naar de personal computer
Snellere processors maakten van dicteren software uit de winkel in plaats van een laboratoriumdemonstratie, en een gedeelde benchmark maakte vooruitgang goed meetbaar.
Van Dragon Dictate tot NaturallySpeaking
Dragon Dictate kwam in 1990 op de markt voor ongeveer 9.000 dollar. Het was het eerste spraakherkenningsproduct dat een gewone burger kon kopen, en het eiste een pauze na elk woord. In 1997 schrapte Dragon NaturallySpeaking die pauze: het herkende aaneengesloten spraak met zo'n 100 woorden per minuut op een thuis-pc, en IBM antwoordde datzelfde jaar met ViaVoice. Voor het eerst kon een advocaat, een arts of een schrijver tegen een computer praten en bruikbare tekst terugkrijgen, mits ze het programma trainden en corrigeerden.
Keuzemenu's en de eerste benchmarks
In 1996 lanceerde BellSouth VAL, een inbelbaar spraakportaal dat gesproken vragen beantwoordde, en elk geautomatiseerd telefoonsysteem waar u sindsdien ruzie mee hebt gehad stamt ervan af. Achter de schermen hielden DARPA en het National Institute of Standards and Technology jaarlijkse evaluaties op gedeelde opnamen zoals het Switchboard-telefooncorpus, en het woordfoutpercentage werd het getal dat elk lab rapporteerde. Vanaf dat moment is de geschiedenis van spraakherkenning grotendeels de geschiedenis van dat dalende getal.
De jaren 2000 verplaatsten spraakherkenning naar de cloud
De nauwkeurigheid bleef het grootste deel van het decennium steken rond 80 procent, totdat Google de herkenning van het apparaat naar zijn servers verhuisde.
Het plateau
In 2001 transcribeerden de beste systemen gedicteerde spraak met ruwweg 80 procent nauwkeurigheid, en de jaren daarna brachten verfijningen in plaats van sprongen. Dicteren op de desktop bleef een niche, de keuzemenu's bleven frustrerend en de onderzoeksfinanciering droogde op. Het hidden-markovmodel zat tegen zijn plafond aan, en de modellen die het zouden vervangen hadden de rekenkracht en de data die ze nodig hadden nog niet.
Google Voice Search
De telefonische inlichtingendienst GOOG-411 van Google, gelanceerd in 2007, verzamelde miljoenen gesproken zoekopdrachten. In november 2008 verscheen Google Voice Search als iPhone-app, en spraakherkenning veranderde van gedaante: de telefoon nam alleen op, en de herkenning draaide in de datacenters van Google op modellen die veel groter waren dan welk apparaat ook kon bevatten, getraind op 230 miljard woorden aan zoekopdrachten. Herkenning werd een dienst in plaats van een programma, en die vorm heeft ze nog steeds.