自動音声認識(ASR):
その仕組みと1952年からの音声認識の歴史

ASRは話し言葉を文字に変える技術です。このガイドでは、ASRとは何か、現代のエンジンがどう動くのか、精度をどう測るのかを解説し、1952年にベル研究所で10個の数字だけを聞き取ったAudreyから、54以上の言語を扱う現在までの音声認識の歴史をたどります。

ASR(自動音声認識)とは?

自動音声認識(ASR)とは、話し言葉を文字に変換する技術です。 ASRシステムは音声信号を受け取り、そこに含まれる音を分析して、最も可能性の高い単語の並びを予測します。文字起こしソフト、音声アシスタント、リアルタイム字幕、ディクテーションツール、音声検索などを支えているのがこの技術です。

ASRはautomatic speech recognitionの略で、automated speech recognitionと表記するベンダーもありますが、意味は同じです。2分で概要をつかみたい方はASRの概要をご覧ください。このガイドでは、エンジンの仕組みから、その背後にある70年分の研究まで、さらに踏み込んで解説します。

ASRはよく似た3つの用語と混同されがちですが、それぞれが答える問いは異なります。

  • ASR(自動音声認識) 音声を文字に変換し、「何が話されたか」に答えます。
  • 音声テキスト変換(Speech-to-text) 同じ技術を製品名として呼んだもので、やはり「何が話されたか」に答えます。
  • 話者認識(声紋認証) 誰が話しているかを特定または照合し、「誰が言ったか」に答えます。
  • NLP(自然言語処理) テキストの意味を解釈し、「それは何を意味するか」に答えます。

実際には、ASRと音声テキスト変換は同じ意味で使われます。ASRは技術用語、音声テキスト変換は製品側の呼び方です。よく混同されるのが話者認識です。スマートフォンが持ち主の声でだけロックを解除するように、話者認識は話し手を見分ける技術です。一方のASRは、誰が話したかを問わず、その言葉を文字にします。NLPはその後段に位置します。まず音声が文字になり、次にNLPがそれを要約したり、内容についての質問に答えたり、それに基づいて処理を実行したりします。

ASRはどのように動くのか?

現代のASRは、音声をそのまま文字に変換する一つのニューラルネットワークです。しかし歴史の大半において、ASRは5つの独立したモデルをつないだパイプラインでした。

従来のパイプラインは次のように動きます。以下の歴史は、この各部品が一つずつ生まれていく過程でもあります。

  1. 音声の取り込みと前処理。 音声をデジタル化してノイズなどを整え、通常は数十ミリ秒ほどの短いフレームに切り分けます。
  2. 特徴量抽出。 各フレームを、周波数ごとのエネルギーを表すコンパクトな数値データに変換します。
  3. 音響モデル。 特徴量を、言語の基本的な音の単位である音素に対応づけ、どの音が発せられた可能性が高いかを判断します。
  4. 言語モデル。 どの単語の並びが自然かを知っているモデルです。英語のエンジンが「wreck a nice beach」ではなく「recognize speech」と書き出せるのはこのためで、どちらも音としては当てはまりますが、言葉として自然なのは一方だけです。
  5. デコーダ。 音響モデルと言語モデルの確率を組み合わせて探索し、最も可能性の高い文を出力します。

エンドツーエンドへの転換

2010年代半ば以降、エンドツーエンドのディープラーニングモデルが、生の音声から文字への対応を直接学習するようになりました。現在その多くはTransformerアーキテクチャを基盤とし、数十万時間分の音声で学習されています。手作業で作る発音辞書も、独立した音響モデルもありません。ネットワークがそのすべてを一度に学習します。2010年代の10年間で、文字起こしの精度がそれ以前の40年間よりも大きく向上したのは、主にこの転換によるものです。

こうしたモデルは膨大な量の音声から学習するため、なまりや背景雑音、自然な会話を、パイプライン型のシステムよりはるかにうまく扱えます。さらに句読点や大文字小文字も同じ処理の中で予測するため、現代の文字起こしはそのまま文書として読めます。

ASRの精度の測り方

標準的な指標は単語誤り率(WER)です。機械による文字起こしを人が丁寧に作成した文字起こしと比較し、置換・脱落・挿入された単語をすべて誤りとして数えます。WERが5%なら、おおよそ20語に1つの誤り、つまり精度95%を意味します。WERはテストに使う音声に完全に左右されるため、2社の精度の数値を単純に比べられることはほとんどありません。計算式と計算ツールは当社のガイドで紹介しています。

ひと目でわかる音声認識の歴史

誕生
音声認識が誕生したのは1952年です。ベル研究所のAudreyというシステムが、一人の話者が発声した0から9までの数字を聞き分けました。
初の市販ソフト
1990年に約9,000ドルで発売されたDragon Dictateは、一般向けに販売された初の音声認識製品でした。ただし、単語を一つ言うたびに間を置く必要がありました。
初の1,000語認識
カーネギーメロン大学のHarpyは1976年に1,011語を理解しました。これは、DARPAが5年間の音声理解研究プログラムに掲げた目標値でした。
人間と同等の精度
2017年、Microsoftは電話音声ベンチマークSwitchboardで5.1%の単語誤り率を記録し、同じ通話を書き起こしたプロの文字起こし担当者と肩を並べました。
オープンモデル
2022年9月に公開されたOpenAIのWhisperは、68万時間の音声で学習され、100近い言語を文字起こしできます。モデルの重みも公開されています。
現在
2017年創業のSonixは、54以上の言語を99%の精度で文字起こしし、1時間の録音を約5〜6分で返します。

音声認識の歴史は1952年、ベル研究所で始まった

最初の音声認識機は1952年にベル研究所で作られ、理解できる単語はちょうど10個、0から9までの数字だけでした。

自動数字認識機Audrey

K. H. Davis、R. Biddulph、S. Balashekの3人は、高さ6フィートのリレーラックを埋め尽くすアナログ回路でAudreyを組み上げました。話者が電話の受話器に向かって数字を言うと、機械が母音のフォルマントを測り、聞き取った数字の横のランプが点灯する仕組みです。設計者たちの声に合わせて調整した状態では97から99パーセントの正答率を出しましたが、見知らぬ人の声にはまるで歯が立ちませんでした。人間の交換手が番号をダイヤルするほうが安上がりだったため、Audreyが研究所の外に出ることはありませんでした。それでも、機械は音声を聞き取れるのかという問いには、これで決着がついたのです。

IBMのShoeboxと1960年代

1962年、IBMはシアトル万国博覧会でShoeboxを披露しました。10個の数字と6つの算術コマンドを合わせた16語を聞き取り、その音声で加算機を動かしてみせたのです。アメリカ、イギリス、日本、ソ連の研究所が母音や小さな単語リスト向けの認識機を作り、1968年にはTaras Vintsyukが、話す速さの違う音声どうしを機械が比較できるようにする動的時間伸縮法(DTW)を発表しました。それでも1969年の時点で、この分野には野心こそあれ理論がなく、ベル研究所のJohn Pierceは水をガソリンに変える計画になぞらえたほどでした。

DARPAの音声理解研究プログラムで語彙が1,000語を超えた

1971年から1976年にかけて、DARPAは当時としては最大規模の音声認識研究に資金を投じ、カーネギーメロン大学のHarpyが目標の1,000語に到達しました。

5年間の目標

音声理解研究プログラムが求めたのは、複数の話者による連続音声を1,000語の語彙で、誤り率10パーセント未満で理解できるシステムでした。資金を受けたカーネギーメロン大学、BBN、SRIなどがその実現を競いました。1976年にカーネギーメロン大学で完成したHarpyは、3歳児の語彙にほぼ相当する1,011語を理解し、目標を達成した唯一のシステムとなりました。決め手は、あらゆる可能性を検討する代わりに、見込みの薄い単語列を早い段階で枝刈りする探索手法で、この発想は今もあらゆるデコーダの中核にあります。

統計的アプローチの登場

同じ時期に、その後40年にわたって他のあらゆる手法を凌駕することになるアイデアが生まれました。カーネギーメロン大学では、James Bakerが1975年の学位論文でDRAGONシステムを発表しました。音声を隠れマルコフモデルとして扱い、人が書いたルールではなく確率に、どの単語が話されたかを判定させる仕組みです。IBMではFred Jelinekのグループが同じ手法を研究用のディクテーションシステムに組み込み、さらにnグラム言語モデルを加えて、直前の2語から次の単語を推測できるようにしました。一方のベル研究所は、一人の声から多くの声へと対象を広げ、電話アプリケーションに欠かせない、話者を問わず動作する認識機を作り上げました。

1980年代、隠れマルコフモデルが音声認識を統計的手法に変えた

1980年代にはパターンマッチングが確率に取って代わられ、語彙は10年のうちに数百語から2万語へと広がりました。

隠れマルコフモデルはどう聞くのか

隠れマルコフモデルは、音をテンプレートに照合しようとはしません。受け取った音声を最も高い確率で生み出したのはどの音素列か、そしてその音素列を最も高い確率で生み出したのはどの単語列か、と問いかけます。確率は録音された音声で学習して決めるため、データが増えるほど認識機は賢くなります。この性質は、インターネットの登場後にとてつもなく大きな意味を持つことになります。nグラム言語モデルと組み合わせたHMMは、あらゆる研究所で標準のアーキテクチャとなり、2012年にディープラーニングに取って代わられるまでその座を守りました。

Tangora、Sphinx、そして最初の製品

IBMのTangoraは1980年代半ばまでに2万語の語彙を認識できるようになりましたが、単語ごとに間を置く必要があり、話者ごとの学習も欠かせませんでした。1988年、カーネギーメロン大学でKai-Fu Leeが開発したSphinxは、大語彙、連続音声、話者非依存の3つを一つの認識機で初めて両立させました。1982年にJames BakerとJanet Bakerが設立したDragon Systemsは、パソコン向けの音声認識ソフトの販売を始めます。音声認識が消費者の手に届いたのもこの時期です。1987年にはWorlds of Wonder社の人形Julieがいくつかの決まった言葉に返事をし、電話会社は音声ダイヤルの試験を行いました。おもちゃとしては素朴なものでしたが、「音声認識」という言葉を一般家庭に持ち込んだのです。

1990年代、音声認識がパソコンにやってきた

プロセッサの高速化により、ディクテーションは研究所のデモから店頭に並ぶパッケージソフトになり、共通のベンチマークのおかげで進歩を測りやすくなりました。

Dragon DictateからNaturallySpeakingへ

Dragon Dictateは1990年に約9,000ドルで発売されました。一般の人が買える初めての音声認識製品でしたが、単語を一つ言うたびに間を置かなければなりませんでした。1997年のDragon NaturallySpeakingで、単語ごとに間を置く必要はなくなりました。家庭用PCで毎分100語ほどの連続音声を認識でき、IBMも同じ年にViaVoiceで対抗しました。弁護士や医師、作家がコンピュータに話しかけて使える文章を得られるようになったのは、これが初めてです。ただし、学習させて誤りを直す手間は必要でした。

自動音声応答と最初のベンチマーク

1996年、BellSouthは電話をかけると音声の質問に答えてくれるボイスポータルVALを開始しました。以来、皆さんが電話口で格闘してきた自動音声応答システムはすべて、その子孫にあたります。舞台裏では、DARPAと米国立標準技術研究所(NIST)がSwitchboard電話コーパスなどの共通の録音を使って毎年評価を実施し、単語誤り率がどの研究所も報告する指標になりました。それ以降の音声認識の歴史は、おおむねこの数字が下がっていく歴史です。

2000年代、音声認識はクラウドへ移った

精度はこの10年の大半を80パーセント前後で足踏みしていましたが、Googleが認識処理を端末から自社サーバーへ移したことで流れが変わりました。

停滞期

2001年までに、最良のシステムはディクテーション音声をおよそ80パーセントの精度で文字にできるようになっていましたが、それに続く数年は飛躍ではなく小幅な改良の時代でした。デスクトップのディクテーションはニッチにとどまり、自動音声応答は相変わらず苛立たしく、研究資金は細っていきました。隠れマルコフモデルは天井に近づいており、それに取って代わるはずのモデルには、まだ必要な計算能力もデータもなかったのです。

Google Voice Search

2007年に始まったGoogleの電話番号案内サービスGOOG-411は、数百万件の音声クエリを集めました。そして2008年11月、Google Voice SearchがiPhoneアプリとして登場し、音声認識のあり方が変わります。スマートフォンは録音するだけで、認識はGoogleのデータセンターで行われるようになったのです。そこでは、2,300億語の検索クエリで学習した、どの端末にも収まらないほど大きなモデルが動いていました。音声認識はプログラムではなくサービスになり、今もその形が続いています。

年表

音声認識の歴史を 年ごとにたどる

下の出来事にはすべて年が付いています。それぞれがなぜ重要だったのかは、この表の前後の節で解説しています。

年出来事なぜ重要か
1952ベル研究所がAudreyを開発音声を認識した最初の機械。一人の話者の0から9の数字
1962IBMがShoeboxを披露16語。シアトル万博で一般公開
1971DARPAが音声理解研究プログラムを開始5年間の資金と1,000語の目標
1976カーネギーメロン大学のHarpyが目標を達成1,011語。デコーダが今も使う枝刈り探索
1986IBMのTangoraが2万語に到達隠れマルコフモデルとnグラム言語モデルが標準に
1988カーネギーメロン大学のSphinx連続音声、話者非依存、大語彙を一つのシステムで
1990Dragon Dictate発売消費者向けに販売された初の音声認識製品
1997Dragon NaturallySpeakingとIBM ViaVoice家庭用PCで毎分約100語の連続ディクテーション
2008Google Voice Search認識がクラウドへ移り、あらゆるクエリから学習
2011AppleがSiriを発表主流のスマートフォンに音声アシスタント
2012ディープニューラルネットワークが混合ガウスモデルを置き換え誤り率が一気に最大3分の1下がる
2016MicrosoftがSwitchboardで5.9%を報告会話ベンチマークで初めて人間と同等を主張
2017Microsoft 5.1%、IBM 5.5%、Google 4.9%。Transformerが発表される同等精度をめぐる競争が終わり、次のアーキテクチャが登場
2020wav2vec 2.0とConformer自己教師あり学習でラベル付きデータの必要量が減る
2022OpenAIがWhisperを公開学習68万時間、100近い言語、重みを公開

2010年代、ディープラーニングが誤り率を半分以下に下げた

2011年から2017年にかけて、電話での会話音声に対する単語誤り率は10パーセント台前半から5パーセント前後まで下がり、音声アシスタントが家庭に入り込みました。

Siriと音声アシスタント

Appleは2011年10月にiPhone 4SとともにSiriを発表し、Amazonは2014年にEchoのAlexaで、Googleは2016年にGoogle Homeで続きました。これらのアシスタントの意義は、Google Voice Searchと同じくクラウドで動いていた認識技術そのものより、人々に根付かせた習慣にありました。何億もの人が毎日機械に話しかけるようになり、その発話の一つひとつが学習データになったのです。

ニューラルネットワークへの転換

2012年、Geoffrey Hintonを含むMicrosoft、Google、IBM、トロント大学の研究者が共同論文を発表し、音響モデル側にディープニューラルネットワークを使うと、HMMシステムが25年間使ってきた混合ガウスモデルに比べて誤り率が最大で3分の1下がることを示しました。2014年にはBaiduのDeep Speechがさらに踏み込み、発音辞書も人手で組んだパイプラインも使わずに、音声から文字までを一つのリカレントネットワークでエンドツーエンドに学習しました。音声認識はディープラーニングの問題となり、GPUとデータを最も多く持つ研究所が抜け出していきました。

人間と同等の精度をめぐる競争

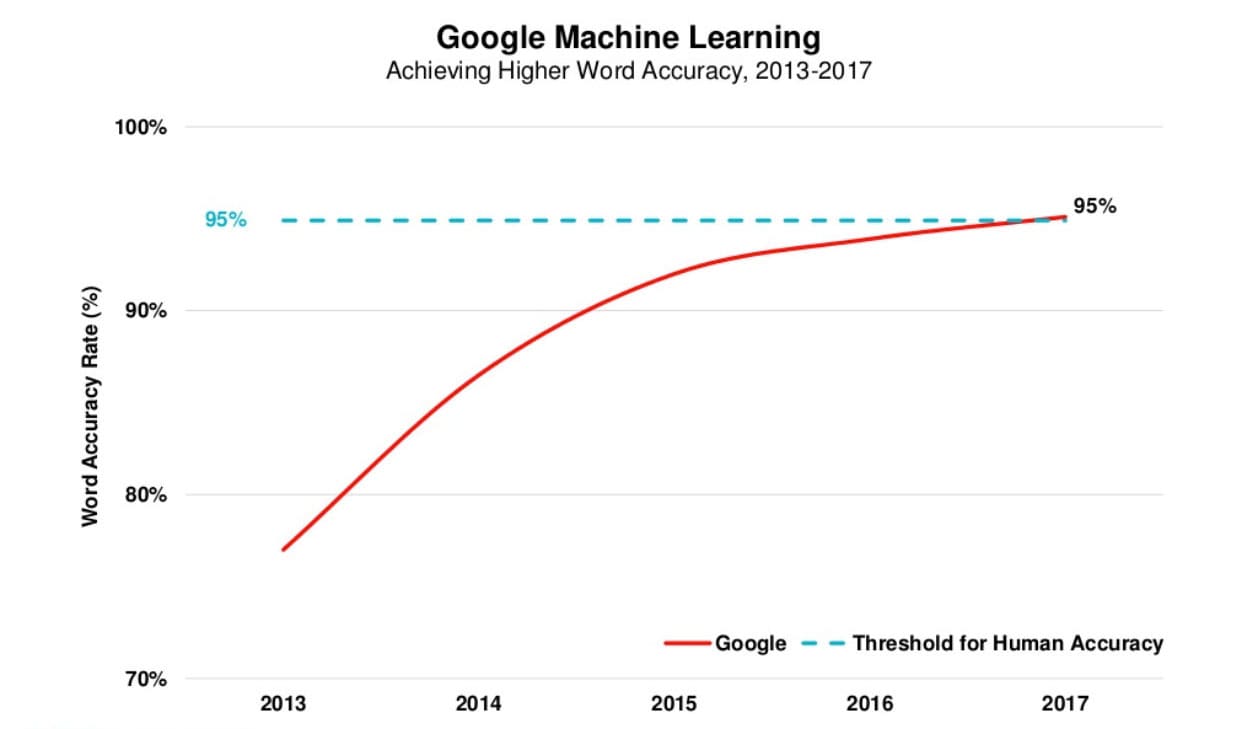
電話での会話を録音したSwitchboardベンチマークが、いわば得点表になりました。2016年10月、Microsoftは単語誤り率5.9パーセントを報告しました。同じ通話を依頼したプロの文字起こし担当者と同じ数値で、Microsoftはこれを人間と同等の精度と呼びました。IBMは2017年3月に5.5パーセントで応じ、Googleは同年5月に自社のテストセットで4.9パーセントを発表、そして2017年8月にはMicrosoftが、より厳密な人間の基準に対して5.1パーセントを達成しました。下のグラフはMary Meekerの2017年版Internet Trendsレポートからのもので、Googleの単語認識精度が95パーセントを超えた様子を示しています。同じ年にTransformerアーキテクチャが発表され、3年もたたないうちに音声の分野も席巻しました。

Googleの単語正解率が95パーセントを超える様子を示すグラフ。Mary Meekerの2017年版Internet Trendsレポートより

WhisperとTransformerで文字起こしはコモディティになった

自己教師あり学習と一つのオープンモデルによって、高精度な多言語文字起こしは巨大テック企業だけの能力から、どんな製品でも提供できるものに変わりました。

ラベルなし音声からの学習

2010年代のボトルネックはラベル付きデータでした。学習に使う音声には1時間ごとに人間の書き起こしが必要だったのです。2020年、Facebook AIのwav2vec 2.0は、まず書き起こしのない生の音声から音声表現を学習し、わずか10分のラベル付き音声があれば実用的な認識機にファインチューニングできることを示しました。同じ年に発表されたGoogleのConformerは、畳み込みとTransformerのアテンションを組み合わせ、標準ベンチマークの記録を塗り替えました。この2つが揃ったことで、Transformerは音声の既定のアーキテクチャとなり、新しい言語を追加するコストが下がりました。

Whisper

2022年9月、OpenAIはWhisperを公開しました。ウェブから集めた68万時間の音声で学習し、100近い言語に対応し、モデルの重みは誰でも動かせるよう公開されました。あらゆるベンチマークで最高精度というわけではありませんでしたが、それまでの学術モデルにはなかった、なまりや背景雑音、専門用語への強さがあり、しかも無料でした。数か月のうちに何千もの製品に組み込まれ、文字起こし企業にとっての問いは、音声を認識できるかどうかから、文字起こしの周りに何を作るかへと移りました。

自動言語識別にも独自の歴史がある

どの言語が話されているかを知ることは、どの単語が話されたかを知ることとは別の問題で、解決にはこちらも50年を要しました。

音素の統計からi-vectorへ

1970年代に行われた最初の言語識別の実験では、音の統計的な特徴から言語を見分けていました。1990年代にはこれが音素配列論的(phonotactic)アプローチに発展します。まず音素認識機を走らせ、どの言語の音素パターンに最もよく当てはまるかを判定する手法で、米国立標準技術研究所(NIST)は1996年に正式な言語認識評価を始めました。2010年代には、話者認識から借りてきた、録音を簡潔に要約するi-vectorによって、数秒の音声から言語を言い当てられるシステムが生まれました。

モデルに組み込まれた識別

現代の多言語認識機は、この2つの問題を一つにまとめています。Whisperとその後継モデルは、文字起こしの最初のトークンとして言語を予測するため、言語識別は独立した工程ではなく認識の副産物になりました。一つの製品が言語ごとに別々の認識機を持たずに54以上の言語を扱えるのはこのためで、話す言語が文字起こしの制約ではなくなったのも、これが理由です。

ASRの現在地

明瞭でよく録れた音声なら、現代のASRはほぼ完成の域にあります。そのため今エンジンの差が出るのは、難しい音声への対応と、文字起こしができた後に何ができるかです。

本格的なエンジンどうしのベンチマークのスコアはほぼ横並びになりました。ベンダーに問うべきなのは、もはや「精度はどれくらいか」ではなく、自分の音声をどう扱い、文字起こしをどう活かせるかです。2026年の実運用のASRの例として、Sonixをご紹介します。

精度は誠実に測る

Sonixは明瞭で高品質な音声で99%の精度に達し、自動文字起こしで1時間の録音を約5〜6分で返します。当社の数値も含め、どの精度の数値も音声次第です。本当に意味のあるベンチマークは、お手元の録音で試した結果だけです。

対応言語

Sonixは54以上の言語で文字起こしと翻訳ができます。Whisper世代のモデルによって、幅広い言語への対応は特別なものではなく標準になりました。各言語の精度は、その言語の学習用音声がどれだけあるかに比例します。

リアルタイム

リアルタイム文字起こしは、話している最中に2秒以内で字幕を配信します。これはエンドツーエンド型アーキテクチャがもたらした直接の成果です。

誰が何を話したか

今のエンジンは話者を自動で分離できます。この処理は話者ダイアライゼーションと呼ばれ、その仕組みとまだ苦手な場面は話者ダイアライゼーションのガイドで解説しています。

文字起こしの先へ

要約、チャプター、翻訳によって、文字起こしのテキストは実際に活用できるものになります。ASRは最終製品ではなく、内容を理解するためのパイプラインの第一段階になりました。Sonixでは最初の30分間を無料でお使いいただけるので、ご自身の音声でお試しください。

ASRのこれから:難しい音声、プライバシー、そして理解へ

ベンチマークの競争は終わり、残っているのは地味な課題です。難しい音声、プライベートな環境での運用、そして言葉を理解へとつなげることです。

難しいケース

話者の重なり、離れた位置のマイク、強いなまり、文の途中での言語の切り替え、専門用語は、当社を含むどのエンジンでも今なお精度を下げます。さらにエンドツーエンドモデルは新たな失敗の型も生みました。無音や雑音の区間で、もっともらしい文章を作り出してしまう(ハルシネーション)ことがあるのです。これは解決済みではなく、今まさに研究が進められている課題です。

端末上での認識

プライバシーと速度の両面から、今後はクラウドではなくスマートフォンやノートPC、イヤホン上で動く認識が増えていくでしょう。Whisperクラスのモデルを小型化した圧縮技術が、音声をどこにも送らないハードウェアにも高精度な認識をもたらしつつあります。

文字起こしから理解へ

大規模言語モデルは今や会議を要約し、インタビューについての質問に答え、講義をもとにフォローアップを下書きします。それがうまくいくのは、土台にある文字起こしが正確だからにほかなりません。インターフェースとしての音声は広がり続けています。音声があらゆる画面に取って代わるという主張は1990年代から繰り返されてきましたが、私たちとしては、人が実際に話した内容を確実に記録できれば十分だと考えています。

よくある質問

ASRと音声認識の 疑問にお答えします

ASRは何の略ですか?

ASRはautomatic speech recognition(自動音声認識)の略で、話し言葉を文字に変換する技術です。automated speech recognitionと表記されることもありますが、意味は同じです。文字起こしの分野では、ASR、音声認識、音声テキスト変換はほぼ同じ意味で使われます。

ASRは音声テキスト変換や話者認識と同じですか?

ASRと音声テキスト変換は同じものです。ASRは技術用語で、音声テキスト変換はその出力を指す呼び方です。話者認識は別の技術です。声の特徴から誰が話しているかを特定するもので、スマートフォンが持ち主の声でロックを解除するのはこの仕組みです。一方ASRは、誰が話したかに関係なく、話された内容を文字にします。

ASRとNLPはどう違いますか?

ASRは音声を文字に変換し、NLP(自然言語処理)は文字の意味を解釈します。両者は順番に働きます。音声アシスタントに質問すると、まずASRが言葉を文字にし、次にNLPが意図を読み取って答えを導きます。Sonixでは、ASRが文字起こしを作成し、NLPを活用した機能がそれを要約・分析します。

ASRの精度はどのくらいですか?

明瞭な会話の録音であれば、最良のシステムはプロの文字起こし担当者に並びます。Microsoftは2017年にSwitchboardベンチマークで5.1%の単語誤り率を記録し、モデルはその後も改善を続けています。Sonixは良好な音声で99%の精度に達します。ただし背景雑音、離れた位置のマイク、強いなまり、話者の重なりは今も誤り率を押し上げるため、ご自身の録音で試してみることをおすすめします。

音声認識はいつ、どこで発明されたのですか?

1952年です。K. H. Davis、R. Biddulph、S. Balashekがベル研究所で作ったAudreyシステムが、一人の話者が発声した0から9までの数字を認識しました。1962年にはIBMのShoeboxが16語で続き、初めて購入できる製品となったDragon Dictateは1990年に登場しました。

音声認識を発明したのは誰ですか?

特定の一人ではありません。1952年にベル研究所の3人の技術者が最初の認識機Audreyを作りました。1970年代にはJames BakerとFred Jelinekが隠れマルコフモデルで音声認識を統計的な手法に変え、1988年にはKai-Fu LeeのSphinxが連続音声と話者非依存を実現し、2012年にはGeoffrey Hintonの共同研究者たちがディープラーニングを持ち込みました。

最初の音声認識ソフトは何ですか?

Dragon Systemsが1990年に約9,000ドルで発売したDragon Dictateが、一般向けに販売された初の音声認識ソフトです。単語と単語の間に間を置く必要がありました。1997年発売のDragon NaturallySpeakingは、家庭用コンピュータ向けの連続音声ディクテーションソフトとして初めて広く普及しました。

ASRは英語以外の言語も文字起こしできますか?

はい。多言語の学習データによって幅広い言語への対応が標準となり、現代のシステムは数十の言語を扱えます。Sonixはスペイン語、フランス語、ドイツ語、中国語(標準語)、日本語、アラビア語など、54以上の言語で文字起こしと翻訳ができます。精度は言語によって異なり、各言語の学習用音声がどれだけあるかに左右されます。

今すぐ始める

Sonixを無料で試す

Sonixは、オーディオおよびビデオファイルを文字起こし、タイムスタンプ付与、整理することで、メディアの検索、編集、共有を可能にします。

30 minutes 分間の無料文字起こしが含まれています

続きを読む

99% の精度。 一言一句を大切に。

54以上の言語対応の AI 文字起こしと翻訳。

30 minutes 無料
クレジットカード不要
いつでもキャンセル可能