 Stephen Hopkins
Was ist ASR?
Automatische Spracherkennung (ASR, Automatic Speech Recognition) ist die Technologie, die gesprochene Sprache in geschriebenen Text umwandelt. Ein ASR-System nimmt ein Audiosignal auf, analysiert die darin enthaltenen Laute und berechnet die wahrscheinlichste Wortfolge. Darauf bauen Transkriptionssoftware, Sprachassistenten, Live-Untertitel, Diktierprogramme und die Sprachsuche auf.
ASR steht für Automatic Speech Recognition, also automatische Spracherkennung. Manche Anbieter schreiben auch Automated Speech Recognition, gemeint ist dasselbe. Die Kurzfassung in zwei Minuten finden Sie in unserem ASR-Überblick. Dieser Leitfaden geht tiefer, von der Engine bis zu 70 Jahren Forschung dahinter.
Der Begriff wird oft mit drei verwandten Begriffen verwechselt, und jeder beantwortet eine andere Frage:
- ASR (automatische Spracherkennung) wandelt Sprachaufnahmen in Text um und beantwortet die Frage „Was wurde gesagt?“
- Speech-to-Text ist dieselbe Technologie unter ihrem Produktnamen und beantwortet ebenfalls „Was wurde gesagt?“
- Stimmerkennung (Sprechererkennung) identifiziert oder verifiziert, wer spricht, und beantwortet „Wer hat es gesagt?“
- NLP (Verarbeitung natürlicher Sprache) deutet die Bedeutung von Text und beantwortet „Was bedeutet es?“
In der Praxis sind ASR und Speech-to-Text austauschbar: ASR ist der Fachbegriff aus der Technik, Speech-to-Text die Produktbezeichnung. Verwechselt wird vor allem die Stimmerkennung. Sie erkennt eine Person, so wie sich ein Smartphone nur für seinen Besitzer entsperrt, während ASR die Worte jedes Menschen transkribiert, ganz gleich, wer spricht. NLP setzt danach an: Erst wird aus dem Audio Text, dann fasst NLP ihn zusammen, beantwortet Fragen dazu oder leitet Aktionen daraus ab.
Wie funktioniert ASR?
Moderne ASR ist ein einziges neuronales Netz, das Audio direkt in Text übersetzt. Den Großteil ihrer Geschichte war sie jedoch eine Kette aus fünf getrennten Modellen.
Die klassische Verarbeitungskette, die die Geschichte weiter unten Stück für Stück aufbaut, funktioniert so:
- Aufnahme und Vorverarbeitung. Das Audio wird digitalisiert, bereinigt und in kurze Frames zerlegt, meist einige Dutzend Millisekunden lang.
- Merkmalsextraktion. Jeder Frame wird zu einer kompakten numerischen Beschreibung seiner Energie in verschiedenen Frequenzbereichen.
- Akustisches Modell. Dieses Modell ordnet die Merkmale Phonemen zu, den kleinsten Lauteinheiten einer Sprache, und ermittelt, welche Laute wahrscheinlich gesprochen wurden.
- Sprachmodell. Dieses Modell weiß, welche Wortfolgen wahrscheinlich sind. Deshalb schreibt eine Engine „eine Lehre daraus ziehen“ und nicht „eine Leere daraus ziehen“: Beides passt zum Audio, aber nur eines ergibt in der Sprache Sinn.
- Decoder. Der Decoder durchsucht die kombinierten Wahrscheinlichkeiten aus akustischem Modell und Sprachmodell und gibt den wahrscheinlichsten Satz aus.
Der Wechsel zu End-to-End
Seit Mitte der 2010er lernen End-to-End-Modelle aus dem Deep Learning, inzwischen meist auf Basis der Transformer-Architektur, den Weg vom rohen Audio zum Text direkt. Trainiert werden sie mit Hunderttausenden Stunden Sprache. Es gibt kein handgebautes Aussprachewörterbuch und kein separates akustisches Modell mehr, das Netz lernt alles auf einmal. Dieser Umbruch ist der Hauptgrund, warum die Genauigkeit von Transkriptionen in den 2010ern stärker gestiegen ist als in den vier Jahrzehnten davor.
Weil diese Modelle aus riesigen Mengen Audio lernen, kommen sie mit Akzenten, Hintergrundgeräuschen und natürlichen Gesprächen weit besser zurecht als die alten Verarbeitungsketten. Zeichensetzung und Groß- und Kleinschreibung erledigen sie im selben Durchgang, sodass sich ein modernes Transkript wie ein fertiges Dokument liest.
So misst man die ASR-Genauigkeit
Die Standardkennzahl ist die Wortfehlerrate (WER, Word Error Rate): Das maschinelle Transkript wird mit einem sorgfältig erstellten menschlichen Transkript verglichen, und jedes ersetzte, ausgelassene oder eingefügte Wort zählt als Fehler. Eine WER von 5 % bedeutet ungefähr einen Fehler alle 20 Wörter, also 95 % Genauigkeit. Die WER hängt vollständig vom Testaudio ab, deshalb lassen sich die Genauigkeitsangaben zweier Anbieter selten vergleichen. Unser Leitfaden erklärt die Formel und enthält einen Rechner.
Spracherkennung auf einen Blick
- Erfunden
- Die Spracherkennung wurde 1952 erfunden, als das Audrey-System der Bell Labs die Ziffern 0 bis 9 einer einzelnen Stimme erkannte.
- Erste Software für Endkunden
- Dragon Dictate, 1990 für rund 9.000 Dollar erschienen, war das erste Spracherkennungsprodukt für die Öffentlichkeit, und es brauchte nach jedem Wort eine Pause.
- Erstmals 1.000 Wörter
- 1976 verstand Harpy von der Carnegie Mellon University 1.011 Wörter, genau das Ziel, das die DARPA für ihr fünfjähriges Programm Speech Understanding Research gesetzt hatte.
- Auf Augenhöhe
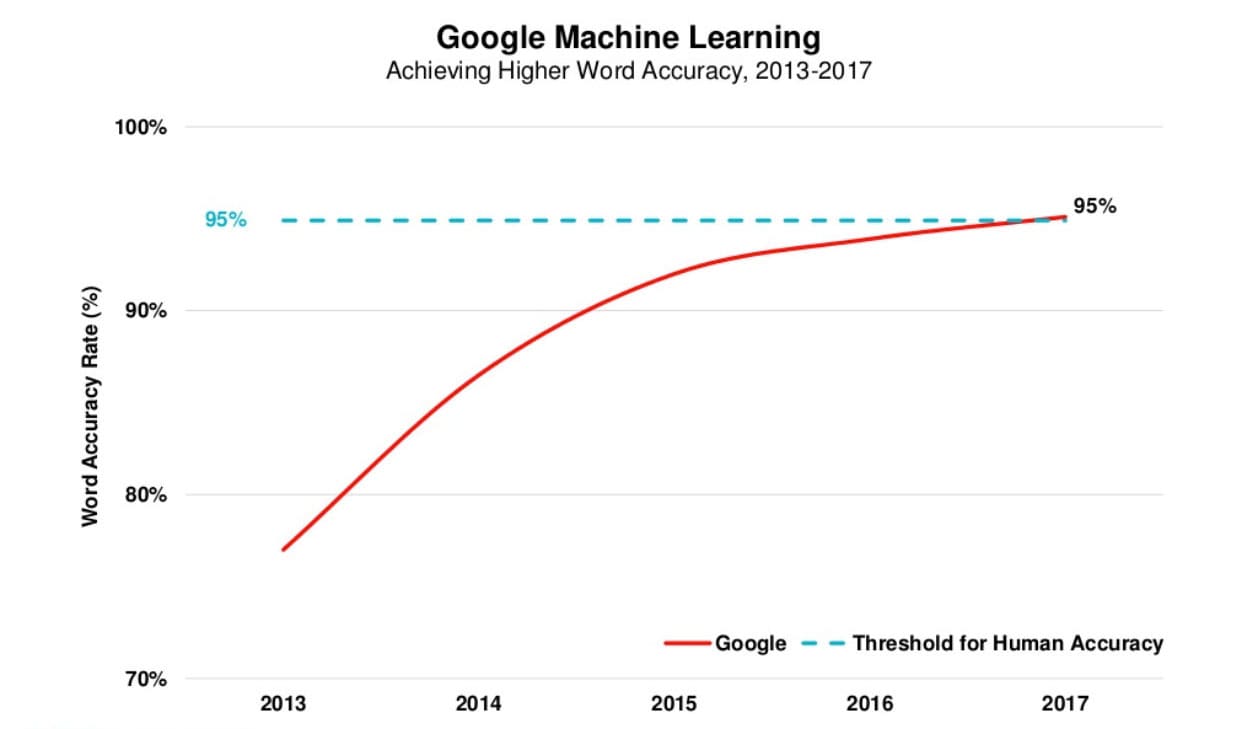
- 2017 maß Microsoft auf dem Telefon-Benchmark Switchboard eine Wortfehlerrate von 5,1% und lag damit gleichauf mit den professionellen Transkribenten, die dieselben Gespräche bearbeitet hatten.
- Offene Modelle
- Whisper von OpenAI, veröffentlicht im September 2022, wurde mit 680.000 Stunden Audio trainiert und transkribiert fast 100 Sprachen, die Gewichte sind frei verfügbar.
- Heute
- Sonix wurde 2017 gegründet, transkribiert 54+ Sprachen mit 99% Genauigkeit und liefert eine einstündige Aufnahme in etwa 5 bis 6 Minuten.
Die Geschichte der Spracherkennung beginnt 1952 in den Bell Labs
Der erste Spracherkenner entstand 1952 in den Bell Labs und verstand genau zehn Wörter: die Ziffern null bis neun.
Audrey, der Automatic Digit Recognizer
K. H. Davis, R. Biddulph und S. Balashek bauten Audrey aus analogen Schaltungen, die einen gut 1,80 Meter hohen Relaisschrank füllten. Ein Sprecher sagte eine Ziffer in einen Telefonhörer, die Maschine maß die Vokalformanten, und neben der erkannten Ziffer leuchtete eine Lampe auf. Auf die Stimmen ihrer Entwickler abgestimmt erreichte sie 97 bis 99 Prozent; bei Fremden brach sie ein. Audrey verließ das Labor nie, weil ein Mensch, der die Nummern wählte, billiger war, aber sie klärte die Frage, ob eine Maschine überhaupt hören kann.
IBMs Shoebox und die 1960er Jahre
1962 stellte IBM auf der Weltausstellung in Seattle Shoebox vor. Das Gerät erkannte 16 gesprochene Wörter, die zehn Ziffern und sechs Rechenbefehle, und steuerte damit eine Addiermaschine. Labore in den USA, Großbritannien, Japan und der Sowjetunion bauten Erkenner für Vokale und kleine Wortlisten, und 1968 beschrieb Taras Vintsyuk das Dynamic Time Warping, mit dem eine Maschine unterschiedlich schnell gesprochene Sprache vergleichen konnte. 1969 hatte das Fachgebiet zwar Ehrgeiz, aber keine Theorie, und John Pierce von den Bell Labs verglich es mit Plänen, Wasser in Benzin zu verwandeln.
Das DARPA-Programm Speech Understanding Research brachte den Wortschatz auf über 1.000 Wörter
Zwischen 1971 und 1976 finanzierte die DARPA das bis dahin größte Vorhaben zur Spracherkennung, und Harpy von der Carnegie Mellon University erreichte das Ziel von 1.000 Wörtern.
Das Fünfjahresziel
Das Programm Speech Understanding Research forderte ein System, das zusammenhängende Sprache mehrerer Sprecher mit einem Wortschatz von 1.000 Wörtern und weniger als 10 Prozent Fehlern verstehen sollte, und bezahlte Carnegie Mellon, BBN, SRI und andere dafür, gegeneinander anzutreten. Harpy, 1976 an der Carnegie Mellon fertiggestellt, verstand 1.011 Wörter, etwa den Wortschatz eines dreijährigen Kindes, und erreichte als einziges System das Ziel. Der Kniff war eine Suche, die unwahrscheinliche Wortfolgen früh verwarf, statt jede Möglichkeit abzuwägen. Diese Idee steckt bis heute im Kern jedes Decoders.
Die statistische Wende
Aus denselben Jahren stammt die Idee, die für die nächsten 40 Jahre alles andere schlug. An der Carnegie Mellon University beschrieb James Baker 1975 in seiner Dissertation das System DRAGON, das Sprache als Hidden-Markov-Modell behandelte und Wahrscheinlichkeiten statt handgeschriebener Regeln entscheiden ließ, welche Wörter gesagt worden waren. Bei IBM baute die Gruppe um Fred Jelinek denselben Ansatz in ein Forschungssystem fürs Diktieren ein und ergänzte n-Gramm-Sprachmodelle, sodass der Erkenner das nächste Wort aus den beiden vorherigen erraten konnte. Die Bell Labs gingen derweil von einer Stimme zu vielen über und bauten Erkenner, die über Sprecher hinweg funktionierten, wie es Telefonanwendungen verlangten.
Hidden-Markov-Modelle machten die Spracherkennung in den 1980ern statistisch
Die 1980er ersetzten den Mustervergleich durch Wahrscheinlichkeiten, und der Wortschatz wuchs innerhalb eines Jahrzehnts von wenigen hundert auf 20.000 Wörter.
Wie ein Hidden-Markov-Modell hört
Ein Hidden-Markov-Modell versucht nicht, einen Klang mit einer Vorlage abzugleichen. Es fragt, welche Folge von Sprachlauten das empfangene Audio am wahrscheinlichsten erzeugt hat, und dann, welche Wortfolge am wahrscheinlichsten diese Laute erzeugt hat. Das Training mit aufgezeichneter Sprache legt die Wahrscheinlichkeiten fest, mehr Daten bedeuten also einen besseren Erkenner, eine Eigenschaft, die mit dem Aufkommen des Internets enorm wichtig werden sollte. In Kombination mit n-Gramm-Sprachmodellen wurde das HMM zur Standardarchitektur in jedem Forschungslabor und blieb es, bis Deep Learning es 2012 verdrängte.
Tangora, Sphinx und die ersten Produkte
IBMs Tangora erkannte Mitte der 1980er einen Wortschatz von 20.000 Wörtern, brauchte aber eine Pause zwischen den Wörtern und ein Training auf jeden Sprecher. 1988 vereinte Kai-Fu Lees System Sphinx an der Carnegie Mellon University als erstes großen Wortschatz, kontinuierliche Sprache und Sprecherunabhängigkeit in einem Erkenner. Dragon Systems, 1982 von James und Janet Baker gegründet, begann Erkennungssoftware für Personal Computer zu verkaufen. Auch Verbraucher kamen erstmals mit Spracherkennung in Berührung: Die Puppe Julie von Worlds of Wonder reagierte 1987 auf eine Handvoll gesprochener Sätze, und Telefongesellschaften erprobten die Sprachwahl. Die Spielzeuge waren primitiv, aber sie brachten das Wort "Spracherkennung" in ganz normale Haushalte.
Die 1990er brachten die Spracherkennung auf den PC
Schnellere Prozessoren machten aus dem Diktieren im Labor Software aus dem Regal, und ein gemeinsamer Benchmark machte den Fortschritt leicht messbar.
Von Dragon Dictate zu NaturallySpeaking
Dragon Dictate kam 1990 für rund 9.000 Dollar auf den Markt. Es war das erste Spracherkennungsprodukt, das jeder kaufen konnte, und es verlangte nach jedem Wort eine Pause. 1997 schaffte Dragon NaturallySpeaking die Pause ab: Es erkannte kontinuierliche Sprache mit rund 100 Wörtern pro Minute auf einem Heim-PC, und IBM antwortete im selben Jahr mit ViaVoice. Zum ersten Mal konnten Anwälte, Ärzte oder Autoren mit einem Computer sprechen und brauchbaren Text bekommen, sofern sie ihn trainierten und korrigierten.
Telefonmenüs und die ersten Benchmarks
1996 startete BellSouth VAL, ein Sprachportal zum Anrufen, das gesprochene Fragen beantwortete, und jedes automatische Telefonsystem, mit dem Sie sich seither gestritten haben, stammt davon ab. Im Hintergrund führten die DARPA und das National Institute of Standards and Technology jährliche Auswertungen auf gemeinsamen Aufnahmen wie dem Telefonkorpus Switchboard durch, und die Wortfehlerrate wurde zur Kennzahl, die jedes Labor meldete. Von da an ist die Geschichte der Spracherkennung weitgehend die Geschichte dieser sinkenden Zahl.
Die 2000er verlagerten die Spracherkennung in die Cloud
Die Genauigkeit stagnierte den Großteil des Jahrzehnts bei etwa 80 Prozent, bis Google die Erkennung vom Gerät auf seine Server verlegte.
Das Plateau
2001 transkribierten die besten Systeme diktierte Sprache mit rund 80 Prozent Genauigkeit, und die folgenden Jahre brachten Feinschliff statt Sprünge. Diktieren am Desktop blieb eine Nische, die Telefonmenüs blieben frustrierend, und die Forschungsgelder wurden knapper. Das Hidden-Markov-Modell war nahe an seiner Obergrenze, und den Modellen, die es ablösen sollten, fehlten noch die Rechenleistung und die Daten.
Google Voice Search
Googles Telefonauskunft GOOG-411, 2007 gestartet, sammelte Millionen gesprochener Suchanfragen. Im November 2008 erschien Google Voice Search als iPhone-App, und die Spracherkennung änderte ihre Form: Das Telefon nahm nur noch auf, die Erkennung lief in Googles Rechenzentren auf Modellen, die weit größer waren, als je auf ein Gerät gepasst hätten, trainiert mit 230 Milliarden Wörtern aus Suchanfragen. Aus einem Programm wurde ein Dienst, und diese Form hat die Spracherkennung bis heute.