Otomatik konuşma tanıma:
nasıl çalışır, 1952'den bu yana konuşma tanımanın tarihi

ASR, konuşulan kelimeleri yazılı metne dönüştürür. Bu rehberde ASR'nin ne olduğunu, modern motorların nasıl çalıştığını, doğruluğun nasıl ölçüldüğünü ve Bell Labs'in 1952'de yalnızca on rakamı tanıyan Audrey'sinden bugünün 54+ diline uzanan konuşma tanıma tarihini bulacaksınız.

ASR nedir?

Otomatik konuşma tanıma (ASR), konuşulan dili yazılı metne dönüştüren teknolojidir. Bir ASR sistemi ses sinyalini alır, içindeki sesleri analiz eder ve en olası kelime dizisini tahmin eder. Deşifre yazılımlarının, sesli asistanların, canlı altyazıların, dikte araçlarının ve sesli aramanın arkasında bu teknoloji vardır.

ASR, İngilizce automatic speech recognition (otomatik konuşma tanıma) ifadesinin kısaltmasıdır; bazı sağlayıcılar bunu automated speech recognition olarak açar, ikisi de aynı anlama gelir. Kısa bir özet için ASR'ye genel bakış yazımızı okuyabilirsiniz. Bu rehber ise motorun kendisinden arkasındaki 70 yıllık araştırmaya kadar daha derine iniyor.

Bu terim sık sık üç komşusuyla karıştırılır ve her biri farklı bir soruyu yanıtlar:

  • ASR (otomatik konuşma tanıma) konuşma sesini metne dönüştürür ve "ne söylendi?" sorusunu yanıtlar.
  • Konuşmadan metne (speech-to-text) aynı teknolojinin ürün adıdır; o da "ne söylendi?" sorusunu yanıtlar.
  • Ses tanıma (konuşmacı tanıma) konuşan kişiyi tanımlar veya doğrular ve "bunu kim söyledi?" sorusunu yanıtlar.
  • NLP (doğal dil işleme) metnin anlamını yorumlar ve "bu ne anlama geliyor?" sorusunu yanıtlar.

Pratikte ASR ile konuşmadan metne aynı şeydir: ASR mühendislik terimi, konuşmadan metne ise ürün terimidir. En sık karıştırılan ses tanımadır. Ses tanıma konuşmacıyı tanır, tıpkı yalnızca sahibinin sesiyle açılan bir telefon gibi; ASR ise kimin konuştuğuyla ilgilenmeden herkesin sözlerini yazıya döker. NLP bir sonraki adımdır: önce ses metne dönüşür, ardından NLP bu metni özetler, onunla ilgili bir soruyu yanıtlar ya da ona göre harekete geçer.

ASR nasıl çalışır?

Modern ASR, sesi doğrudan metne dönüştüren tek bir sinir ağıdır; ancak tarihinin büyük bölümünde beş ayrı modelden oluşan bir işlem hattıydı.

Aşağıdaki tarihçenin parça parça kurduğu klasik işlem hattı şöyle çalışır:

  1. Kayıt ve ön işleme. Ses dijitalleştirilir, temizlenir ve genellikle birkaç on milisaniyelik kısa çerçevelere bölünür.
  2. Öznitelik çıkarımı. Her çerçeve, farklı frekanslardaki enerjisini özetleyen kompakt bir sayısal tanıma dönüşür.
  3. Akustik model. Bu model öznitelikleri bir dilin temel ses birimleri olan fonemlerle eşleştirir ve büyük olasılıkla hangi seslerin çıkarıldığını belirler.
  4. Dil modeli. Bu model hangi kelime dizilerinin olası olduğunu bilir; bir motorun "bende geldim" yerine "ben de geldim" yazmasının nedeni budur: ikisi de sese uyar, ama yalnızca biri dile uyar.
  5. Kod çözücü. Kod çözücü, akustik model ile dil modelinin birleşik olasılıklarını tarar ve en olası cümleyi çıktı olarak verir.

Uçtan uca dönüşüm

2010'ların ortasından bu yana, çoğu artık Transformer mimarisi üzerine kurulu uçtan uca derin öğrenme modelleri, ham sesten metne giden eşlemeyi doğrudan öğreniyor ve yüz binlerce saatlik konuşmayla eğitiliyor. Elle hazırlanmış bir telaffuz sözlüğü de ayrı bir akustik model de yok; ağ hepsini aynı anda öğreniyor. Deşifre doğruluğunun 2010'larda kendisinden önceki kırk yılda olduğundan daha fazla artmasının başlıca nedeni bu dönüşümdür.

Bu modeller sesten devasa ölçekte öğrendiği için aksanlarla, arka plan gürültüsüyle ve doğal sohbetle işlem hattı sistemlerinden çok daha iyi başa çıkıyor. Noktalama ve büyük harfleri de aynı geçişte tahmin ettikleri için modern bir deşifre, düzgün bir belge gibi okunuyor.

ASR doğruluğu nasıl ölçülür?

Standart ölçüt kelime hata oranıdır (WER): makinenin çıkardığı deşifre, özenle hazırlanmış bir insan deşifresiyle karşılaştırılır ve yerine başka kelime konan, atlanan ya da fazladan eklenen her kelime bir hata sayılır. %5 WER, kabaca her 20 kelimede bir hata, yani %95 doğruluk demektir. WER tamamen test sesine bağlıdır; iki sağlayıcının doğruluk iddialarının nadiren karşılaştırılabilmesinin nedeni de budur. Rehberimiz formülü açıklıyor ve bir hesaplayıcı da içeriyor.

Bir bakışta konuşma tanıma

İcadı
Konuşma tanıma 1952'de, Bell Labs'in Audrey sistemi tek bir sesin söylediği 0'dan 9'a kadar rakamları tanıdığında icat edildi.
İlk tüketici yazılımı
1990'da yaklaşık 9.000 dolara piyasaya çıkan Dragon Dictate, halka satılan ilk konuşma tanıma ürünüydü ve her kelimeden sonra duraklama gerektiriyordu.
İlk 1.000 kelimelik dağarcık
Carnegie Mellon'un Harpy sistemi 1976'da 1.011 kelime anlıyordu ve DARPA'nın beş yıllık Konuşma Anlama Araştırması programı için koyduğu hedefi tutturmuştu.
İnsan düzeyi
Microsoft 2017'de Switchboard telefon kıyaslamasında %5,1 kelime hata oranı ölçtü; bu, aynı görüşmeleri yazıya döken profesyonel deşifre uzmanlarıyla aynı düzeydi.
Açık modeller
OpenAI'ın Eylül 2022'de yayımladığı Whisper 680.000 saatlik ses kaydıyla eğitildi; ağırlıkları herkese açık ve 100'e yakın dili deşifre edebiliyor.
Bugün
2017 yılında kurulan Sonix, 54+ dilde 99% doğrulukla deşifre yapar ve bir saatlik bir kaydı yaklaşık 5 ila 6 dakikada teslim eder.

Konuşma tanımanın tarihi 1952'de Bell Labs'te başlar

İlk konuşma tanıyıcı 1952'de Bell Labs'te yapıldı ve tam olarak on kelime anlıyordu: sıfırdan dokuza kadar rakamlar.

Audrey, Otomatik Rakam Tanıyıcı

K. H. Davis, R. Biddulph ve S. Balashek, Audrey'yi yaklaşık iki metrelik bir röle rafını dolduran analog devrelerden yaptı. Konuşmacı telefon ahizesine bir rakam söylüyor, makine ünlü formantlarını ölçüyor ve duyduğu rakamın yanındaki lamba yanıyordu. Tasarımcılarının sesine ayarlandığında yüzde 97 ile 99 arasında başarı gösteriyor, yabancı seslerde ise sınıfta kalıyordu. Numaraları çeviren bir insan operatör daha ucuza geldiği için Audrey laboratuvardan hiç çıkmadı; ama bir makinenin duyup duyamayacağı sorusunu kesin olarak yanıtladı.

IBM'in Shoebox'ı ve 1960'lar

IBM, 1962'de Seattle Dünya Fuarı'nda Shoebox'ı tanıttı. Shoebox on rakam ve altı aritmetik komuttan oluşan 16 kelimeyi tanıyor ve bunlarla bir toplama makinesini çalıştırıyordu. ABD, İngiltere, Japonya ve Sovyetler Birliği'ndeki laboratuvarlar ünlüler ve küçük kelime listeleri için tanıyıcılar geliştirdi; 1968'de Taras Vintsyuk, farklı hızlarda söylenen konuşmaları karşılaştırmayı mümkün kılan dinamik zaman bükmeyi (dynamic time warping) tanımladı. 1969'a gelindiğinde alanın hırsı vardı ama kuramı yoktu; Bell Labs'ten John Pierce bu çabaları suyu benzine çevirme planlarına benzetiyordu.

DARPA'nın Konuşma Anlama Araştırması programıyla kelime dağarcıkları 1.000 kelimeyi aştı

DARPA 1971 ile 1976 arasında o güne kadarki en büyük konuşma tanıma çalışmasını finanse etti ve Carnegie Mellon'un Harpy sistemi 1.000 kelimelik hedefe ulaştı.

Beş yıllık hedef

Konuşma Anlama Araştırması programı, birden fazla konuşmacının bağlantılı konuşmasını 1.000 kelimelik bir dağarcıkla ve yüzde 10'un altında hatayla anlayabilen bir sistem istedi; Carnegie Mellon, BBN, SRI ve diğerlerini bunun için yarıştırdı. 1976'da Carnegie Mellon'da tamamlanan Harpy, kabaca üç yaşındaki bir çocuğun kelime dağarcığına denk gelen 1.011 kelimeyi anlıyordu ve hedefe ulaşan tek sistem oldu. Sırrı, her olasılığı tek tek tartmak yerine olası olmayan kelime dizilerini erkenden eleyen bir aramaydı; bu fikir bugün hâlâ her kod çözücünün kalbinde yer alıyor.

İstatistiksel dönemeç

Aynı yıllar, sonraki 40 yıl boyunca diğer her şeyi geride bırakacak fikri de doğurdu. Carnegie Mellon'da James Baker'ın 1975 tarihli tezi, konuşmayı bir saklı Markov modeli olarak ele alan ve hangi kelimelerin söylendiğine elle yazılmış kurallar yerine olasılıkların karar vermesini sağlayan DRAGON sistemini tanımlıyordu. IBM'de Fred Jelinek'in ekibi aynı yaklaşımı bir araştırma amaçlı dikte sistemine yerleştirdi ve n-gram dil modelleri ekledi; böylece tanıyıcı, son iki kelimeye bakarak bir sonrakini tahmin edebiliyordu. Bu arada Bell Labs tek sesten çok sese geçti ve telefon uygulamalarının gerektirdiği, konuşmacıdan bağımsız çalışan tanıyıcılar geliştirdi.

Saklı Markov modelleri 1980'lerde konuşma tanımayı istatistiksel hale getirdi

1980'ler örüntü eşlemenin yerine olasılığı koydu ve kelime dağarcıkları on yılda birkaç yüz kelimeden 20.000'e çıktı.

Saklı Markov modeli nasıl duyar

Saklı Markov modeli bir sesi bir şablonla eşleştirmeye çalışmaz. Önce aldığı ses kaydını en büyük olasılıkla hangi konuşma sesi dizisinin ürettiğini, sonra o sesleri en büyük olasılıkla hangi kelime dizisinin ürettiğini sorar. Olasılıklar kayıtlı konuşmayla yapılan eğitimle belirlenir; yani daha çok veri daha iyi tanıyıcı demektir ve internet geldiğinde bu özellik muazzam önem kazanacaktı. HMM, n-gram dil modelleriyle birleşince her araştırma laboratuvarında standart mimari haline geldi ve 2012'de derin öğrenme onu tahtından edene kadar orada kaldı.

Tangora, Sphinx ve ilk ürünler

IBM'in Tangora sistemi 1980'lerin ortasında 20.000 kelimelik bir dağarcığı tanıyordu; gerçi kelimeler arasında duraklama ve her konuşmacı için ayrı eğitim gerektiriyordu. 1988'de Kai-Fu Lee'nin Carnegie Mellon'daki Sphinx sistemi, geniş dağarcığı, sürekli konuşmayı ve konuşmacıdan bağımsızlığı tek bir tanıyıcıda birleştiren ilk sistem oldu. James ve Janet Baker'ın 1982'de kurduğu Dragon Systems, kişisel bilgisayarlar için tanıma yazılımı satmaya başladı. Ses tanıma da ilk kez tüketiciye ulaştı: Worlds of Wonder'ın Julie bebeği 1987'de birkaç sözlü ifadeye yanıt veriyordu, telefon şirketleri ise sesle aramayı denemeye başlamıştı. Oyuncaklar kabaydı ama "ses tanıma" ifadesini sıradan evlere soktu.

1990'lar konuşma tanımayı kişisel bilgisayarlara taşıdı

Daha hızlı işlemciler dikteyi laboratuvar gösterisinden raflarda satılan yazılıma dönüştürdü; ortak bir kıyaslama seti de ilerlemeyi ölçmeyi kolaylaştırdı.

Dragon Dictate'ten NaturallySpeaking'e

Dragon Dictate 1990'da yaklaşık 9.000 dolara piyasaya çıktı. Sıradan bir kullanıcının satın alabildiği ilk konuşma tanıma ürünüydü ve her kelimeden sonra duraklama istiyordu. 1997'de Dragon NaturallySpeaking bu duraklamayı ortadan kaldırdı: ev bilgisayarında sürekli konuşmayı dakikada yaklaşık 100 kelime hızında tanıyordu; IBM de aynı yıl ViaVoice ile karşılık verdi. Bir avukat, bir doktor ya da bir yazar ilk kez bilgisayarla konuşup, onu eğitmek ve düzeltmek koşuluyla, işe yarar bir metin elde edebiliyordu.

Telefon menüleri ve ilk kıyaslamalar

BellSouth 1996'da sözlü soruları yanıtlayan, telefonla aranan bir ses portalı olan VAL'ı hizmete aldı; o günden beri tartıştığınız her otomatik telefon sistemi onun soyundan geliyor. Perde arkasında DARPA ile Ulusal Standartlar ve Teknoloji Enstitüsü, Switchboard telefon derlemi gibi ortak kayıtlar üzerinde yıllık değerlendirmeler yapıyordu ve kelime hata oranı her laboratuvarın raporladığı sayı haline geldi. O andan itibaren konuşma tanımanın tarihi, büyük ölçüde bu sayının düşüşünün tarihidir.

2000'ler konuşma tanımayı buluta taşıdı

Doğruluk on yılın büyük bölümünde yüzde 80 civarında takılı kaldı; ta ki Google tanımayı cihazdan alıp kendi sunucularına taşıyana kadar.

Durgunluk

2001'e gelindiğinde en iyi sistemler dikte edilen konuşmayı kabaca yüzde 80 doğrulukla yazıya döküyordu; sonraki yıllar sıçrama değil, ince ayar getirdi. Masaüstü dikte niş bir alan olarak kaldı, telefon menüleri sinir bozucu olmaya devam etti, araştırma fonları da azaldı. Saklı Markov modeli tavanına yaklaşmıştı; yerini alacak modellerin ise ihtiyaç duydukları işlem gücü ve veri henüz ortada yoktu.

Google Voice Search

Google'ın 2007'de başlattığı GOOG-411 rehber hizmeti milyonlarca sesli sorgu topladı. Kasım 2008'de Google Voice Search bir iPhone uygulaması olarak geldi ve tanımanın yapısı değişti: telefon yalnızca kayıt yapıyor, tanıma ise Google'ın veri merkezlerinde, hiçbir cihaza sığmayacak kadar büyük ve 230 milyar kelimelik arama sorgusuyla eğitilmiş modellerle çalışıyordu. Tanıma bir program olmaktan çıkıp bir hizmete dönüştü ve bugün de bu biçimde sürüyor.

Kronoloji

Konuşma tanımanın tarihi, yıl yıl

Aşağıdaki her olay tarihlendirilmiştir. Tablonun çevresindeki bölümler her birinin neden önemli olduğunu açıklıyor.

YılGelişmeNeden önemliydi
1952Bell Labs Audrey'yi yaptıKonuşmayı tanıyan ilk makine: tek konuşmacıdan 0'dan 9'a kadar rakamlar
1962IBM Shoebox'ı sergiledi16 kelime, Seattle Dünya Fuarı'nda halka gösterildi
1971DARPA Konuşma Anlama Araştırması programını başlattıBeş yıllık fon ve 1.000 kelimelik hedef
1976Carnegie Mellon'un Harpy'si hedefi tutturdu1.011 kelime ve kod çözücülerin hâlâ kullandığı budanmış arama
1986IBM'in Tangora'sı 20.000 kelimeye ulaştıSaklı Markov modelleri ve n-gram dil modelleri standart oldu
1988Carnegie Mellon'da SphinxSürekli, konuşmacıdan bağımsız, geniş dağarcıklı tanıma tek sistemde
1990Dragon Dictate satışa çıktıTüketiciye satılan ilk konuşma tanıma ürünü
1997Dragon NaturallySpeaking ve IBM ViaVoiceEv bilgisayarında dakikada yaklaşık 100 kelimeyle sürekli dikte
2008Google Voice SearchTanıma buluta taşındı ve her sorgudan öğrenmeye başladı
2011Apple Siri'yi sunduYaygın bir telefonda sesli asistan
2012Derin sinir ağları Gauss karışım modellerinin yerini aldıHata oranları tek adımda üçte bire varan ölçüde düştü
2016Microsoft Switchboard'da %5,9 bildirdiKonuşma kıyaslamasında ilk insan düzeyi iddiası
2017Microsoft %5,1, IBM %5,5, Google %4,9; Transformer yayımlandıİnsan düzeyi yarışı sona erdi, sıradaki mimari geldi
2020wav2vec 2.0 ve ConformerÖz denetimli öğrenme etiketli veri ihtiyacını azalttı
2022OpenAI Whisper'ı yayımladı680.000 saat eğitim verisi, 100'e yakın dil, açık ağırlıklar

Derin öğrenme 2010'larda hata oranlarını yarıdan fazla düşürdü

2011 ile 2017 arasında telefon konuşmalarındaki kelime hata oranı yüzde 10 küsurdan yüzde 5 civarına indi; sesli asistanlar da evlere girdi.

Siri ve asistanlar

Apple, Siri'yi Ekim 2011'de iPhone 4S ile piyasaya sürdü; Amazon 2014'te Echo üzerindeki Alexa ile, Google da 2016'da Google Home ile onu izledi. Bu asistanları önemli kılan, tıpkı Google Voice Search gibi bulutta çalışan tanıma teknolojileri değil, yarattıkları alışkanlıktı: yüz milyonlarca insan her gün makinelerle konuşmaya başladı ve her söz eğitim verisine dönüştü.

Sinir ağı adımı

2012'de aralarında Geoffrey Hinton'ın da bulunduğu Microsoft, Google, IBM ve Toronto Üniversitesi araştırmacıları ortak bir makale yayımladı: problemin akustik tarafında eğitilen derin sinir ağları, HMM sistemlerinin 25 yıldır kullandığı Gauss karışım modellerine kıyasla hata oranlarında üçte bire varan bir düşüş sağlıyordu. Baidu'nun Deep Speech sistemi 2014'te bir adım öteye geçti ve tek bir yinelemeli ağı sesten karakterlere uçtan uca, telaffuz sözlüğü ve elle kurulmuş işlem hattı olmadan eğitti. Tanıma bir derin öğrenme problemine dönüştü; en çok GPU'ya ve veriye sahip laboratuvarlar öne geçti.

İnsan düzeyine ulaşma yarışı

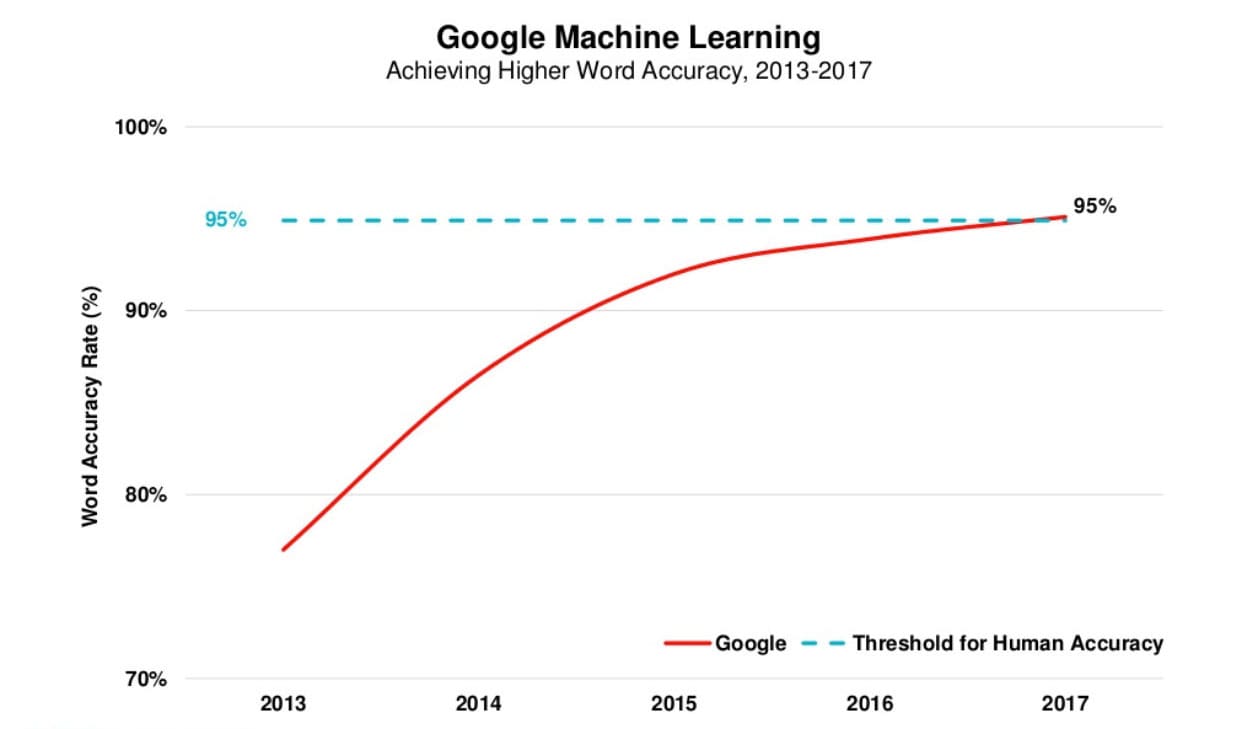
Kaydedilmiş telefon görüşmelerinden oluşan Switchboard kıyaslama seti, adeta bir skor tablosuna dönüştü. Ekim 2016'da Microsoft, aynı görüşmeleri deşifre etmeleri için tuttuğu profesyonel deşifre uzmanlarıyla aynı düzeyde, yüzde 5,9'luk bir kelime hata oranı açıkladı ve buna insan eşitliği adını verdi. IBM Mart 2017'de yüzde 5,5 ile karşılık verdi, Google o yılın mayıs ayında kendi test setlerinde yüzde 4,9 açıkladı ve Ağustos 2017'de Microsoft, daha titiz bir insan referansına karşı yüzde 5,1'e ulaştı. Mary Meeker'ın 2017 Internet Trends raporundan alınan aşağıdaki grafik, Google'ın kelime doğruluğunun yüzde 95 sınırını aştığını gösteriyor. Aynı yıl Transformer mimarisi yayımlandı ve üç yıl içinde konuşma alanını da ele geçirdi.

Mary Meeker'ın 2017 İnternet Trendleri raporundan, Google'ın kelime doğruluk oranının yüzde 95'i aştığını gösteren grafik

Whisper ve Transformer deşifreyi herkesin ulaşabildiği bir hizmete dönüştürdü

Öz denetimli eğitim ve tek bir açık model, doğru çok dilli deşifreyi büyük teknoloji şirketlerine özgü bir yetenek olmaktan çıkarıp her ürünün sunabileceği bir şeye dönüştürdü.

Etiketsiz sesten öğrenmek

2010'ların darboğazı etiketli veriydi: her eğitim saati için bir insan deşifresi gerekiyordu. 2020'de Facebook AI'ın wav2vec 2.0 modeli konuşma temsillerini önce ham, deşifre edilmemiş sesten öğrendi ve işe yarar bir tanıyıcıya ince ayar yapmak için yalnızca on dakikalık etiketli konuşma yetiyordu. Google'ın aynı yıl yayımladığı Conformer modeli evrişimi Transformer dikkat mekanizmasıyla birleştirdi ve standart kıyaslamalarda yeni rekorlar kırdı. İkisi birlikte Transformer'ı konuşma için varsayılan mimari haline getirdi ve yeni bir dil eklemenin maliyetini düşürdü.

Whisper

OpenAI, Eylül 2022'de Whisper'ı yayımladı: web'den toplanan 680.000 saatlik sesle eğitilmiş, 100'e yakın dili kapsayan ve model ağırlıkları herkesin çalıştırabilmesi için açıkça yayımlanmış bir sistemdi. Her kıyaslamada en doğru sistem değildi ama aksanlara, arka plan gürültüsüne ve teknik terimlere karşı önceki akademik modellerde görülmeyen bir dayanıklılığa sahipti ve üstelik ücretsizdi. Aylar içinde binlerce ürünün içine girdi; deşifre şirketleri için soru, konuşmayı tanıyıp tanıyamadıklarından deşifre metninin etrafında ne inşa ettiklerine kaydı.

Otomatik dil tanımlamanın kendi tarihi var

Hangi dilin konuşulduğunu bilmek, hangi kelimelerin söylendiğini bilmekten ayrı bir problemdir ve çözümü de kendi başına 50 yıl aldı.

Fonem istatistiklerinden i-vektörlere

1970'lerdeki ilk dil tanımlama deneyleri dilleri seslerinin istatistiklerine bakarak ayırt ediyordu. 1990'larda bu, fonotaktik yaklaşıma dönüştü: önce bir fonem tanıyıcı çalıştırılıyor, ardından hangi dilin fonem örüntülerinin en iyi uyduğuna bakılıyordu. NIST de 1996'da resmi Dil Tanıma Değerlendirmelerini başlattı. 2010'larda konuşmacı tanımadan ödünç alınan ve bir kaydı kompakt biçimde özetleyen i-vektör, birkaç saniyelik sesten dili söyleyebilen sistemlerin önünü açtı.

Modelin içine gömülü

Modern çok dilli tanıyıcılar iki problemi tek potada eritiyor. Whisper ve ardılları dili deşifrenin ilk belirteci (token) olarak tahmin ediyor; böylece dil tanımlama ayrı bir adım değil, tanımanın bir yan ürünü oluyor. Tek bir ürünün her dil için ayrı bir tanıyıcı olmadan 54+ dili işleyebilmesi bu sayede mümkün; konuştuğunuz dilin, neyi deşifre edebileceğinizin sınırı olmaktan çıkmasının nedeni de bu.

ASR bugün nerede duruyor?

Temiz ve iyi kaydedilmiş seste modern ASR neredeyse çözülmüş durumda; bu yüzden motorlar artık zor seslerde ve deşifre çıktıktan sonra yaptıklarıyla ayrışıyor.

Ciddi motorlar arasındaki kıyaslama puanları birbirine yaklaştı; dolayısıyla bir sağlayıcıya sorulacak soru artık "doğruluğunuz ne kadar?" değil, sizin seslerinizle nasıl başa çıktığı ve deşifreyle ne yaptığı. Sonix, 2026 yılında üretimdeki ASR'nin somut bir örneği:

Dürüstçe ölçülen doğruluk

Sonix, temiz ve yüksek kaliteli seste 99% doğruluğa ulaşır ve otomatik deşifre ile bir saatlik bir kaydı yaklaşık 5 ila 6 dakikada teslim eder. Bizimkiler de dahil her doğruluk rakamı sese bağlıdır; bu yüzden önemli olan tek kıyaslama, kendi kayıtlarınız üzerinde yapacağınız bir testtir.

Diller

Sonix, 54+ dilde deşifre ve çeviri yapar. Whisper dönemi modelleri geniş dil desteğini istisna olmaktan çıkarıp standart hale getirdi; her dildeki doğruluk ise o dil için ne kadar eğitim sesi bulunduğuna bağlıdır.

Gerçek zamanlı

Gerçek zamanlı deşifre, insanlar daha konuşurken altyazıları 2 saniyeden kısa sürede yayınlar; bu, uçtan uca mimarinin doğrudan bir kazanımıdır.

Kim ne dedi?

Motorlar artık konuşmacıları otomatik olarak ayırıyor; bu işin adı konuşmacı ayrıştırma (diarization). Konuşmacı ayrıştırma rehberimiz bunun nasıl çalıştığını ve hâlâ nerede zorlandığını anlatıyor.

Deşifrenin ötesinde

Özetler, bölümler ve çeviri, ham metni üzerinde işlem yapabileceğiniz bir şeye dönüştürür. ASR artık nihai ürün değil, bir anlama sürecinin ilk aşaması; Sonix'te ilk 30 dakikanız ücretsiz, böylece bunu kendi sesleriniz üzerinde görebilirsiniz.

ASR nereye gidiyor: zor sesler, gizlilik ve anlama

Kıyaslama yarışı bitti; geriye kalan sorunlar gösterişsiz olanlar: zor sesler, kurum içi kurulum ve kelimeleri anlama dönüştürmek.

Zor durumlar

Üst üste konuşan kişiler, uzaktaki mikrofonlar, belirgin aksanlar, cümle ortasında dil değiştirme ve uzmanlık terimleri, bizimki de dahil her motorun performansını hâlâ düşürüyor. Uçtan uca modeller yeni bir hata türü de getirdi: sessizlik veya gürültü sırasında zaman zaman akıcı ama uydurma metin üretebiliyorlar (halüsinasyon). Bu, çözülmüş değil, üzerinde aktif olarak çalışılan bir araştırma sorunu.

Cihazın üzerinde

Gizlilik ve hız için tanımanın giderek daha fazla bulut yerine telefonlarda, dizüstü bilgisayarlarda ve kulaklıklarda çalışmasını bekleyebilirsiniz. Whisper sınıfı modelleri küçülten sıkıştırma çalışmaları, doğru tanımayı sesi hiçbir yere göndermeyen donanımlara da taşıyor.

Deşifreden anlamaya

Büyük dil modelleri artık toplantıları özetliyor, bir röportajla ilgili soruları yanıtlıyor ve bir dersin ardından takip notunu hazırlıyor; bunu iyi yapabilmelerinin tek nedeni, altlarındaki deşifrenin doğru olması. Ses bir arayüz olarak büyümeye devam ediyor. Sesin bütün ekranların yerini alacağı iddiası 1990'lardan beri dile getiriliyor; biz, insanların gerçekte söylediklerini güvenilir biçimde yakalamasıyla yetiniriz.

Sık sorulan sorular

ASR ve konuşma tanıma,
sorular ve yanıtlar

ASR neyin kısaltmasıdır?

ASR, konuşulan dili yazılı metne dönüştüren teknoloji olan automatic speech recognition, yani otomatik konuşma tanıma ifadesinin kısaltmasıdır. Automated speech recognition olarak açıldığını da görebilirsiniz; ikisi de aynı anlama gelir. Deşifre alanında ASR, konuşma tanıma ve konuşmadan metne terimleri birbirinin yerine kullanılır.

ASR, konuşmadan metne veya ses tanımayla aynı şey mi?

ASR ile konuşmadan metne aynı şeydir: ASR teknik terimdir, konuşmadan metne ise ortaya çıkan sonucu tarif eder. Ses tanıma ise farklıdır. Bir sesin özelliklerinden kimin konuştuğunu belirler; telefonun yalnızca sahibine açılması bu şekilde olur. ASR ise kim söylerse söylesin söylenenleri yazıya döker.

ASR'nin NLP'den farkı nedir?

ASR konuşma sesini metne dönüştürür; NLP (doğal dil işleme) ise metnin ne anlama geldiğini yorumlar. İkisi art arda çalışır: bir sesli asistana soru sorduğunuzda ASR sözlerinizi yazıya döker, ardından NLP niyetinizi ve yanıtı çıkarır. Sonix'te deşifreyi ASR üretir, NLP tabanlı özellikler de onu özetler ve analiz eder.

ASR ne kadar doğrudur?

Net sohbet kayıtlarında en iyi sistemler profesyonel deşifre uzmanlarıyla aynı düzeydedir: Microsoft 2017'de Switchboard kıyaslama setinde %5,1 kelime hata oranı ölçtü ve modeller o günden bu yana daha da gelişti. Sonix, iyi kalitedeki seste 99% doğruluğa ulaşır. Arka plan gürültüsü, uzak mikrofonlar, belirgin aksanlar ve üst üste konuşmalar hata oranını hâlâ artırır; bu yüzden kendi kayıtlarınızla test etmenizi öneririz.

Konuşma tanıma ne zaman ve nerede icat edildi?

1952'de. K. H. Davis, R. Biddulph ve S. Balashek'in Bell Labs'te geliştirdiği Audrey sistemi, tek bir konuşmacının söylediği 0'dan 9'a kadar rakamları tanıyordu. 1962'de 16 kelimelik IBM Shoebox onu izledi; satın alınabilen ilk ürün olan Dragon Dictate ise 1990'da geldi.

Konuşma tanımayı kim icat etti?

Tek bir kişi değil. İlk tanıyıcı Audrey'yi 1952'de üç Bell Labs mühendisi yaptı. James Baker ve Fred Jelinek 1970'lerde saklı Markov modelleriyle tanımayı istatistiksel hale getirdi, Kai-Fu Lee'nin Sphinx'i 1988'de onu sürekli ve konuşmacıdan bağımsız kıldı, Geoffrey Hinton'ın çalışma arkadaşları da 2012'de derin öğrenmeyi bu alana taşıdı.

İlk konuşma tanıma yazılımı hangisiydi?

Dragon Systems'in 1990'da yaklaşık $9,000 fiyatla piyasaya sürdüğü Dragon Dictate, halka satılan ilk konuşma tanıma yazılımıydı ve kelimeler arasında duraklama gerektiriyordu. 1997'de çıkan Dragon NaturallySpeaking ise ev bilgisayarlarında yaygın olarak benimsenen ilk sürekli konuşma dikte yazılımı oldu.

ASR İngilizce dışındaki dilleri deşifre edebilir mi?

Evet. Çok dilli eğitim verileri geniş dil desteğini standart hale getirdi ve modern sistemler onlarca dili işleyebiliyor. Sonix; İspanyolca, Fransızca, Almanca, Mandarin Çincesi, Japonca ve Arapça dahil 54+ dilde deşifre ve çeviri yapar. Doğruluk dile göre değişir ve her dil için ne kadar eğitim sesi bulunduğuna bağlıdır.

Başlayın

Sonix'i ücretsiz deneyin

Sonix, medya dosyalarınızı arayabilmeniz, düzenleyebilmeniz ve paylaşabilmeniz için ses ve video dosyalarınızı deşifre eder, zaman damgalarını ekler ve organize eder.

30 minutes dakikalık ücretsiz deşifre içerir

Okumaya devam et

%99 doğruluk. Her kelime önemlidir.

54+ dilde yapay zeka transkripsiyonu ve çevirisi.

30 minutes ücretsiz
Kredi kartı gerekmez
İstediğiniz zaman iptal edin