Reconhecimento automático de fala (ASR):
como funciona e a história do reconhecimento de fala desde 1952

O ASR transforma palavras faladas em texto escrito. Este guia explica o que ele é, como os motores modernos funcionam, como a precisão é medida e a história do reconhecimento de fala, do Audrey da Bell Labs, que reconhecia dez dígitos em 1952, aos 54+ idiomas de hoje.

O que é ASR?

O reconhecimento automático de fala (ASR, na sigla em inglês) é a tecnologia que converte a linguagem falada em texto escrito. Um sistema de ASR recebe um sinal de áudio, analisa os sons que ele contém e prevê a sequência de palavras mais provável. É ele que está por trás dos softwares de transcrição, dos assistentes de voz, das legendas ao vivo, das ferramentas de ditado e da busca por voz.

ASR é a sigla de automatic speech recognition, e alguns fornecedores a expandem como automated speech recognition; as duas formas significam a mesma coisa. Se você quer a versão de dois minutos, leia nossa visão geral do ASR. Este guia vai mais fundo, do motor aos 70 anos de pesquisa por trás dele.

O termo costuma ser confundido com três vizinhos, e cada um responde a uma pergunta diferente:

  • ASR (reconhecimento automático de fala) converte o áudio da fala em texto e responde à pergunta "o que foi dito?"
  • Conversão de fala em texto é a mesma tecnologia com seu nome de produto; também responde "o que foi dito?"
  • Reconhecimento de voz (reconhecimento de locutor) identifica ou confirma quem está falando e responde "quem disse isso?"
  • PLN (processamento de linguagem natural) interpreta o significado do texto e responde "o que isso quer dizer?"

Na prática, ASR e conversão de fala em texto são sinônimos: ASR é o termo de engenharia, e fala em texto é o nome comercial. O reconhecimento de voz é a confusão mais comum. Ele reconhece um locutor, como o celular que só desbloqueia para o dono, enquanto o ASR transcreve as palavras de qualquer pessoa sem se importar com quem as disse. O PLN vem depois: primeiro o áudio vira texto, e então o PLN o resume, responde a uma pergunta sobre ele ou age a partir dele.

Como o ASR funciona?

O ASR moderno é uma única rede neural que leva o áudio direto ao texto, mas durante quase toda a sua história ele foi uma cadeia de cinco modelos separados.

A cadeia clássica, que a história abaixo monta peça por peça, funciona assim:

  1. Captura e pré-processamento. O áudio é digitalizado, limpo e dividido em quadros curtos, normalmente de algumas dezenas de milissegundos.
  2. Extração de características. Cada quadro vira uma descrição numérica compacta da sua energia em diferentes frequências.
  3. Modelo acústico. Esse modelo relaciona essas características aos fonemas, as unidades sonoras básicas de um idioma, e estima quais sons provavelmente foram produzidos.
  4. Modelo de linguagem. Esse modelo sabe quais sequências de palavras são prováveis. É por isso que um motor escreve "conserto do carro" e não "concerto do carro": as duas cabem no áudio, mas só uma faz sentido na língua.
  5. Decodificador. O decodificador percorre as probabilidades combinadas dos modelos acústico e de linguagem e entrega a frase mais provável.

A virada para o ponta a ponta

Desde meados da década de 2010, modelos de aprendizado profundo ponta a ponta, hoje quase todos baseados na arquitetura Transformer, aprendem diretamente a passar do áudio bruto ao texto, treinados com centenas de milhares de horas de fala. Não há dicionário de pronúncia montado à mão nem modelo acústico separado; a rede aprende tudo de uma vez. Essa mudança é o principal motivo de a precisão da transcrição ter melhorado mais nos anos 2010 do que nas quatro décadas anteriores.

Como aprendem com áudio em escala enorme, esses modelos lidam com sotaques, ruído de fundo e conversa natural muito melhor do que os sistemas em cadeia, e preveem pontuação e letras maiúsculas na mesma passada. Por isso, uma transcrição moderna já se lê como um documento.

Como a precisão do ASR é medida

A métrica padrão é a taxa de erro de palavras (WER): a transcrição da máquina é comparada a uma transcrição humana cuidadosa, e cada palavra trocada, omitida ou inserida conta como erro. Uma WER de 5% significa cerca de um erro a cada 20 palavras, ou 95% de precisão. A WER depende inteiramente do áudio de teste, e é por isso que os números de precisão de dois fornecedores raramente são comparáveis; nosso guia explica a fórmula e traz uma calculadora.

Reconhecimento de fala em resumo

Invenção
O reconhecimento de fala foi inventado em 1952, quando o sistema Audrey, da Bell Labs, reconheceu os dígitos de 0 a 9 ditos por uma única voz.
Primeiro software comercial
O Dragon Dictate, lançado em 1990 por cerca de US$ 9.000, foi o primeiro produto de reconhecimento de fala vendido ao público, e exigia uma pausa depois de cada palavra.
Primeiras 1.000 palavras
Em 1976, o Harpy, da Carnegie Mellon, entendia 1.011 palavras, a meta que a DARPA havia fixado para os cinco anos do seu programa Speech Understanding Research.
Paridade humana
Em 2017, a Microsoft mediu uma taxa de erro de palavras de 5,1% no benchmark telefônico Switchboard, igualando os transcritores profissionais que trabalharam nas mesmas ligações.
Modelos abertos
O Whisper, da OpenAI, lançado em setembro de 2022, foi treinado com 680.000 horas de áudio e transcreve quase 100 idiomas, com os pesos publicados.
Hoje
O Sonix, fundado em 2017, transcreve 54+ idiomas com 99% de precisão e devolve uma gravação de uma hora em cerca de 5 a 6 minutos.

A história do reconhecimento de fala começa na Bell Labs, em 1952

O primeiro reconhecedor de fala foi construído na Bell Labs em 1952 e entendia exatamente dez palavras: os dígitos de zero a nove.

Audrey, o reconhecedor automático de dígitos

K. H. Davis, R. Biddulph e S. Balashek construíram a Audrey com circuitos analógicos que ocupavam um rack de relés de quase dois metros. Uma pessoa dizia um dígito ao fone de um telefone, a máquina media os formantes das vogais e uma lâmpada acendia ao lado do dígito ouvido. Ajustada às vozes dos próprios projetistas, acertava de 97 a 99 por cento; com estranhos, desmoronava. A Audrey nunca saiu do laboratório, porque um operador humano discando números saía mais barato, mas encerrou a dúvida sobre se uma máquina era sequer capaz de ouvir.

O Shoebox da IBM e os anos 1960

Em 1962, a IBM apresentou o Shoebox na Feira Mundial de Seattle. Ele reconhecia 16 palavras faladas, os dez dígitos e seis comandos aritméticos, e com elas operava uma máquina de somar. Laboratórios nos Estados Unidos, no Reino Unido, no Japão e na União Soviética construíram reconhecedores de vogais e de pequenas listas de palavras, e em 1968 Taras Vintsyuk descreveu o alinhamento temporal dinâmico (dynamic time warping), que permitia a uma máquina comparar falas ditas em velocidades diferentes. Em 1969, a área tinha ambição mas nenhuma teoria, e John Pierce, da Bell Labs, a comparou a projetos para transformar água em gasolina.

O programa Speech Understanding Research da DARPA levou os vocabulários além de 1.000 palavras

Entre 1971 e 1976, a DARPA financiou o maior esforço de reconhecimento de fala até então, e o Harpy, da Carnegie Mellon, alcançou a meta de 1.000 palavras.

A meta de cinco anos

O programa Speech Understanding Research pedia um sistema capaz de entender fala contínua de vários locutores, com um vocabulário de 1.000 palavras e menos de 10 por cento de erro, e financiou a Carnegie Mellon, a BBN, o SRI e outros para competir. O Harpy, concluído na Carnegie Mellon em 1976, entendia 1.011 palavras, mais ou menos o vocabulário de uma criança de três anos, e foi o único sistema a atingir a meta. O segredo era uma busca que descartava cedo as sequências de palavras improváveis em vez de pesar todas as possibilidades, uma ideia que continua no centro de todo decodificador.

A virada estatística

Os mesmos anos produziram a ideia que venceu todas as outras pelos 40 anos seguintes. Na Carnegie Mellon, a tese de James Baker, de 1975, descrevia o sistema DRAGON, que tratava a fala como um modelo oculto de Markov e deixava que as probabilidades, e não regras escritas à mão, decidissem quais palavras haviam sido ditas. Na IBM, o grupo de Fred Jelinek incorporou a mesma abordagem a um sistema de ditado experimental e acrescentou modelos de linguagem n-gram, para que o reconhecedor pudesse adivinhar a próxima palavra a partir das duas anteriores. A Bell Labs, enquanto isso, passou de uma voz para muitas e construiu reconhecedores que funcionavam com vários locutores, exigência das aplicações telefônicas.

Os modelos ocultos de Markov tornaram o reconhecimento de fala estatístico nos anos 1980

Os anos 1980 trocaram a comparação de padrões pela probabilidade, e os vocabulários passaram de algumas centenas de palavras para 20.000 em uma década.

Como um modelo oculto de Markov ouve

Um modelo oculto de Markov não tenta encaixar um som em um molde. Ele pergunta qual sequência de sons da fala mais provavelmente produziu o áudio recebido e, depois, qual sequência de palavras mais provavelmente produziu esses sons. O treinamento com fala gravada define as probabilidades, então mais dados significam um reconhecedor melhor, uma propriedade que passaria a importar enormemente quando a internet chegasse. Combinado com modelos de linguagem n-gram, o HMM virou a arquitetura padrão de todo laboratório de pesquisa e ali ficou até o aprendizado profundo o destronar em 2012.

Tangora, Sphinx e os primeiros produtos

O Tangora, da IBM, reconhecia um vocabulário de 20.000 palavras em meados dos anos 1980, embora exigisse pausa entre as palavras e treinamento para cada locutor. Em 1988, o sistema Sphinx, de Kai-Fu Lee, na Carnegie Mellon, foi o primeiro a reunir vocabulário grande, fala contínua e independência de locutor em um só reconhecedor. A Dragon Systems, fundada por James e Janet Baker em 1982, começou a vender software de reconhecimento para computadores pessoais. O reconhecimento de voz também chegou ao consumidor pela primeira vez: a boneca Julie, da Worlds of Wonder, respondia a um punhado de frases faladas em 1987, e as companhias telefônicas testaram a discagem por voz. Os brinquedos eram toscos, mas levaram a expressão "reconhecimento de voz" para dentro das casas comuns.

Os anos 1990 levaram o reconhecimento de fala aos computadores pessoais

Processadores mais rápidos transformaram o ditado de demonstração de laboratório em software de prateleira, e um benchmark compartilhado tornou o progresso fácil de medir.

Do Dragon Dictate ao NaturallySpeaking

O Dragon Dictate chegou às lojas em 1990 por cerca de US$ 9.000. Foi o primeiro produto de reconhecimento de fala que uma pessoa comum podia comprar, e exigia uma pausa depois de cada palavra. Em 1997, o Dragon NaturallySpeaking eliminou a pausa: reconhecia fala contínua a cerca de 100 palavras por minuto em um PC doméstico, e a IBM respondeu com o ViaVoice no mesmo ano. Pela primeira vez um advogado, um médico ou um escritor podia falar com o computador e obter um texto utilizável, desde que treinasse o programa e corrigisse o resultado.

Atendimento eletrônico e os primeiros benchmarks

Em 1996, a BellSouth lançou o VAL, um portal de voz por discagem que respondia a perguntas faladas, e todo atendimento eletrônico com o qual você já brigou desde então descende dele. Nos bastidores, a DARPA e o NIST, o instituto de padrões dos Estados Unidos, conduziam avaliações anuais com gravações compartilhadas, como o corpus telefônico Switchboard, e a taxa de erro de palavras virou o número que todo laboratório reportava. Daí em diante, a história do reconhecimento de fala é, em grande parte, a história desse número caindo.

Os anos 2000 levaram o reconhecimento de fala para a nuvem

A precisão ficou estagnada perto de 80 por cento durante a maior parte da década, até o Google tirar o reconhecimento do aparelho e levá-lo para seus servidores.

O platô

Em 2001, os melhores sistemas transcreviam fala ditada com cerca de 80 por cento de precisão, e os anos seguintes trouxeram refinamentos, não saltos. O ditado no desktop continuou um nicho, o atendimento eletrônico continuou irritante e o financiamento de pesquisa minguou. O modelo oculto de Markov estava perto do teto, e os modelos que o substituiriam ainda não tinham o poder computacional nem os dados de que precisavam.

Google Voice Search

O serviço de informações telefônicas GOOG-411, do Google, lançado em 2007, reuniu milhões de consultas faladas. Em novembro de 2008, o Google Voice Search chegou como aplicativo para iPhone, e o reconhecimento mudou de forma: o celular só gravava, e o reconhecimento rodava nos data centers do Google, em modelos muito maiores do que qualquer aparelho comportaria, treinados com 230 bilhões de palavras de consultas de busca. O reconhecimento deixou de ser um programa e virou um serviço, a forma que tem até hoje.

Cronologia

A história do reconhecimento de fala,
ano a ano

Todos os eventos abaixo têm data. As seções em torno desta tabela explicam por que cada um foi importante.

AnoMarcoPor que importou
1952A Bell Labs constrói a AudreyA primeira máquina a reconhecer fala: os dígitos de 0 a 9 de um único locutor
1962A IBM demonstra o Shoebox16 palavras, mostradas ao público na Feira Mundial de Seattle
1971A DARPA inicia o programa Speech Understanding ResearchCinco anos de financiamento e uma meta de 1.000 palavras
1976O Harpy, da Carnegie Mellon, bate a meta1.011 palavras, com uma busca podada que os decodificadores ainda usam
1986O Tangora, da IBM, chega a 20.000 palavrasModelos ocultos de Markov e modelos de linguagem n-gram viram o padrão
1988Sphinx na Carnegie MellonReconhecimento contínuo, independente de locutor e de vocabulário amplo em um só sistema
1990O Dragon Dictate é lançadoO primeiro produto de reconhecimento de fala vendido ao consumidor
1997Dragon NaturallySpeaking e IBM ViaVoiceDitado contínuo em um PC doméstico a cerca de 100 palavras por minuto
2008Google Voice SearchO reconhecimento vai para a nuvem e aprende com cada consulta
2011A Apple lança a SiriUm assistente de voz em um celular popular
2012Redes neurais profundas substituem as misturas de gaussianasAs taxas de erro caem até um terço de uma só vez
2016A Microsoft reporta 5,9% no SwitchboardA primeira alegação de paridade humana em um benchmark de conversação
2017Microsoft 5,1%, IBM 5,5%, Google 4,9%; o Transformer é publicadoA corrida pela paridade termina e a próxima arquitetura chega
2020wav2vec 2.0 e o ConformerO aprendizado autossupervisionado reduz a necessidade de dados rotulados
2022A OpenAI lança o Whisper680.000 horas de treinamento, quase 100 idiomas, pesos abertos

O aprendizado profundo cortou as taxas de erro em mais da metade nos anos 2010

Entre 2011 e 2017, a taxa de erro de palavras em conversas telefônicas caiu de pouco mais de 10 por cento para cerca de 5 por cento, e os assistentes de voz entraram nas casas.

A Siri e os assistentes

A Apple lançou a Siri com o iPhone 4S em outubro de 2011, a Amazon veio em seguida com a Alexa no Echo em 2014, e o Google com o Google Home em 2016. Os assistentes importaram menos pelo reconhecimento, que rodava na nuvem quase como no Google Voice Search, do que pelo hábito que criaram: centenas de milhões de pessoas passaram a conversar com máquinas todos os dias, e cada frase dita virou dado de treinamento.

O salto das redes neurais

Em 2012, pesquisadores da Microsoft, do Google, da IBM e da Universidade de Toronto, Geoffrey Hinton entre eles, publicaram um artigo conjunto mostrando que redes neurais profundas treinadas no lado acústico do problema reduziam as taxas de erro em até um terço em comparação com os modelos de mistura de gaussianas que os sistemas HMM usavam havia 25 anos. O Deep Speech, da Baidu, foi além em 2014 e treinou uma única rede recorrente de ponta a ponta, do áudio aos caracteres, sem dicionário de pronúncia e sem pipeline montado à mão. O reconhecimento virou um problema de aprendizado profundo, e os laboratórios com mais GPUs e mais dados dispararam na frente.

A corrida pela paridade humana

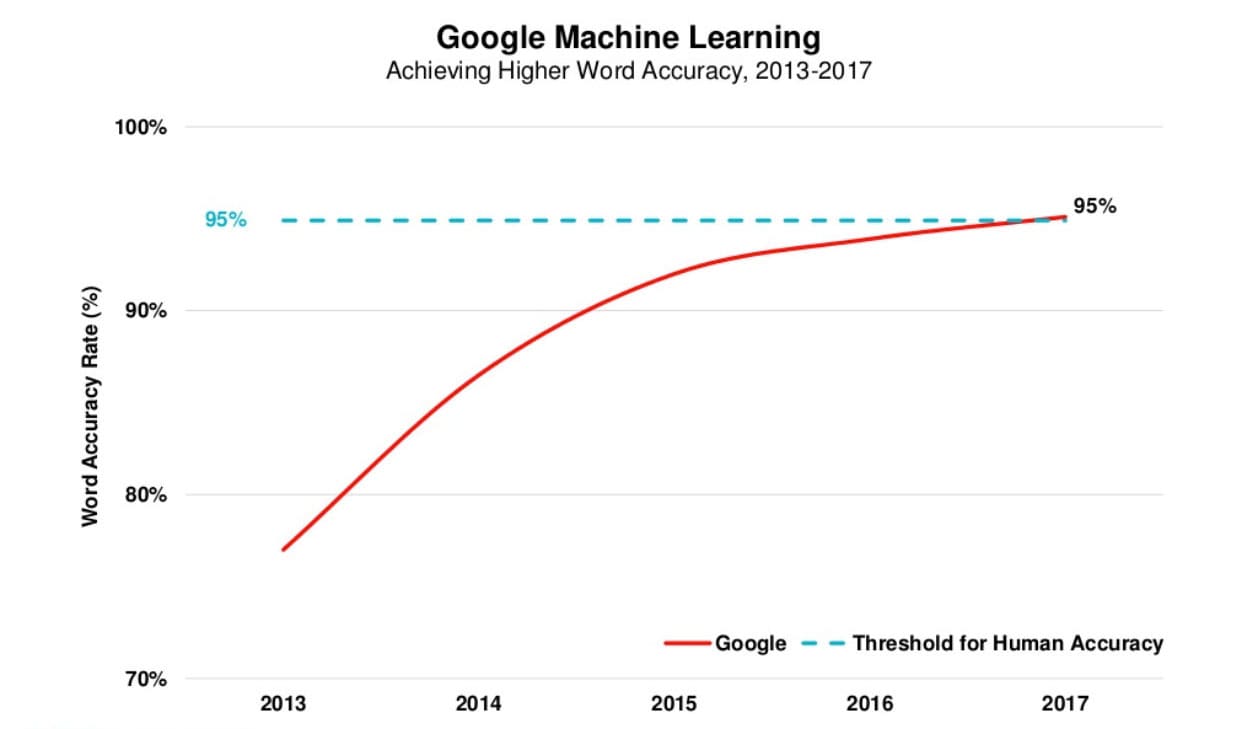
O benchmark Switchboard, um conjunto de conversas telefônicas gravadas, virou o placar. Em outubro de 2016, a Microsoft reportou 5,9 por cento de taxa de erro de palavras, o mesmo índice dos transcritores profissionais que contratou para trabalhar nas mesmas ligações, e chamou isso de paridade humana. A IBM respondeu com 5,5 por cento em março de 2017, o Google anunciou 4,9 por cento em seus próprios conjuntos de teste em maio, e em agosto de 2017 a Microsoft chegou a 5,1 por cento contra uma referência humana mais cuidadosa. O gráfico abaixo, do relatório Internet Trends 2017 de Mary Meeker, mostra a precisão de palavras do Google ultrapassando a marca de 95 por cento. No mesmo ano, a arquitetura Transformer foi publicada, e em três anos ela havia tomado conta da fala também.

Gráfico da taxa de precisão de palavras do Google ultrapassando 95 por cento, do relatório Internet Trends 2017 de Mary Meeker

O Whisper e o Transformer transformaram a transcrição em commodity

O treinamento autossupervisionado e um modelo aberto transformaram a transcrição multilíngue precisa, antes um privilégio das big techs, em algo que qualquer produto pode oferecer.

Aprender com áudio não rotulado

O gargalo dos anos 2010 eram os dados rotulados: cada hora de treinamento precisava de uma transcrição humana. Em 2020, o wav2vec 2.0, da Facebook AI, aprendeu representações da fala primeiro a partir de áudio bruto, sem transcrição, e precisou de apenas dez minutos de fala rotulada para fazer o ajuste fino de um reconhecedor utilizável. O Conformer, do Google, publicado no mesmo ano, combinou convolução com a atenção do Transformer e estabeleceu novos recordes nos benchmarks padrão. Juntos, eles fizeram do Transformer a arquitetura padrão para fala e reduziram o custo de acrescentar um novo idioma.

Whisper

Em setembro de 2022, a OpenAI lançou o Whisper, treinado com 680.000 horas de áudio coletadas da web, cobrindo quase 100 idiomas, com os pesos do modelo publicados para quem quisesse rodá-lo. Não era o sistema mais preciso em todos os benchmarks, mas era robusto a sotaques, ruído de fundo e vocabulário técnico de um jeito que os modelos acadêmicos anteriores não eram, e era gratuito. Em poucos meses estava dentro de milhares de produtos, e a pergunta para as empresas de transcrição deixou de ser se conseguiam reconhecer a fala e passou a ser o que construíam em torno da transcrição.

A identificação automática de idioma tem história própria

Saber qual idioma está sendo falado é um problema diferente de saber quais palavras foram ditas, e levou seus próprios 50 anos para ser resolvido.

Da estatística de fonemas aos i-vectors

Os primeiros experimentos de identificação de idioma, nos anos 1970, distinguiam as línguas pela estatística dos seus sons. Nos anos 1990, isso virou a abordagem fonotática: rodar um reconhecedor de fonemas e depois verificar de qual idioma os padrões de fonemas mais se aproximam. Em 1996, o NIST começou as avaliações formais de reconhecimento de idioma (Language Recognition Evaluations). Nos anos 2010, o i-vector, um resumo compacto de uma gravação emprestado do reconhecimento de locutor, gerou sistemas capazes de identificar um idioma a partir de poucos segundos de áudio.

Embutida no modelo

Os reconhecedores multilíngues modernos fundem os dois problemas. O Whisper e seus sucessores preveem o idioma como o primeiro token da transcrição, de modo que a identificação é um subproduto do reconhecimento, e não uma etapa separada. É isso que permite a um único produto lidar com 54+ idiomas sem um reconhecedor separado para cada um, e é por isso que o idioma que você fala deixou de ser um limite para o que você pode transcrever.

Onde o ASR está hoje

Em áudio limpo e bem gravado, o ASR moderno é praticamente um problema resolvido. Os motores agora se diferenciam no áudio difícil e no que fazem depois que a transcrição existe.

As pontuações de benchmark dos motores sérios convergiram, então a pergunta para um fornecedor já não é "qual é a sua precisão?", e sim como ele lida com o seu áudio e o que faz com a transcrição. O Sonix é um exemplo real de ASR em produção em 2026:

Precisão medida com honestidade

O Sonix atinge 99% de precisão em áudio limpo e de alta qualidade e devolve uma gravação de uma hora em cerca de 5 a 6 minutos com a transcrição automática. Todo número de precisão, inclusive o nosso, depende do áudio, então o único benchmark que importa é um teste com as suas próprias gravações.

Idiomas

O Sonix transcreve e traduz em 54+ idiomas. Os modelos da era Whisper tornaram a ampla cobertura de idiomas algo padrão, e não uma exceção, e a precisão em cada idioma acompanha a quantidade de áudio de treinamento disponível para ele.

Tempo real

A transcrição em tempo real exibe legendas em menos de 2 segundos enquanto as pessoas ainda estão falando, um ganho direto da arquitetura ponta a ponta.

Quem disse o quê

Os motores agora separam os locutores automaticamente, uma tarefa chamada diarização de locutores; nosso guia de diarização de locutores explica como ela funciona e onde ainda tropeça.

Além da transcrição

Resumos, capítulos e tradução transformam o texto bruto em algo com que você pode trabalhar. O ASR virou a primeira etapa de uma cadeia de compreensão, e não mais o produto final, e os seus primeiros 30 minutos no Sonix são gratuitos para você ver isso no seu próprio áudio.

Para onde o ASR vai: áudio difícil, privacidade e compreensão

A corrida dos benchmarks acabou, e os problemas que restam são os menos glamorosos: áudio difícil, implantação privada e transformar palavras em compreensão.

Os casos difíceis

Falas sobrepostas, microfones distantes, sotaques fortes, troca de idioma no meio da frase e vocabulário especializado ainda derrubam o desempenho de qualquer motor, inclusive o nosso. Os modelos ponta a ponta também trouxeram um novo tipo de falha: às vezes eles alucinam um texto fluente durante silêncio ou ruído, um problema de pesquisa em aberto, ainda sem solução.

No próprio aparelho

A tendência é que mais reconhecimento rode em celulares, notebooks e fones de ouvido em vez da nuvem, por privacidade e por velocidade. O mesmo trabalho de compressão que encolheu os modelos da classe do Whisper está levando reconhecimento preciso a aparelhos que nunca enviam o áudio para lugar nenhum.

Da transcrição à compreensão

Os grandes modelos de linguagem já resumem reuniões, respondem a perguntas sobre uma entrevista e redigem o encaminhamento de uma aula, e só fazem isso bem porque a transcrição por baixo é precisa. A voz segue crescendo como interface; a promessa de que ela vai substituir todas as telas é repetida desde os anos 1990, e para nós já basta que ela registre com confiança o que as pessoas realmente disseram.

Perguntas frequentes

ASR e reconhecimento de fala,
as dúvidas respondidas

O que significa ASR?

ASR é a sigla em inglês para reconhecimento automático de fala, a tecnologia que converte a linguagem falada em texto escrito. Você também vai encontrar a expansão automated speech recognition; as duas significam a mesma coisa. Em transcrição, ASR, reconhecimento de fala e conversão de fala em texto são usados como sinônimos.

ASR é o mesmo que fala em texto ou reconhecimento de voz?

ASR e conversão de fala em texto são a mesma coisa: ASR é o termo técnico, e fala em texto descreve o resultado. O reconhecimento de voz é diferente. Ele identifica quem está falando pelas características da voz, que é como um celular desbloqueia para o dono, enquanto o ASR transcreve o que qualquer pessoa disse.

Qual é a diferença entre ASR e PLN?

O ASR converte o áudio da fala em texto; o PLN (processamento de linguagem natural) interpreta o que o texto significa. Eles trabalham em sequência: quando você faz uma pergunta a um assistente de voz, o ASR transcreve as suas palavras e depois o PLN descobre a intenção e a resposta. No Sonix, o ASR produz a transcrição e os recursos baseados em PLN a resumem e analisam.

Qual é a precisão do ASR?

Em gravações de conversa com áudio limpo, os melhores sistemas igualam transcritores profissionais: a Microsoft mediu uma taxa de erro de palavras de 5,1% no benchmark Switchboard em 2017, e os modelos melhoraram desde então. O Sonix atinge 99% de precisão em áudio de boa qualidade. Ruído de fundo, microfones distantes, sotaques fortes e falas sobrepostas ainda elevam a taxa de erro, então faça o teste com as suas próprias gravações.

Quando e onde o reconhecimento de fala foi inventado?

Em 1952. O sistema Audrey, da Bell Labs, construído por K. H. Davis, R. Biddulph e S. Balashek, reconhecia os dígitos de 0 a 9 falados por uma única pessoa. O Shoebox, da IBM, veio em 1962 com 16 palavras, e o primeiro produto que se podia comprar, o Dragon Dictate, chegou em 1990.

Quem inventou o reconhecimento de fala?

Nenhuma pessoa sozinha. Três engenheiros da Bell Labs construíram o primeiro reconhecedor, o Audrey, em 1952. James Baker e Fred Jelinek tornaram o reconhecimento estatístico com os modelos ocultos de Markov nos anos 1970, o Sphinx de Kai-Fu Lee o tornou contínuo e independente do locutor em 1988, e colaboradores de Geoffrey Hinton levaram o aprendizado profundo para a área em 2012.

Qual foi o primeiro software de reconhecimento de fala?

O Dragon Dictate, lançado pela Dragon Systems em 1990 por cerca de US$ 9.000, foi o primeiro software de reconhecimento de fala vendido ao público. Ele exigia uma pausa entre as palavras. O Dragon NaturallySpeaking, lançado em 1997, foi o primeiro software de ditado com fala contínua a se popularizar nos computadores domésticos.

O ASR transcreve outros idiomas além do inglês?

Sim. Os dados de treinamento multilíngues tornaram a ampla cobertura algo padrão, e os sistemas modernos lidam com dezenas de idiomas. O Sonix transcreve e traduz em 54+ idiomas, incluindo espanhol, francês, alemão, mandarim, japonês e árabe. A precisão varia de idioma para idioma e acompanha a quantidade de áudio de treinamento disponível para cada um.

Comece agora

Experimente o Sonix gratuitamente

O Sonix transcreve, gera carimbos de data/hora e organiza seus arquivos de áudio e vídeo para que você possa pesquisar, editar e compartilhar sua mídia.

Inclui 30 minutes minutos de transcrição gratuita

Continue lendo

99% de precisão. Cada palavra importa.

Transcrição e tradução por IA em 54+ idiomas.

30 minutes grátis
Sem cartão de crédito
Cancele a qualquer momento