 Stephen Hopkins
Hvad er ASR?
Automatisk talegenkendelse (ASR) er teknologien, der omsætter talt sprog til skrevet tekst. Et ASR-system tager et lydsignal, analyserer lydene i det og beregner den mest sandsynlige rækkefølge af ord. Teknologien ligger bag transskriptionssoftware, stemmeassistenter, liveundertekster, dikteringsværktøjer og stemmesøgning.
ASR står for automatic speech recognition, på dansk automatisk talegenkendelse. Nogle leverandører kalder det automated speech recognition, men det dækker over det samme. Har du kun to minutter, så læs vores ASR-introduktion. Denne guide går et lag dybere, fra selve motoren til de 70 års forskning bag den.
Begrebet bliver ofte blandet sammen med tre beslægtede begreber, og de svarer hver især på et andet spørgsmål:
- ASR (automatisk talegenkendelse) omsætter tale til tekst og svarer på "hvad blev der sagt?"
- Tale-til-tekst er den samme teknologi under produktnavnet og svarer også på "hvad blev der sagt?"
- Stemmegenkendelse (talergenkendelse) identificerer eller bekræfter, hvem der taler, og svarer på "hvem sagde det?"
- NLP (naturlig sprogbehandling) fortolker, hvad en tekst betyder, og svarer på "hvad betyder det?"
I praksis er ASR og tale-til-tekst to navne for det samme: ASR er ingeniørernes begreb, tale-til-tekst er produktbetegnelsen. Det er stemmegenkendelse, folk oftest forveksler det med. Stemmegenkendelse genkender en bestemt person, som når en telefon kun låser op for sin ejer, mens ASR transskriberer alles ord uden at interessere sig for, hvem der sagde dem. NLP kommer bagefter: Først bliver lyden til tekst, og derefter kan NLP opsummere teksten, besvare et spørgsmål om den eller handle på den.
Hvordan virker ASR?
Moderne ASR er ét neuralt netværk, der går direkte fra lyd til tekst. Men i det meste af sin historie var det en kæde af fem separate modeller.
Den klassiske kæde, som historien nedenfor bygger op stykke for stykke, ser sådan ud:
- Optagelse og forbehandling. Lyden bliver digitaliseret, renset og skåret op i korte rammer, typisk et par snese millisekunder lange.
- Udtræk af kendetegn. Hver ramme bliver til en kompakt talbeskrivelse af energien ved forskellige frekvenser.
- Akustisk model. Modellen kobler kendetegnene til fonemer, et sprogs mindste lydenheder, og vurderer, hvilke lyde der sandsynligvis blev sagt.
- Sprogmodel. Modellen ved, hvilke ordfølger der er sandsynlige. Derfor skriver en motor "recognize speech" og ikke "wreck a nice beach": Begge passer til lyden, men kun den ene giver mening i sproget.
- Dekoder. Dekoderen gennemsøger de samlede sandsynligheder fra den akustiske model og sprogmodellen og leverer den mest sandsynlige sætning.
Skiftet til end-to-end
Siden midten af 2010'erne har end-to-end-modeller baseret på deep learning, de fleste i dag bygget på Transformer-arkitekturen, lært at gå direkte fra rå lyd til tekst. De trænes på hundredtusindvis af timers tale. Der er ingen håndbygget udtaleordbog og ingen separat akustisk model, for netværket lærer det hele på én gang. Det skift er hovedårsagen til, at transskriptionsnøjagtigheden blev mere forbedret i 2010'erne end i de fire årtier før.
Fordi modellerne lærer af lyd i enorm skala, klarer de accenter, baggrundsstøj og naturlig samtale langt bedre end de gamle kædesystemer. De sætter også tegn og store bogstaver i samme omgang, så en moderne transskription kan læses som et færdigt dokument.
Sådan måles ASR-nøjagtighed
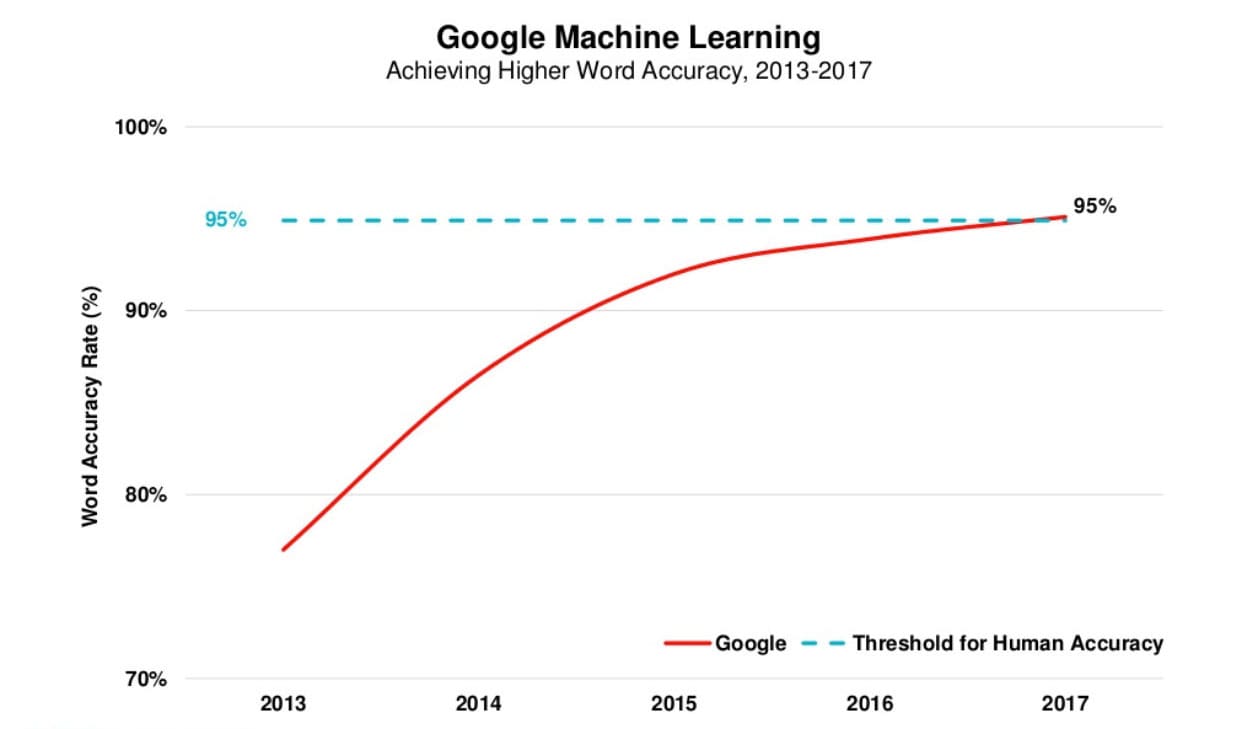
Standardmålet er word error rate (WER, ordfejlrate): Maskinens transskription sammenlignes med en omhyggelig manuel transskription, og hvert ombyttet, udeladt og indsat ord tæller som en fejl. En WER på 5% betyder cirka én fejl for hver 20 ord, altså 95% nøjagtighed. WER afhænger helt af testlyden, og derfor kan to leverandørers tal sjældent sammenlignes. Vores guide forklarer formlen og har en indbygget beregner.
Talegenkendelse i korte træk
- Opfundet
- Talegenkendelse blev opfundet i 1952, da Bell Labs' Audrey-system genkendte cifrene 0 til 9, udtalt af en enkelt stemme.
- Første forbrugersoftware
- Dragon Dictate, der udkom i 1990 til omkring 9.000 dollars, var det første talegenkendelsesprodukt, der blev solgt til offentligheden, og det krævede en pause efter hvert ord.
- Første ordforråd på 1.000 ord
- Carnegie Mellons Harpy forstod 1.011 ord i 1976, det mål DARPA havde sat for sit femårige Speech Understanding Research-program.
- Menneskeniveau
- I 2017 målte Microsoft en ordfejlrate (WER) på 5,1 % på telefonbenchmarken Switchboard, på højde med de professionelle transskribenter, der arbejdede med de samme opkald.
- Åbne modeller
- OpenAI's Whisper, der udkom i september 2022, blev trænet på 680.000 timers lyd og transskriberer næsten 100 sprog med offentliggjorte vægte.
- I dag
- Sonix blev grundlagt i 2017, transskriberer 54+ sprog med 99% nøjagtighed og leverer en times optagelse på omkring 5 til 6 minutter.
Talegenkendelsens historie begynder hos Bell Labs i 1952
Det første talegenkendelsessystem blev bygget hos Bell Labs i 1952, og det forstod præcis ti ord: cifrene fra nul til ni.
Audrey, den automatiske cifergenkender
K. H. Davis, R. Biddulph og S. Balashek byggede Audrey af analoge kredsløb, der fyldte et relæstativ på knap to meter. En taler sagde et ciffer ind i et telefonrør, maskinen målte vokalernes formanter, og en lampe lyste op ved siden af det ciffer, den hørte. Indstillet efter konstruktørernes egne stemmer ramte den rigtigt i 97 til 99 procent af tilfældene; med fremmede stemmer faldt den fra hinanden. Audrey forlod aldrig laboratoriet, fordi en telefonist, der tastede numrene ind, var billigere, men den afgjorde spørgsmålet om, hvorvidt en maskine overhovedet kunne høre.
IBM's Shoebox og 1960'erne
I 1962 viste IBM maskinen Shoebox frem på verdensudstillingen i Seattle. Den genkendte 16 talte ord, de ti cifre og seks regnekommandoer, og brugte dem til at styre en regnemaskine. Laboratorier i USA, Storbritannien, Japan og Sovjetunionen byggede systemer, der kunne genkende vokaler og korte ordlister, og i 1968 beskrev Taras Vintsyuk dynamic time warping, en metode der lod en maskine sammenligne tale udtalt i forskelligt tempo. I 1969 havde feltet store ambitioner, men ingen teori, og John Pierce fra Bell Labs sammenlignede det med planer om at lave vand om til benzin.
DARPA's Speech Understanding Research-program bragte ordforrådet over 1.000 ord
Fra 1971 til 1976 finansierede DARPA den hidtil største satsning på talegenkendelse, og Carnegie Mellons Harpy nåede målet på 1.000 ord.
Det femårige mål
Programmet Speech Understanding Research efterlyste et system, der kunne forstå sammenhængende tale fra flere talere med et ordforråd på 1.000 ord og under 10 procent fejl, og det betalte Carnegie Mellon, BBN, SRI og andre for at konkurrere. Harpy, der stod færdig på Carnegie Mellon i 1976, forstod 1.011 ord, omtrent ordforrådet hos en treårig, og var det eneste system, der nåede målet. Tricket var en søgning, der tidligt sorterede usandsynlige ordfølger fra i stedet for at veje alle muligheder. Den idé er stadig kernen i enhver dekoder.
Den statistiske vending
De samme år fostrede den idé, der slog alt andet af banen de næste 40 år. På Carnegie Mellon beskrev James Bakers afhandling fra 1975 DRAGON-systemet, som behandlede tale som en skjult Markov-model og lod sandsynligheder, ikke håndskrevne regler, afgøre, hvilke ord der var blevet sagt. Hos IBM byggede Fred Jelineks gruppe samme tilgang ind i et dikteringssystem til forskningsbrug og tilføjede n-gram-sprogmodeller, så systemet kunne gætte det næste ord ud fra de to foregående. Bell Labs gik i mellemtiden fra én stemme til mange og byggede systemer, der virkede på tværs af talere, hvilket telefonanvendelser krævede.
Skjulte Markov-modeller gjorde talegenkendelse statistisk i 1980'erne
I 1980'erne blev mønstersammenligning afløst af sandsynlighedsregning, og ordforrådet voksede fra nogle få hundrede ord til 20.000 på et årti.
Sådan hører en skjult Markov-model
En skjult Markov-model forsøger ikke at matche en lyd med en skabelon. Den spørger, hvilken sekvens af talelyde der mest sandsynligt frembragte den lyd, den modtog, og dernæst hvilken sekvens af ord der mest sandsynligt frembragte de lyde. Træning på optaget tale fastlægger sandsynlighederne, så flere data giver et bedre system, en egenskab, der skulle vise sig at betyde enormt meget, da internettet kom. Kombineret med n-gram-sprogmodeller blev HMM'en standardarkitekturen i alle forskningslaboratorier og blev der, indtil deep learning fortrængte den i 2012.
Tangora, Sphinx og de første produkter
IBM's Tangora genkendte et ordforråd på 20.000 ord i midten af 1980'erne, men krævede en pause mellem ordene og træning på hver enkelt taler. I 1988 blev Kai-Fu Lees Sphinx-system på Carnegie Mellon det første, der kombinerede et stort ordforråd, sammenhængende tale og taleruafhængighed i ét system. Dragon Systems, grundlagt af James og Janet Baker i 1982, begyndte at sælge genkendelsessoftware til personlige computere. Stemmegenkendelse nåede også ud til forbrugerne for første gang: Worlds of Wonders Julie-dukke svarede på en håndfuld talte sætninger i 1987, og telefonselskaberne afprøvede stemmestyret opkald. Legetøjet var primitivt, men det bragte udtrykket "stemmegenkendelse" ind i almindelige hjem.
I 1990'erne kom talegenkendelse ud på pc'en
Hurtigere processorer forvandlede diktering fra en laboratoriedemonstration til hyldevare, og en fælles benchmark gjorde fremskridt lette at måle.
Fra Dragon Dictate til NaturallySpeaking
Dragon Dictate kom på markedet i 1990 til omkring 9.000 dollars. Det var det første talegenkendelsesprodukt, en almindelig borger kunne købe, og det krævede en pause efter hvert ord. I 1997 fjernede Dragon NaturallySpeaking pausen: Det genkendte sammenhængende tale med omkring 100 ord i minuttet på en hjemme-pc, og IBM svarede igen med ViaVoice samme år. For første gang kunne en advokat, en læge eller en forfatter tale til en computer og få brugbar tekst ud af det, forudsat at de trænede og rettede den.
Telefonmenuer og de første benchmarks
I 1996 lancerede BellSouth VAL, en stemmeportal, man ringede op til, og som besvarede talte spørgsmål, og alle de automatiske telefonsystemer, du har skændtes med siden, nedstammer fra den. Bag kulisserne kørte DARPA og National Institute of Standards and Technology årlige evalueringer på fælles optagelser som telefonkorpusset Switchboard, og ordfejlraten (WER) blev det tal, alle laboratorier rapporterede. Fra da af er talegenkendelsens historie i høj grad historien om ét tal, der falder.
2000'erne flyttede talegenkendelse op i skyen
Nøjagtigheden gik i stå omkring 80 procent det meste af årtiet, indtil Google flyttede genkendelsen væk fra enheden og over på sine servere.
Plateauet
I 2001 transskriberede de bedste systemer dikteret tale med omkring 80 procent nøjagtighed, og de følgende år bød på finjusteringer snarere end spring. Diktering på skrivebordet forblev en niche, telefonmenuerne forblev frustrerende, og forskningsmidlerne svandt ind. Den skjulte Markov-model var tæt på sit loft, og de modeller, der skulle afløse den, havde endnu hverken regnekraften eller de data, de behøvede.
Google Voice Search
Googles nummeroplysning GOOG-411, der blev lanceret i 2007, indsamlede millioner af talte forespørgsler. I november 2008 kom Google Voice Search som iPhone-app, og talegenkendelse skiftede form: Telefonen optog kun, mens selve genkendelsen kørte i Googles datacentre på modeller, der var langt større, end nogen enhed kunne rumme, trænet på 230 milliarder ord fra søgeforespørgsler. Talegenkendelse blev en tjeneste frem for et program, og sådan er det stadig.